
표집분포
시뮬레이션: 주사위 10개의 평균과 표집 오차
- 공정한 6면체 주사위 10개를 서로 독립적으로 굴려 나온 눈을 하나의 표본으로 사용
- 모평균은 3.5이며, 주사위 눈 10개의 평균이 표본평균
import numpy as np

rng = np.random.default_rng(2026)  # 실행 결과를 재현하기 위한 난수 시드
pop_mean = 3.5  # 공정한 6면체 주사위 눈의 모평균
sample = rng.integers(1, 7, size=10)  # 1 이상 7 미만의 정수 10개
sample  # 주사위 10개의 눈
실행 결과
array([6, 2, 1, 4, 3, 3, 1, 3, 4, 3])
sample_mean = sample.mean()
sample_mean  # 주사위 10개의 평균
실행 결과
np.float64(3.0)
sampling_error = sample_mean - pop_mean
sampling_error  # 표본평균과 모평균의 차이
실행 결과
np.float64(-0.5)
- 난수 시드를 바꾸거나 시드 설정을 제거하고 다시 실행하면 주사위 눈과 표본평균, 표집 오차가 달라질 수 있음
size를 키우면 한 표본에 포함하는 주사위 수가 증가. 표본 크기가 커질수록 큰 표집 오차가 발생할 가능성은 작아지는 경향
표집분포
- 표집분포(Sampling Distribution): 같은 모집단에서 같은 크기의 표본을 반복해서 뽑아 통계량을 계산했을 때, 그 통계량들이 이루는 분포
- 주사위 10개를 굴려 평균을 내는 과정을 500번 반복하면 표본평균 500개를 얻음
- 이 표본평균들의 분포로 표본평균의 표집분포를 근사
- 표집분포는 통계량이 표본에 따라 얼마나 달라지는지 보여 줌
- 주사위 예시에서 구분할 분포
- 모집단의 분포: 주사위 눈 1~6이 각각 같은 확률로 나오는 분포
- 표본의 분포: 한 번에 굴린 주사위 10개의 눈이 이루는 분포
- 표본평균의 표집분포: 주사위 10개의 평균을 반복해서 구했을 때 그 평균들이 이루는 분포
시뮬레이션: 평균 내기를 500번 반복
앞에서 만든 rng를 이어서 사용하여 주사위 10개를 새로 굴리고 평균을 구하는 과정을 500번 반복.
sample_means = []

for _ in range(500):  # 표본 크기 10을 유지하고 표집을 500번 반복
    sample = rng.integers(1, 7, size=10)
    sample_means.append(sample.mean())

len(sample_means)  # 저장한 표본평균의 개수
실행 결과
500
- 주사위 10개: 한 번의 표본 크기
- 반복 500번: 표본평균을 구한 횟수
- 반복 횟수를 늘리는 것은 한 표본의 크기를 늘리는 것과 다름
표본평균의 분포를 히스토그램으로 확인
import matplotlib.pyplot as plt
import seaborn as sns

sns.histplot(x=sample_means, bins=15)  # 표본평균 500개를 15개 구간으로 나누어 표시
plt.axvline(pop_mean, color="red", linestyle="--", label="Population mean = 3.5")
plt.xlabel("Mean of 10 dice")
plt.ylabel("Frequency")
plt.legend()
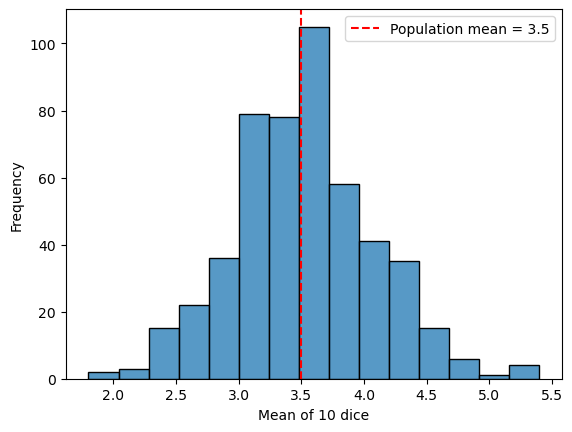
- 가로축: 주사위 10개의 평균
- 세로축: 각 구간에 속하는 표본평균의 개수. 전체 빈도의 합은 500
- 빨간 점선: 모평균 3.5
- 표본평균은 모평균 3.5 주변에 모이지만, 표본마다 달라 표집 오차가 발생
- 이 그림은 주사위 눈 5,000개 자체의 분포가 아니라, 10개씩 평균 낸 값 500개의 분포
퀴즈
시뮬레이션에서 난수 시드를 바꾸고 같은 크기의 표본을 다시 추출하면 예상되는 결과는?
퀴즈를 풀려면 대화형 기능을 불러와야 합니다.