
회귀분석
회귀분석의 개념
- 회귀분석(Regression Analysis): 독립변수(설명변수)와 종속변수(반응변수) 간의 관계를 수학적 모델로 추정하는 통계 기법
- 독립변수: 종속변수를 설명하거나 예측하는 데 사용하는 변수(X)
- 종속변수: 설명하거나 예측할 대상(Y)
- "회귀(Regression)"는 프랜시스 골턴이 부모와 자식의 키 관계를 연구하며 평균으로 회귀하는 현상을 관찰한 데서 유래
회귀분석의 주요 목적
- 예측(Prediction)
- 새로운 독립변수 값이 주어졌을 때 종속변수의 값을 수학적 모델로 추정
- 예: 선박의 길이(
length)로 무게(weight) 예측
- 설명(Explanation)
- 독립변수와 종속변수의 선형 관계를 크기와 방향으로 설명
- 예: 선박 길이가 1단위 증가할 때 예측 무게의 평균 변화량 설명
선형 모형
- 종속변수 Y와 독립변수 X의 관계를 직선 방정식으로 표현
- Y: 종속변수, 예: 무게
- X: 독립변수, 예: 길이
- β0: y절편(Intercept)
- β1: 기울기, 회귀계수(Regression Coefficient)
- ϵ: 오차항(Error term)
최소제곱법
- 잔차(Residual): 실제값과 예측값의 차이
- 최소제곱법(Ordinary Least Squares, OLS): 잔차 제곱합이 최소가 되도록 β0와 β1을 추정
y절편의 의미
- y절편(Intercept): 독립변수 X가 0일 때 종속변수 Y의 기댓값(β0)
- X=0이 데이터 범위를 벗어나면 해석이 무의미할 수 있음
- 예: 선박 길이가 0일 때 무게의 추정치는 물리적 의미가 없음
회귀계수의 해석
- 회귀계수(Regression Coefficient): 회귀선의 기울기(β1)
- 해석: X가 1단위 증가할 때 예측되는 Y의 평균 변화량
- β1>0: 양의 선형 관계, X 증가 시 Y 증가
- β1<0: 음의 선형 관계, X 증가 시 Y 감소
- β1≈0: 선형 관계가 거의 없음
단순 선형 회귀 모형
statsmodels: 회귀계수, p-value, 결정계수 등 통계 결과표 제공length를 설명변수로,weight를 반응변수로 활용하여 모델링
🤖 AI 프롬프트
ship.xlsx를 판다스로 읽어 df을 만들고, statsmodels로 length를 설명변수, weight를 반응변수로 하는 절편 포함 단순 선형 회귀를 적합해줘. model에 저장하고 회귀분석 요약표를 출력해줘.
from statsmodels.formula.api import ols
import pandas as pd

df = pd.read_excel("ship.xlsx")

# "종속변수 ~ 독립변수" 형태의 수식을 적용하고 적합(fit) 수행
model = ols("weight ~ length", data=df).fit()

model.summary()
실행 결과
                            OLS Regression Results
==============================================================================
Dep. Variable:                 weight   R-squared:                       0.397
Model:                            OLS   Adj. R-squared:                  0.391
Method:                 Least Squares   F-statistic:                     64.60
Date:                Sun, 18 Oct 2026   Prob (F-statistic):           2.11e-12
Time:                        14:35:53   Log-Likelihood:                -1048.1
No. Observations:                 100   AIC:                             2100.
Df Residuals:                      98   BIC:                             2105.
Df Model:                           1
Covariance Type:            nonrobust
==============================================================================
                 coef    std err          t      P>|t|      [0.025      0.975]
------------------------------------------------------------------------------
Intercept   1.112e+04   4812.422      2.310      0.023    1566.961    2.07e+04
length       150.0497     18.668      8.038      0.000     113.003     187.096
==============================================================================
Omnibus:                       15.641   Durbin-Watson:                   2.055
Prob(Omnibus):                  0.000   Jarque-Bera (JB):               18.409
Skew:                           1.046   Prob(JB):                     0.000101
Kurtosis:                       3.208   Cond. No.                     1.42e+03
==============================================================================

Notes:
[1] Standard Errors assume that the covariance matrix of the errors is correctly specified.
[2] The condition number is large, 1.42e+03. This might indicate that there are
strong multicollinearity or other numerical problems.
- 추정식: weight≈11120+150.05×length
length의 회귀계수:150.0497- 길이가 1단위 증가할 때 예측 무게가 평균 약 150 증가
회귀계수의 유의성 검정
- 추정된 회귀계수가 통계적으로 유의미한지 알아보기 위한 가설 검정
- 귀무가설(H0): 회귀계수 β1은 0이다
- 두 변수 사이에 선형 관계가 없음
- 대립가설(H1): 회귀계수 β1은 0이 아니다
- 두 변수 사이에 선형 관계가 있음
- p-value가 0.05보다 작으면 귀무가설 기각
- 유의한 회귀계수만으로 인과관계가 성립하지는 않음
- 앞의 결과에서
length의 p-value(P>|t|)는 2.11×10⁻¹²로 0.05보다 작으므로 β1=0이라는 귀무가설 기각
회귀계수 가설 검정 순서도
Mermaid 다이어그램 원문
flowchart TD
    A["가설 설정<br/>귀무가설: β = 0<br/>대립가설: β ≠ 0"] --> B{"p-value < 0.05"}
    B -- "예" --> C["β ≠ 0이라는 통계적 근거 있음"]
    B -- "아니오" --> D["β ≠ 0이라고 판단할 근거 부족"]
대화형 다이어그램을 불러오기 전에는 원문으로 표시됩니다.
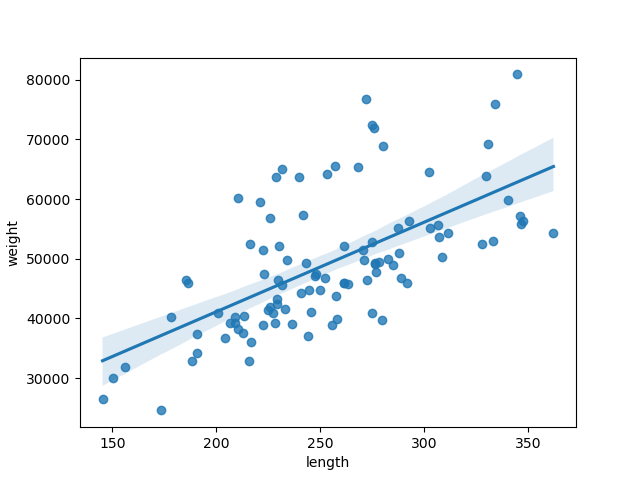
최적합 회귀선 시각화
seaborn의regplot은 산점도를 그리고 그 위에 추정된 회귀선과 신뢰구간 대역을 겹쳐서 표시
🤖 AI 프롬프트
seaborn으로 df의 length를 가로축, weight를 세로축으로 하는 산점도에 회귀선과 신뢰구간 대역을 함께 그려줘.
import seaborn as sns

# regplot으로 직관적인 선형 관계 관찰 및 시각화
sns.regplot(data=df, x="length", y="weight")
회귀분석을 이용한 예측
length변수를 가진 새로운 데이터 만들기
🤖 AI 프롬프트
new_ship.xlsx를 판다스로 읽어 df_new를 만들고, 앞에서 적합한 model로 각 선박의 weight를 예측해줘.
df_new = pd.read_excel("new_ship.xlsx")
- 적합된 모형에 새 데이터를 입력하여 예측
model.predict(df_new)
실행 결과
0    26122.023980
1    41126.991133
2    56131.958286
dtype: float64
예측값은 26122.02, 41126.99, 56131.96.
퀴즈
회귀분석의 기본 목적을 가장 잘 설명한 것은?
퀴즈를 풀려면 대화형 기능을 불러와야 합니다.