
신뢰구간
표집 오차
- 표집 오차(Sampling Error): 모집단 전체가 아닌 표본만 관찰하기 때문에 표본에서 계산한 통계량과 모집단의 모수 사이에 생기는 차이
- 표집 오차는 다음과 같이 나타낼 수 있음
표집 오차 = 통계량 - 모수- 예:
표본평균 - 모평균,표본비율 - 모비율
- 무작위로 표본을 추출하더라도 어떤 관측치가 뽑히느냐에 따라 통계량이 달라지므로 표집 오차가 발생함
- 표집 오차는 조사 실수나 표본 추출의 편향과는 다른 개념
표본 크기와 표집 오차
- 표본의 크기가 커질수록 통계량이 표본마다 달라지는 정도가 일반적으로 작아짐
- 따라서 큰 표본에서는 큰 표집 오차가 발생할 가능성이 작아지는 경향이 있음
- 다만 표본 크기를 키워도 표집 오차를 완전히 없앨 수는 없음
- 표본의 크기가 크더라도 추출 방법이 편향되어 있으면 모집단을 제대로 대표하지 못할 수 있음
표집 오차의 예시
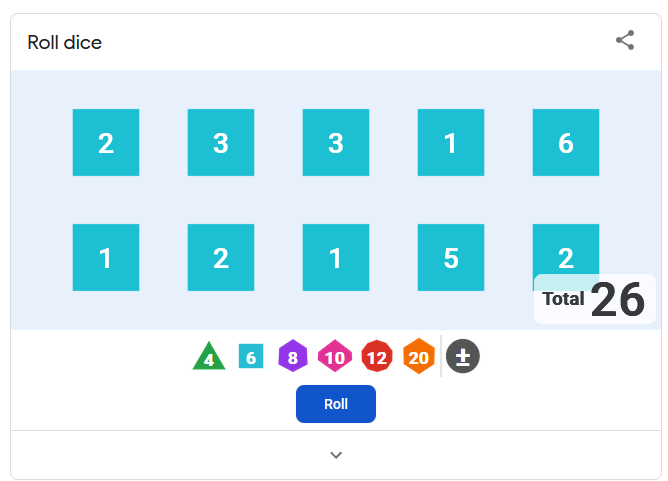
- 6면체 주사위 눈의 모집단 평균은 3.5
- 주사위를 10번 굴려 눈의 합이 26이었다면 표본평균은 2.6
- 이 표본평균의 표집 오차는 다음과 같음
- 음의 표집 오차는 표본에서 계산한 값이 모수보다 작게 나왔다는 뜻
신뢰구간
- 신뢰구간(confidence interval)은 대표적인 구간 추정 방법
- 하나의 점 추정값만 제시하지 않고, 표집의 불확실성을 반영한 범위를 제시함
- 기본 형태
- 신뢰구간 = 통계량 ± 오차범위
- 신뢰수준, 표본의 크기, 데이터의 변산성 등을 고려하여 오차범위를 이론적으로 유도해 사용
오차 범위
- 오차 범위(margin of error)는 표집 오차가 발생하는 범위
- 6면체 주사위의 경우 표집오차는 아무리 커도 ±2.5를 넘을 수 없음
- 오차범위에 영향을 주는 요소
- 신뢰수준: 얼마나 극단적인 경우까지 포함할 것인가
- 표본의 크기: 표본에 얼마나 많은 사례를 포함할 것인가
- 모집단의 변산성: 모집단의 변산성이 얼마나 큰가
신뢰수준
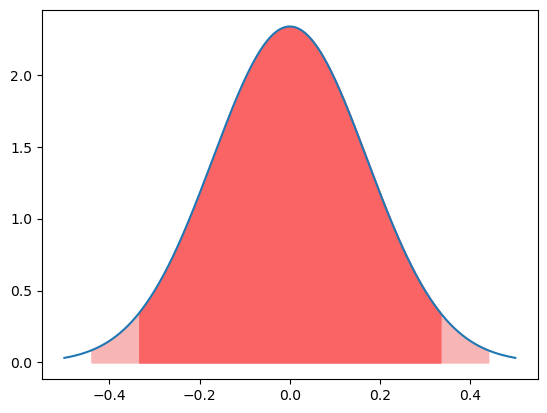
- 신뢰수준(confidence level)은 같은 방법으로 표집과 구간 추정을 반복했을 때 그 구간이 모수를 포함하는 비율
- 극단적인 경우까지 포함하면 오차범위는 커짐
- 예: 6면체 주사위를 굴렸을 때 모두 1이나 모두 6이 나오면 표집 오차가 최대
- 극단적인 경우를 배제하면 오차범위를 줄일 수 있음
- 유의수준(significance level)
- 배제하는 극단적인 경우의 비율
- 예: 유의수준 5% = 5%의 극단적인 경우는 배제함
- 신뢰수준 = 100% - 유의수준
- 신뢰수준과 오차범위
- 높은 신뢰수준 → 더 많은 가능성 → 넓은 오차범위
- 낮은 신뢰수준 → 더 적은 가능성 → 좁은 오차범위
- 95% 신뢰수준은 반복해서 만든 신뢰구간 중 약 95%가 모수를 포함한다는 뜻
- 한 번 계산한 구간에 모수가 들어 있을 확률이 95%라는 뜻은 아님
신뢰 수준 100%면 안되는 이유
- 신뢰수준을 100%로 잡으면 사실상 모든 가능한 극단적 경우를 포함해야 함
- 그러면 오차범위가 너무 넓어져 실질적인 의사결정에 도움이 되기 어려움
- 통계적 추정은 불확실성을 완전히 제거하는 것이 아니라, 합리적인 수준에서 관리하는 과정
신뢰 수준의 결정
- 신뢰수준은 적절한 수준에서 타협이 필요
- 신뢰수준이 지나치게 높으면 가능성이 희박한 극단적 경우를 너무 많이 고려하여 의사결정이 어려워짐
- 신뢰수준이 지나치게 낮으면 너무 많은 경우를 배제하여 의사결정의 타당성이 떨어짐
- 교과서적으로는 95%, 99% 등을 추천하지만 절대적 기준은 아님
데이터의 변산성
- 데이터의 변산성이 크면 오차범위가 커짐
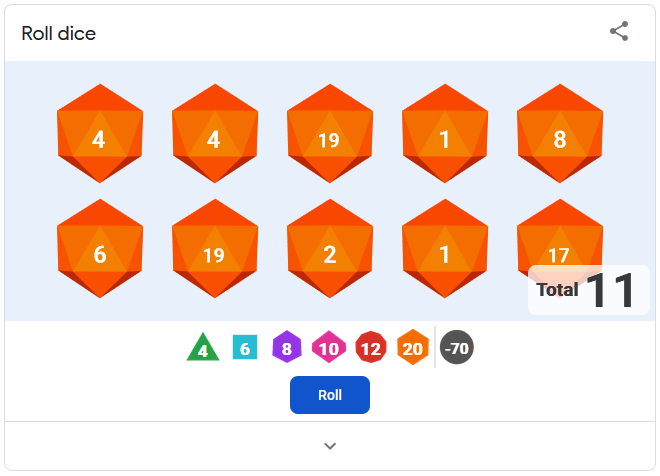
- 20면체 주사위를 굴리고 7을 빼면 기대값은 6면체 주사위와 똑같이 3.5
- 하지만 20면체 주사위는 가능한 값의 범위가 더 넓기 때문에 오차범위가 훨씬 큼
- 6면체 주사위를 10개 굴려서 모두 1이 나올 가능성은 매우 희박함
- 20면체 주사위를 10개 굴려서 7을 뺀 값이 모두 1 이하(굴린 눈이 모두 8 이하)가 나올 가능성은 그보다 훨씬 큼
- 실험과 측정을 정확히 해서 변산성을 낮추면 오차범위가 작아짐
- 데이터에 내재한 변산성은 없앨 수 없음
표본의 크기
- 표본의 크기가 크면 오차범위가 작아짐
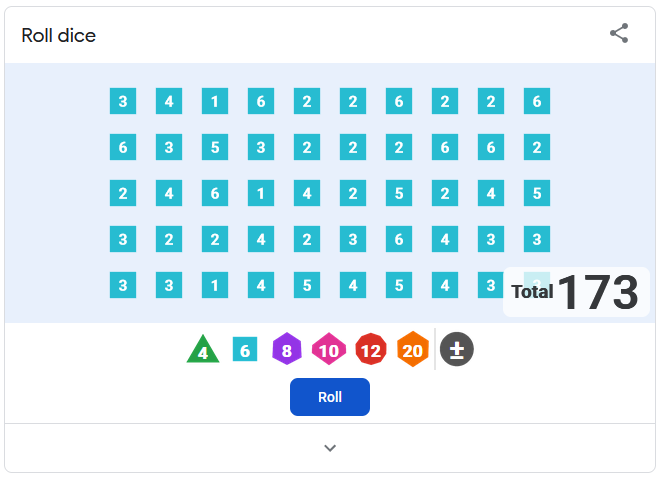
- 앞의 주사위 10개 굴리기(10d6)와 50개 굴리기(50d6)를 비교하면 표본 수가 많은 쪽의 평균이 기대값에 더 가까워지는 경향
- 던지는 횟수를 한없이 늘리면 평균은 3.5에 한없이 가까워지고 오차범위는 0에 가까워짐
- 통계에서 거의 모든 문제의 해결 방법은 데이터를 더 모아서 표본의 크기를 키우는 것
- 하지만 표본을 늘리면 시간과 비용도 증가함
퀴즈
표집 오차에 대한 설명으로 가장 적절한 것은?
퀴즈를 풀려면 대화형 기능을 불러와야 합니다.