
확률 분포
확률 변수
- 확률 변수 : 상태 공간의 원소를 실수에 대응시키는 함수
- 예: 실험용 쥐가 수컷과 암컷이 있을 때, 수컷이면 , 암컷이면
- 지지역(support): 확률변수 의 모든 값의 집합
- 예: 실험용 쥐의 성별의 지지역은
주요 확률 분포의 기초
- 확률 분포: 확률 변수가 특정한 값을 가질 확률을 나타내는 함수
- 세상에는 수많은 확률 분포가 존재
- 통계학의 근본 가정 중 하나
- 데이터는 어떤 확률 분포에서 비롯
- 데이터가 나온 확률 분포를 추론하는 것이 통계 분석
- 분석을 쉽게 하기 위해서 수학적으로 단순화, 추상화된 확률 분포들을 많이 사용
이산 확률 변수
- 이산 확률 변수: 표본공간의 원소를 정수에 대응시키는 함수
- 확률 질량 함수
- 가 상태 공간에 있을 경우, 의 확률
- 가 지지역에 속하지 않을 경우
- 누적분포함수(cumulative distribution function, CDF)
- 가 이하일 모든 경우의 확률
베르누이 분포
- 동전 던지기와 같이 둘 중에 한 가지 결과만 나올 수 있는 경우
- 동전을 던져 나온 결과가 앞면 = 1, 뒷면 = 0이라고 할 때
- 둘 중에 한 가지 결과가 나오는 현상에 모두 적용 가능
- 고객의 구매/미구매, 이탈/유지
- 기계의 작동/고장
- 시험의 합격/불합격
이항 분포
- 0과 1만 나오는 시행을 번 했을 때 합계의 분포
- 고객의 구매율이 30%일 때 100명의 고객이 방문하면 그 중에 몇 명이 구매?
- 베르누이 분포는 인 경우의 이항 분포
이항분포의 함수와 시뮬레이션
- 확률질량함수(probability mass function)
- 예: 정확히 30명이 구매할 확률
- 누적분포함수(cumulative distribution function)
- 예: 0명~30명이 구매할 확률의 합
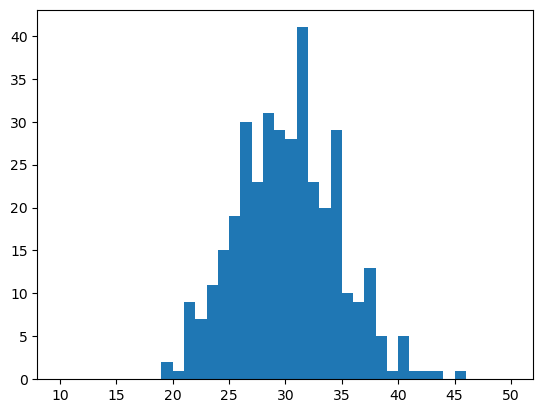
- 난수를 뽑아 365일 동안 구매자 수가 어떻게 분포하는지 시뮬레이션할 수 있음
from scipy.stats import binom
import matplotlib.pyplot as plt

binom.pmf(k=30, n=100, p=0.3)
binom.cdf(k=30, n=100, p=0.3)

data = binom.rvs(n=100, p=0.3, size=365)
plt.hist(data, bins=40, range=[10, 50])
연속 확률 변수
- 연속 확률 변수: 표본공간의 원소를 실수에 대응시키는 함수
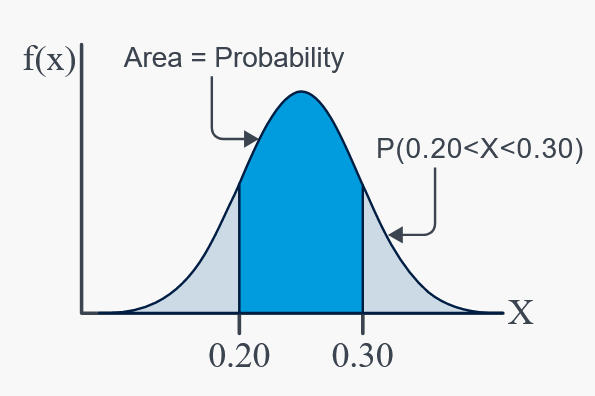
- 확률 밀도 함수
- 확률 변수 가 구간 에 속할 경우, 해당 구간의 면적 = 확률
정규 분포
- 연속확률분포
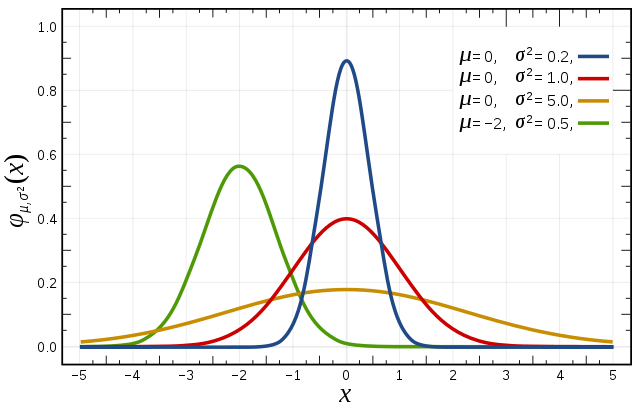
- (뮤)와 (시그마)에 따라 모양이 달라짐
- 의 확률이 가장 높고, 멀어질수록 확률이 낮아짐
- 를 기준으로 좌우대칭
- 이 클수록 넓게 퍼짐
- 이름과 관련된 특이사항
- 정규 분포라고 하지만 정규적이거나 정상적인 것과는 무관
- 수학자 가우스의 이름을 따라서 가우시안 분포라고도 함
- 하지만 가우스가 발견한 것은 아님
정규분포의 함수와 시뮬레이션
- 확률밀도함수(probability density function)
- 연속확률분포에서 한 점의 확률은 0
- 대신 확률밀도를 구함
- 누적분포함수로 특정 값 이하의 누적 확률을 계산할 수 있음
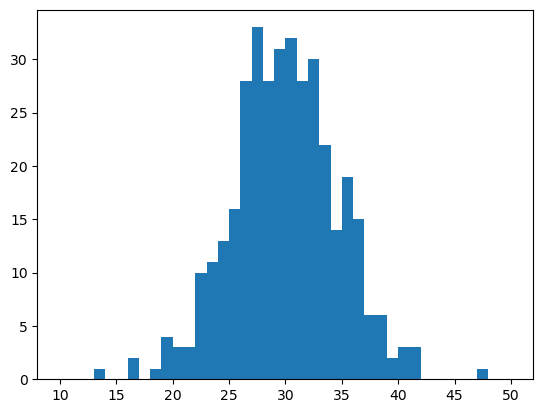
- 평균 , 표준편차 인 정규분포에서 난수를 생성해 히스토그램을 그릴 수 있음
from scipy.stats import norm
import numpy as np
import matplotlib.pyplot as plt

m = 30
s = np.sqrt(21)

norm.pdf(x=30, loc=m, scale=s)
norm.cdf(x=30, loc=m, scale=s)

data = norm.rvs(loc=m, scale=s, size=365)
plt.hist(data, bins=40, range=[10, 50])
중심극한정리
- 어떤 확률분포에서 값을 개 독립적으로 뽑아서 더하여 합계를 구할 경우
- 이 커질수록 합계의 분포는 정규분포와 점점 비슷해짐
- 예: 주사위는 1~6이 고르게 나오지만, 주사위를 10번 던져서 합계를 구하면 35 근처에서 가장 많이 나옴
- 이항분포의 경우
- 이항분포는 베르누이 분포에서 값을 개 뽑아 더한 것과 같음
- 이항분포가 이 커지면 정규분포와 비슷해짐
- ,
키 분포와 정규분포
- 키에는 유전자가 크게 관여
- 일란성 쌍둥이의 키는 거의 비슷
- 키에 관여하는 유전자는 여러 개
- 유전자들이 독립적으로 유전된다고 가정하면
- 중심극한정리에 따라 키에 대한 유전자의 효과는 정규분포를 따르게 됨
- 실제로는 정규분포와 조금은 맞지 않음
- 아마도 유전자들의 분포가 다르고, 서로 독립적이지 않음
- 정규분포로 예상되는 것보다 더 크거나 작은 사람들이 있음
- 주의: 역으로 정규분포를 따른다고 해서 반드시 유전자 때문은 아님