잔차 분석
잔차 분석
- 잔차(residual): 실제값과 회귀모형의 예측값 차이
- 잔차 분석에서는 잔차의 분포와 패턴을 확인
- 분포의 왜도와 첨도
- 정규성
- 예측값에 따른 분산과 비선형 패턴
- 관측 순서에 따른 자기상관
- 순수한 점예측에서는 잔차 정규성이 직접적인 필수 조건은 아님
- 비선형성, 이분산성, 자기상관은 모형의 일반화 성능과 표준오차, 신뢰구간, 예측구간에 영향
- 잔차 패턴은 누락된 변수나 비선형 관계 등 모형 개선의 단서를 제공
실습 모형과 잔차
중고차 데이터에서 차종 변수를 제외한 model1과 차종 변수를 포함한 model2를 비교.
import pandas as pd
import seaborn as sns
import scipy as sp
import matplotlib.pyplot as plt
from statsmodels.formula.api import ols

df = pd.read_excel("used_cars.xlsx")

model1 = ols(
    "price ~ mileage_km + year + accident_count",
    data=df,
).fit()

model2 = ols(
    "price ~ mileage_km + year + accident_count + model",
    data=df,
).fit()

r1 = model1.resid
r2 = model2.resid
히스토그램으로 두 모형의 잔차 분포를 비교.
fig, ax = plt.subplots(1, 2, figsize=(10, 5))
sns.histplot(r1, ax=ax[0])
sns.histplot(r2, ax=ax[1])
ax[0].set_title("model1")
ax[1].set_title("model2")
차종을 포함한 model2의 잔차가 model1보다 대칭적인 형태. 결정계수도 0.673에서 0.955로 증가하지만, 높은 결정계수만으로 잔차 가정이 모두 충족되었다고 판단할 수는 없음.
왜도
- 왜도(skewness): 분포의 비대칭성
- 양수: 오른쪽 꼬리가 긴 분포
- 음수: 왼쪽 꼬리가 긴 분포
0에 가까울수록 좌우 대칭에 가까움
sp.stats.skew(r1), sp.stats.skew(r2)
결과는 각각 1.1561, 0.1477. 차종을 포함한 뒤 잔차의 비대칭성이 크게 감소.
첨도
- 첨도(kurtosis): 분포 꼬리의 두꺼움과 극단값 발생 경향을 나타내는 지표
- 일반 첨도(Pearson kurtosis)
- 정규분포의 첨도는
3
- 정규분포의 첨도는
- 초과 첨도(Fisher kurtosis)
- 일반 첨도에서
3을 뺀 값 - 정규분포의 초과 첨도는
0
- 일반 첨도에서
scipy.stats.kurtosis는 기본적으로 초과 첨도를 반환statsmodels의 회귀분석 요약표에 표시되는Kurtosis는 일반 첨도
# 초과 첨도: fisher=True가 기본값
sp.stats.kurtosis(r1), sp.stats.kurtosis(r2)
결과는 각각 0.0956, 0.0369.
# 일반 첨도
sp.stats.kurtosis(r1, fisher=False), sp.stats.kurtosis(r2, fisher=False)
결과는 각각 3.0956, 3.0369. statsmodels 요약표의 3.096, 3.037과 같은 기준.
정규성
- Omnibus 검정과 Jarque-Bera 검정의 귀무가설: 잔차가 정규분포를 따름
- p-value가 작으면 정규성 귀무가설 기각
- p-value가 크면 정규성을 입증하는 것이 아니라 기각할 근거가 부족하다는 의미
model1.summary()
model2.summary()
| 모형 | 왜도 | 일반 첨도 | Omnibus p-value | Jarque-Bera | JB p-value |
|---|---|---|---|---|---|
model1 |
1.156 | 3.096 | < 0.001 |
93.713 | 4.47×10⁻²¹ |
model2 |
0.148 | 3.037 | 0.434 |
1.552 | 0.460 |
model1: 두 검정 모두 정규성 귀무가설 기각model2: 정규성 귀무가설을 기각할 근거 부족- 잔차 정규성은 회귀계수의 점추정보다 표본이 작을 때의 t 검정, F 검정, 신뢰구간과 예측구간에 더 직접적으로 관련
Q-Q 플롯
- 이론적 정규분포 분위수와 정렬된 표본 잔차를 비교
- 점들이 직선에 가까우면 정규분포에 가까운 형태
- 양끝에서 직선을 크게 벗어나면 꼬리 또는 이상치 문제 가능
fig, ax = plt.subplots(1, 2, figsize=(10, 5))
sp.stats.probplot(r1, plot=ax[0])
sp.stats.probplot(r2, plot=ax[1])
ax[0].set_title("model1")
ax[1].set_title("model2")
등분산성
- 등분산성(homoscedasticity): 설명변수의 값과 관계없이 오차의 조건부 분산이 일정한 성질
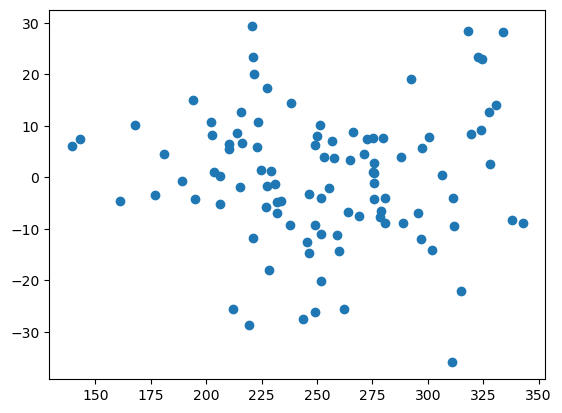
- 예측값과 잔차의 산점도에서 잔차가
0을 중심으로 비슷한 폭으로 퍼지는지 확인 - 부채꼴이나 곡선 형태가 나타나면 이분산성 또는 누락된 비선형 관계 가능
fig, ax = plt.subplots(1, 2, figsize=(10, 5))
ax[0].scatter(model1.predict(df), r1)
ax[1].scatter(model2.predict(df), r2)
ax[0].set_title("model1")
ax[1].set_title("model2")
이분산성의 가능한 원인
- 종속변수가 이진(
0,1), 개수 또는 비율 - 측정값의 바닥효과나 천장효과 등 범위 제한
- 중요한 비선형 관계나 상호작용 누락
- 곱셈적 관계 또는 비율 변화
- 이상치 또는 영향점
- 변동성이 다른 여러 집단의 혼합
자기상관
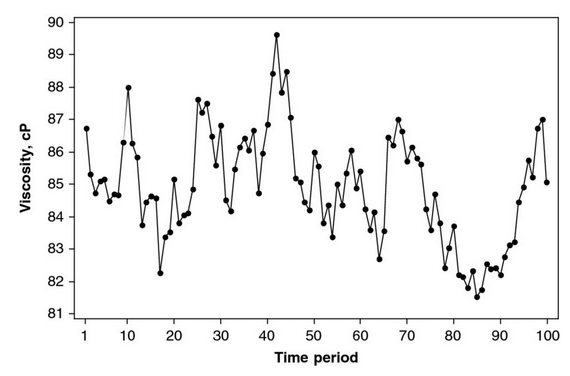
- 자기상관(autocorrelation): 관측 순서에 따라 잔차끼리 상관되는 현상
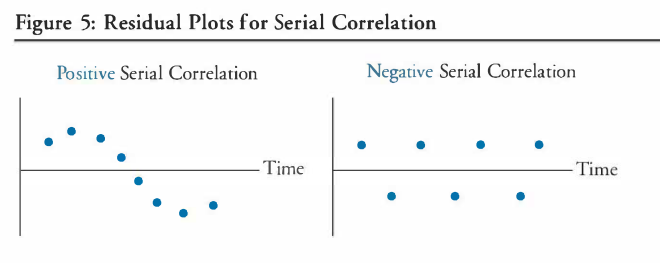
- 양의 자기상관
- 양의 잔차 뒤에 양의 잔차, 음의 잔차 뒤에 음의 잔차가 이어지는 경향
- 음의 자기상관
- 잔차의 부호가 번갈아 나타나는 경향
- 시간, 공간, 생산 순서처럼 관측값에 의미 있는 순서가 있을 때 진단
- 임의로 정렬된 횡단면 데이터에서는 ACF와 Durbin-Watson 통계량의 순서 해석이 의미 없음
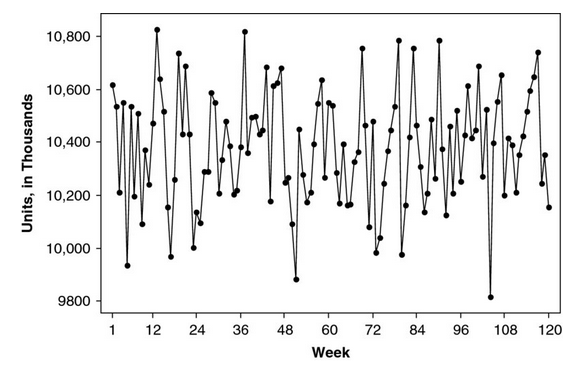
잔차의 자기상관 진단
acf는 시차별 자기상관계수를 계산. 배열의 첫 값은 시차 0이므로 항상 1이고, 두 번째 값이 시차 1의 자기상관계수.
from statsmodels.tsa.stattools import acf

acf(r1)
Colab 결과에서 시차 1의 자기상관계수는 0.0925.
from statsmodels.graphics.tsaplots import plot_acf

plot_acf(r1)
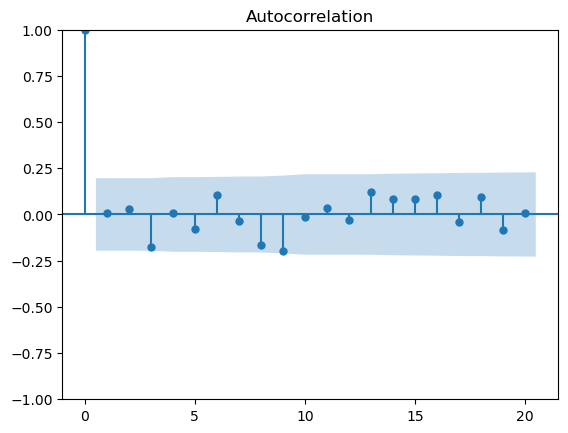
- ACF 플롯의 막대가 신뢰구간을 벗어나는지 확인
- 관측 순서에 의미가 없으면 막대의 크기를 시간적 의존성으로 해석하지 않음
- 자기상관이 있으면 일반 OLS의 표준오차와 p-value가 부정확해질 수 있음
Durbin-Watson 통계량의 범위는 0≤d≤4.
- d가
2에 가까움: 1차 자기상관이 약함 - d<2: 양의 자기상관 방향
- d>2: 음의 자기상관 방향
- Colab 결과:
model1은1.803,model2는2.181 - 두 값 모두 임의의 행 순서에 따라 달라질 수 있으므로, 중고차 데이터에서 시간적 자기상관의 근거로 사용하지 않음
퀴즈
잔차 분석에서 직접 확인하는 항목과 가장 거리가 먼 것은?
퀴즈를 풀려면 대화형 기능을 불러와야 합니다.