
분포의 특성
🤖 AI 프롬프트
df의 speed의 왜도와 첨도를 구해주고, seaborn을 이용해 히스토그램을 그려줘
왜도(skewness)
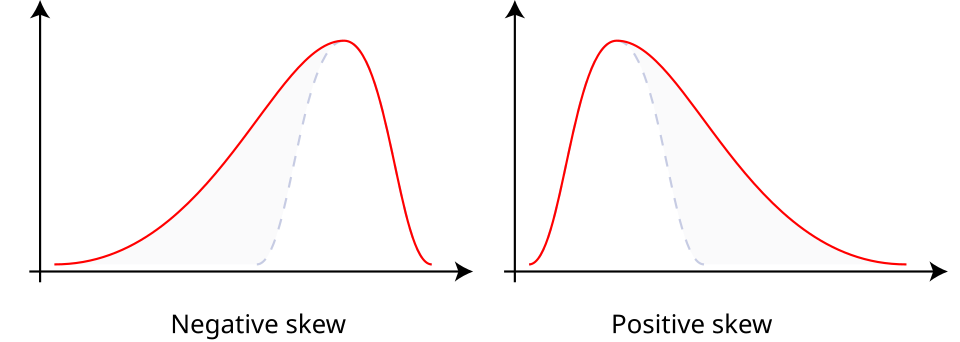
- 왜도: 분포의 비대칭 정도를 나타내는 지표
- 양수: 큰 값 쪽인 오른쪽 꼬리의 영향이 더 큼
- 음수: 작은 값 쪽인 왼쪽 꼬리의 영향이 더 큼
- 대칭인 분포의 왜도는 0. 다만 왜도 0만으로 좌우 대칭을 보장하지는 않음
- μ: 모집단 평균, σ: 모집단 표준편차
from scipy.stats import skew

skew(df.speed)  # 속도 분포의 왜도
실행 결과
np.float64(0.2825749079028675)
- 속도의 왜도: 약 0.2826. 빠른 속도 쪽 꼬리의 영향이 더 큰 분포
- 왜도는 표준화한 값이므로 속도 단위와 무관
첨도(kurtosis)
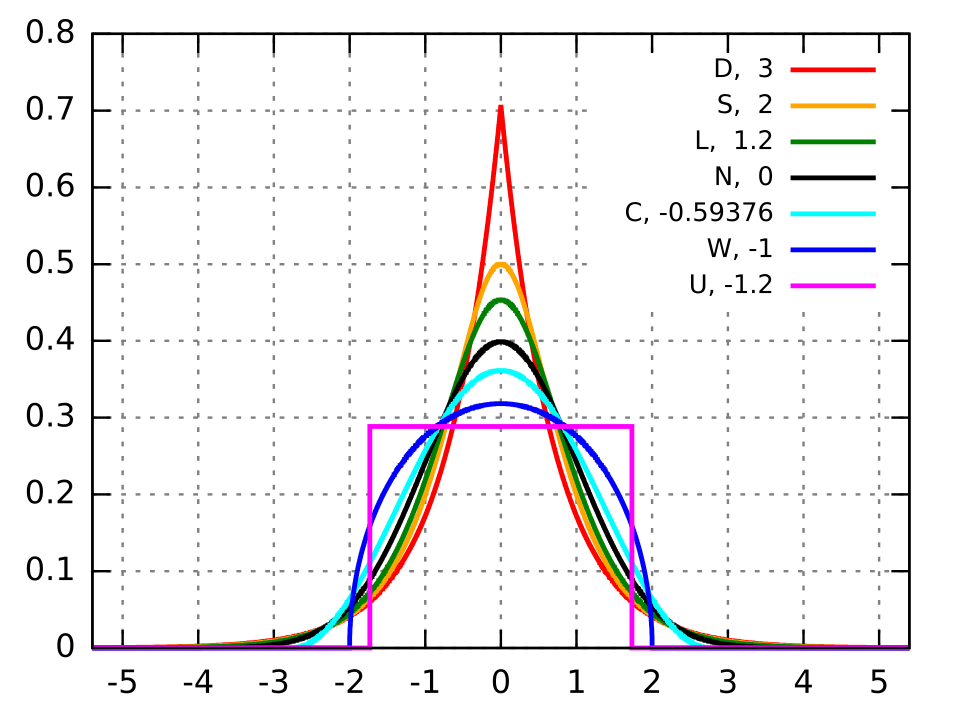
- 첨도: 표준화한 편차의 4제곱 평균. 평균에서 멀리 떨어진 값의 영향을 나타내는 지표
- 표준화한 편차의 절댓값이 1보다 작으면 4제곱한 값은 더 작아짐
- 절댓값이 1보다 크면 4제곱한 값은 더 커짐. 극단적인 관측값이 계산에 크게 기여
- 초과 첨도(excess kurtosis): 첨도에서 정규분포의 첨도 3을 뺀 값
- 정규분포의 첨도는 3, 초과 첨도는 0
- 양의 초과 첨도: 정규분포보다 평균에서 먼 값의 기여가 큰 경우. 두꺼운 꼬리나 극단적인 값의 영향을 확인
- 음의 초과 첨도: 정규분포보다 평균에서 먼 값의 기여가 작은 경우
from scipy.stats import kurtosis

kurtosis(df.speed)  # 기본값은 초과 첨도
실행 결과
np.float64(2.925082447515611)
- 속도의 초과 첨도: 약 2.9251. 0보다 커 정규분포 기준보다 평균에서 먼 값의 기여가 큰 수준
히스토그램(histogram)
- 히스토그램: 데이터를 구간별로 나누고 각 구간의 관측값 수를 막대 높이로 표시한 그래프
- 시본(seaborn)의
histplot()으로 작성data=df: 사용할 데이터프레임x="speed": 가로축에 사용할 열 이름. 변수 이름이 아니라 문자열로 지정- 기본 세로축
Count: 각 속도 구간에 속한 선박 수
- seaborn은 맷플롯립(matplotlib)을 사용.
plt.show()로 그래프 표시
import seaborn as sns
import matplotlib.pyplot as plt

sns.histplot(x="speed", data=df)
plt.show()
실행 결과
<Figure size 640x480 with 1 Axes>
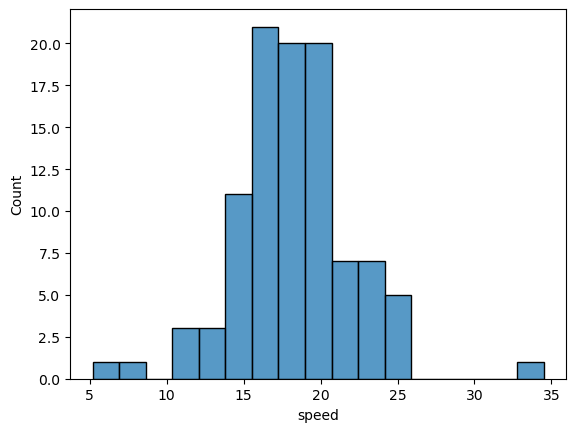
- 속도가 집중된 구간과 빠른 속도 쪽으로 이어지는 분포 형태 확인
구간 수 지정
bins에 정수를 지정하면 구간 수 설정
sns.histplot(x="speed", data=df, bins=30)  # 구간을 더 세분화한 비교 예시
plt.show()
실행 결과
<Figure size 640x480 with 1 Axes>
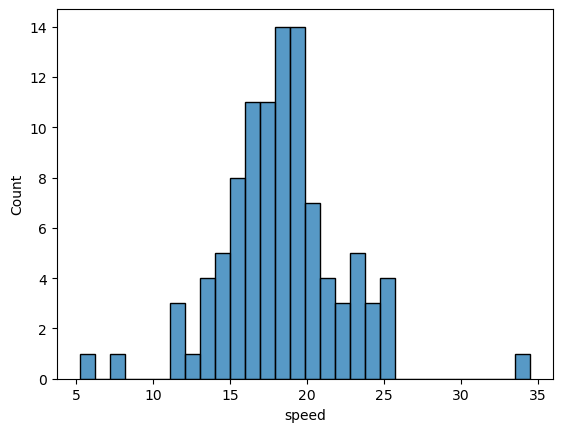
- 같은 자료를 30개 구간으로 나눈 결과. 구간 수에 따라 막대의 너비와 세부 모양이 달라짐
구간 경계 지정
bins에 경계값 목록을 지정하면 각 구간의 시작점과 끝점 설정- 속도 5~35노트를 5노트 간격으로 나누는 예시
xs = list(range(5, 36, 5))  # 5~35노트를 포함하는 5노트 간격의 경계
sns.histplot(x="speed", data=df, bins=xs)
plt.xticks(xs)
plt.show()
실행 결과
<Figure size 640x480 with 1 Axes>
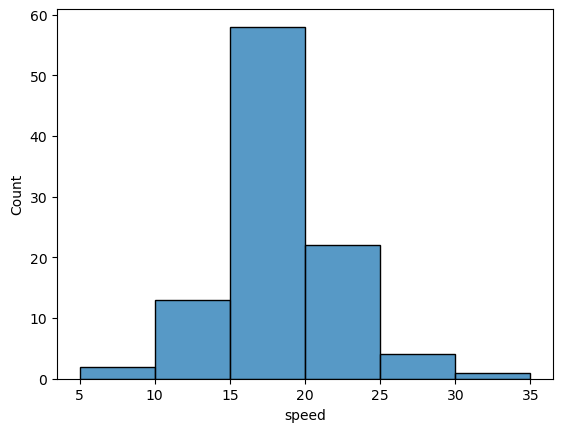
- 경계값 7개로 구간 6개 생성
- 구간은 왼쪽 경계 포함, 오른쪽 경계 제외. 마지막 구간은 오른쪽 경계도 포함
bins=xs는 집계 구간,plt.xticks(xs)는 가로축 눈금 위치를 지정range()는 끝값을 제외하므로 35를 포함하려면 끝값을 35보다 크게 지정
커널 밀도 추정(kernel density estimation)
- 커널 밀도 추정(KDE): 관측값 주변의 밀도를 합쳐 분포 형태를 부드럽게 추정하는 방법
kde=True: 히스토그램에 KDE 곡선 추가- 기본 빈도 히스토그램에서는 곡선 높이도 막대의 빈도 척도에 맞춰 조정
sns.histplot(x="speed", data=df, kde=True)
plt.show()
실행 결과
<Figure size 640x480 with 1 Axes>
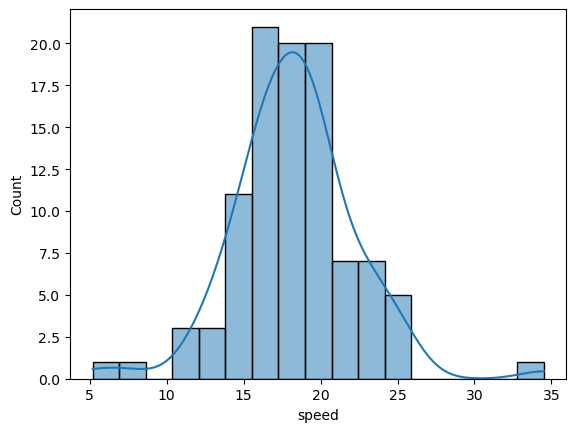
- 막대는 구간별 선박 수, 곡선은 자료의 부드러운 분포 형태를 표시
- KDE 곡선은 정규분포를 가정해 그린 곡선이 아니라 관측값으로 추정한 곡선
퀴즈
속도 분포의 왜도가 양수일 때, 어느 쪽 꼬리의 영향이 더 큰 것으로 해석하나요?
퀴즈를 풀려면 대화형 기능을 불러와야 합니다.