상관 분석
산점도
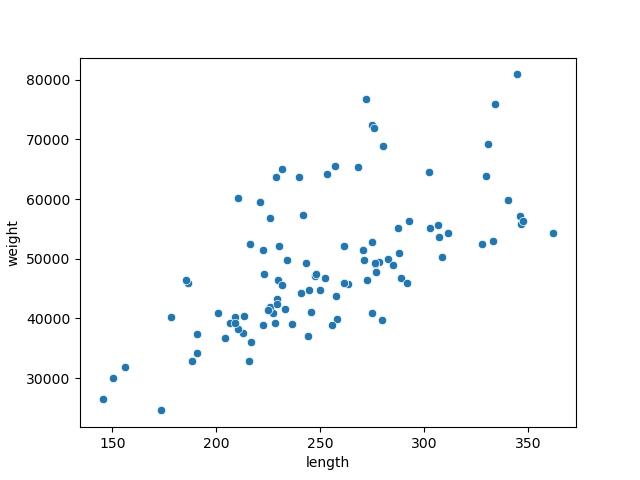
- 산점도: 두 연속형 변수 간의 관계를 시각적으로 파악하는 가장 기본적인 방법
- 가로축(X축)과 세로축(Y축)에 각각의 변숫값을 매핑하여 점으로 표시
- 분포의 형태, 선형성, 이상치 존재 여부를 직관적으로 확인 가능
import pandas as pd
import seaborn as sns

df_ship = pd.read_excel('ship.xlsx')
sns.scatterplot(data=df_ship, x='length', y='weight')
상관 계수
- 상관 계수(correlation coefficient): 두 변수의 연관성을 −1부터 +1까지의 범위로 나타낸 수치
- 두 변수의 연관성을 파악하기 위해 사용
- 예
- 어휘력과 독해력의 관계
- 주가와 금 가격의 관계
- 엔진 성능과 고객만족도의 관계
상관관계
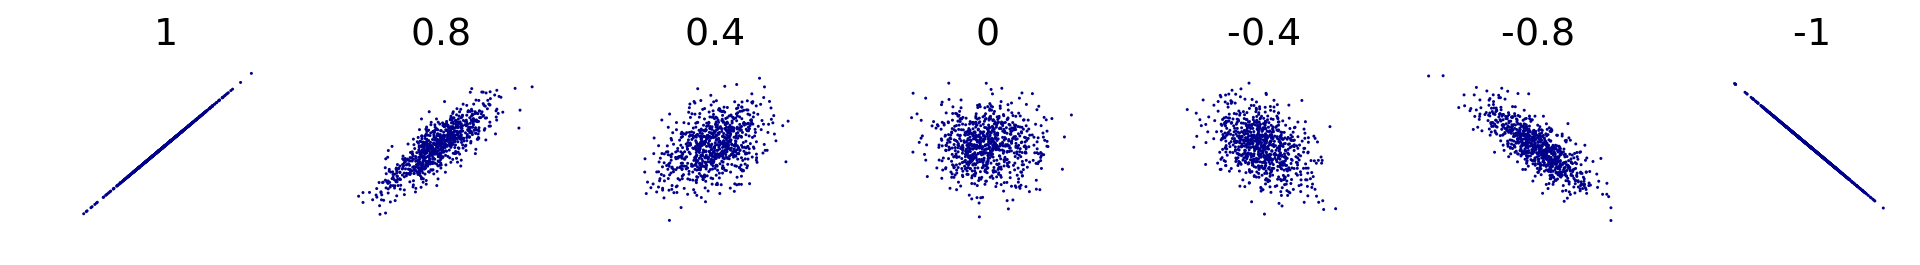
- 양의 상관관계(Positive Correlation)
- 상관계수가 0보다 큼
- +1에 가까울수록 강한 양의 선형 관계
- 한 변수의 값이 증가할 때, 다른 변수의 값도 함께 증가하는 경향
- 산점도에서 점들이 우상향하는 패턴을 보임
- 예: 선박의 길이와 무게
- 음의 상관관계(Negative Correlation)
- 상관계수가 0보다 작음
- −1에 가까울수록 강한 음의 선형 관계
- 한 변수의 값이 증가할 때, 다른 변수의 값은 감소하는 경향
- 산점도에서 점들이 우하향하는 패턴을 보임
- 상관관계 없음(No Correlation)
- 상관계수가 0에 가까움
- 두 변수 간에 뚜렷한 선형적 경향성이 나타나지 않음
- 점들이 무작위로 흩어져 있는 형태
기울기
- 기울기는 y=ax+b에서 a
- x가 1만큼 변할 때, y의 변화량을 나타냄
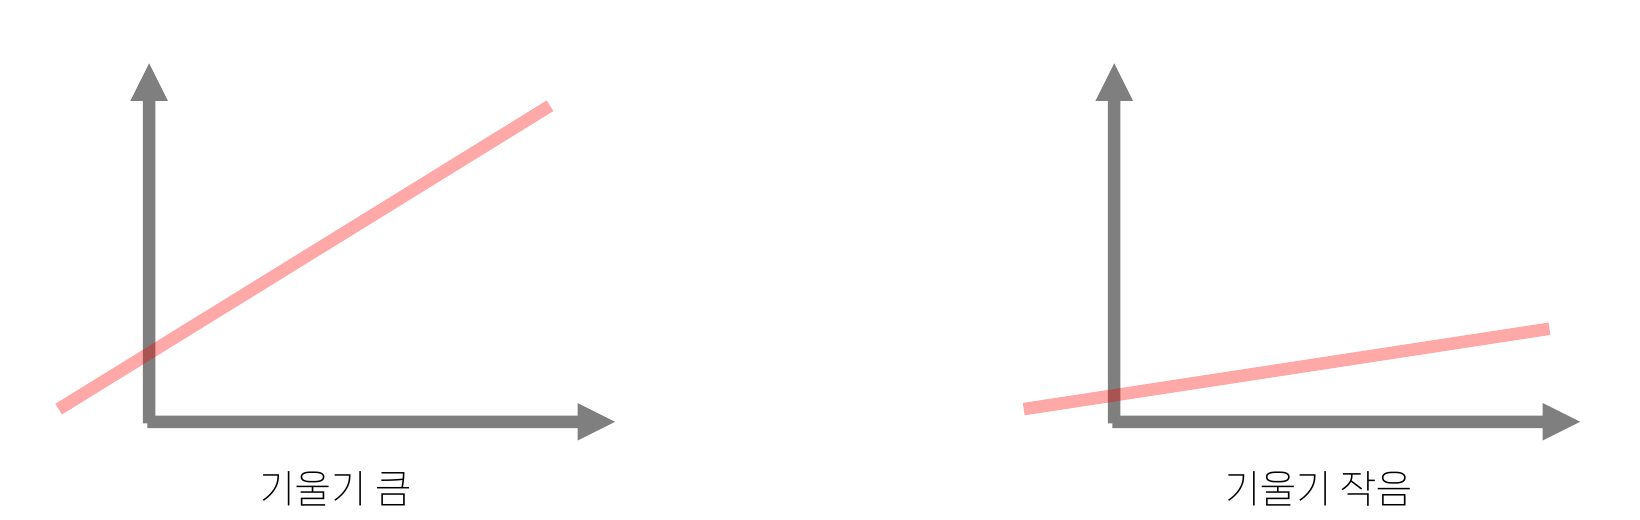
- 기울기가 클수록 y가 크게 변함
- 상관계수와 다른 개념이므로 주의
기울기와 상관계수
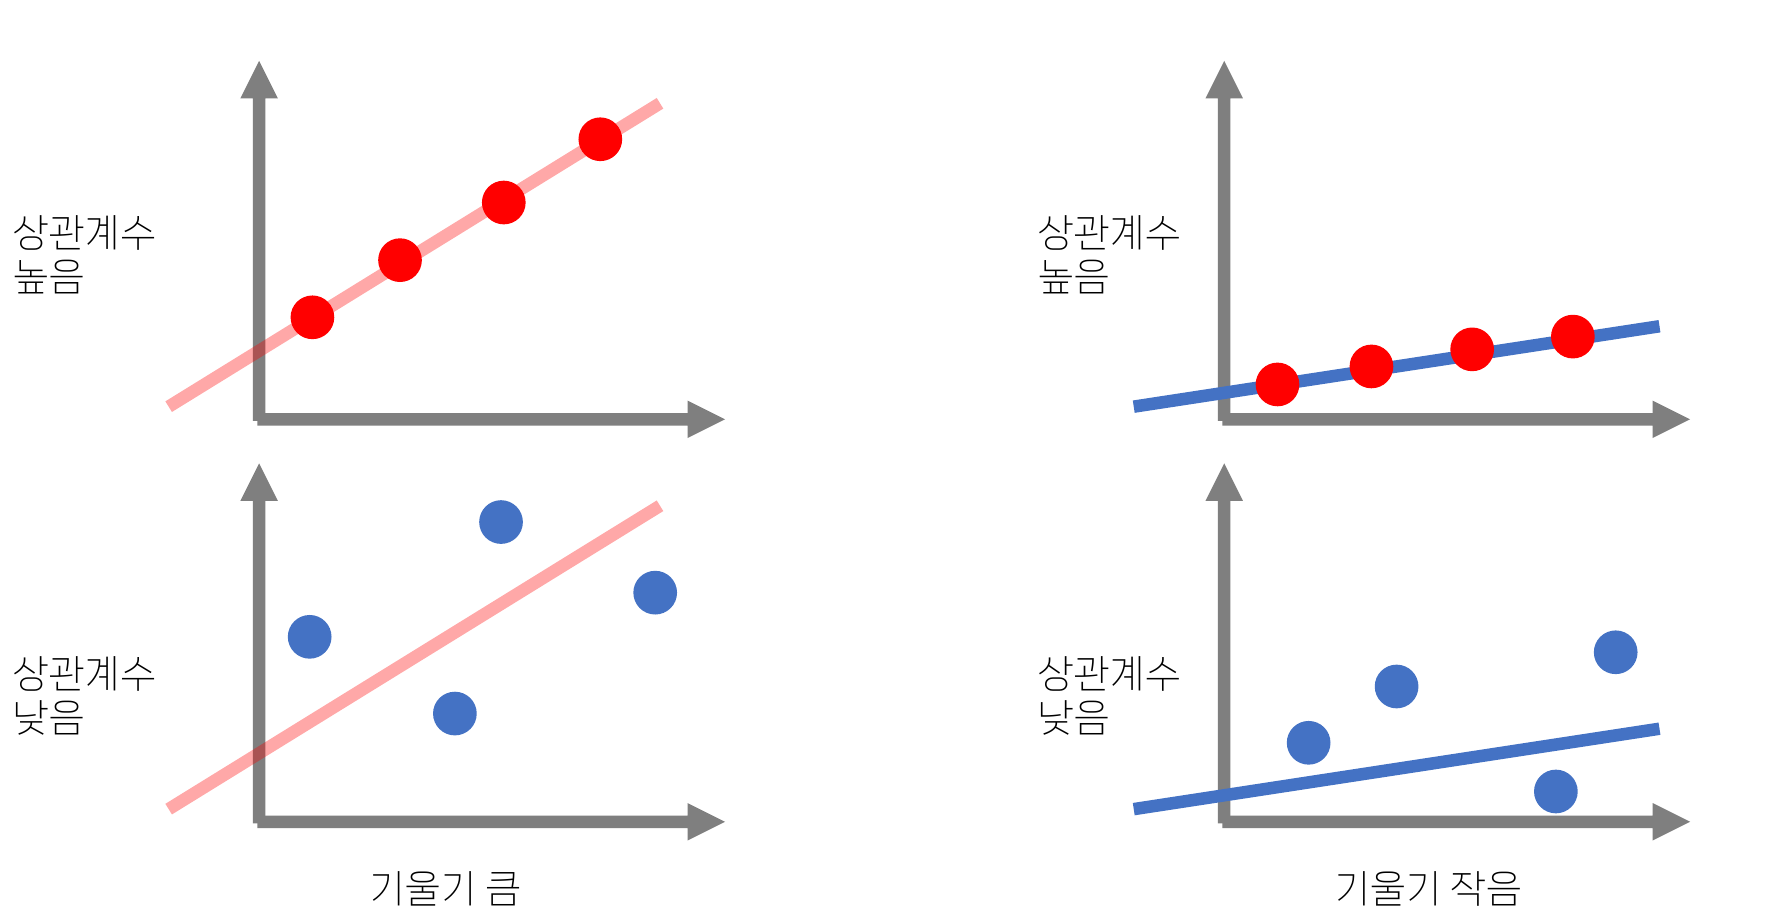
- 기울기는 직선이 얼마나 가파른지를 나타냄
- 상관계수는 점들이 선형 패턴에 얼마나 강하게 모여 있는지를 나타냄
- 기울기가 커도 상관계수가 낮을 수 있고, 기울기가 작아도 상관계수가 높을 수 있음
공분산과 상관계수
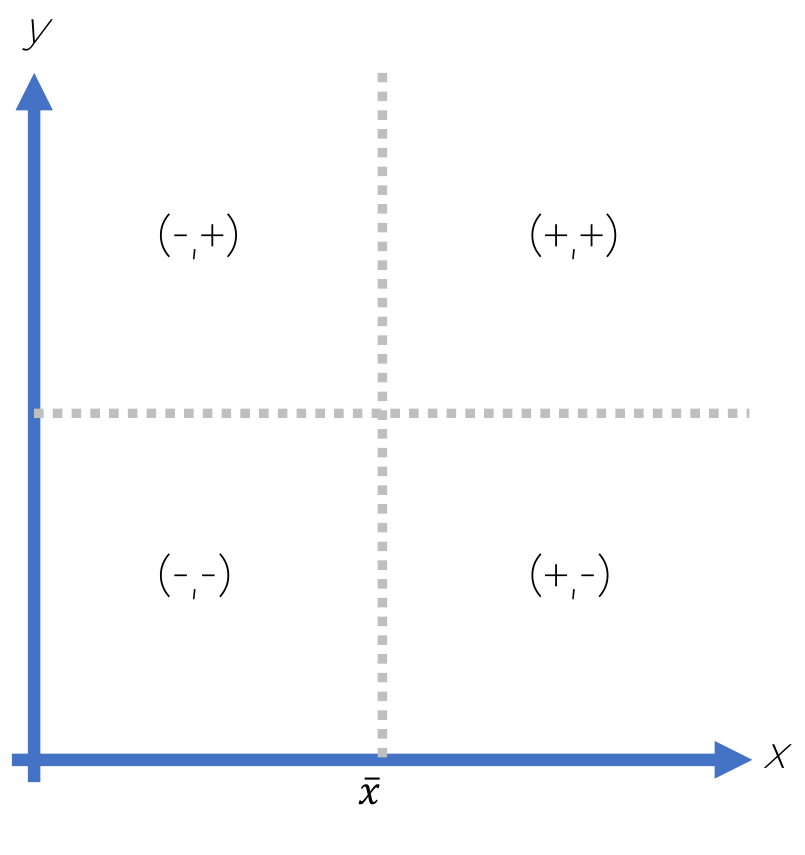
- 표본 공분산(sample covariance): 두 변수가 함께 변화하는 정도를 측정
- X와 Y의 편차 곱을 자유도 n−1로 나눈 값
- X=Y이면 표본분산과 같음
- 공분산의 부호에 따른 의미
- 양수(+): 양의 상관관계
- 음수(-): 음의 상관관계
- 0에 가까움: 뚜렷한 선형 관계가 없음
- 공분산은 변수의 측정 단위에 영향을 받으므로 관계의 강도를 직접 비교하기 어려움
df_ship[['length', 'weight']].cov()
length와weight의 표본 공분산: 329821.1- 양수이므로 길이가 긴 선박일수록 무거운 경향
피어슨 상관계수
- 피어슨 상관계수(Pearson Correlation Coefficient)
- 공분산을 각 변수의 표준편차로 나누어 정규화한 값
- 단위의 영향을 제거
- 두 변수 간의 선형적 관계의 강도와 방향을 수치로 표현
- 표본 상관계수는 r, 모집단 상관계수는 ρ로 표기
import pingouin as pg

pg.corr(x=df_ship['length'], y=df_ship['weight'])
- Pearson 상관계수: r=0.630324
- 95% 신뢰구간:
[0.50, 0.74] - p-value:
2.11e-12 - 길이와 무게 사이에 통계적으로 유의한 양의 선형 관계
상관행렬
여러 변수의 상관계수를 한 번에 계산하고 히트맵으로 확인
cols = ['length', 'beam', 'weight', 'speed']
df_corr = df_ship[cols].corr()

sns.heatmap(df_corr, annot=True, cmap='coolwarm', vmin=-1, vmax=1)
상관계수와 비단조적 관계
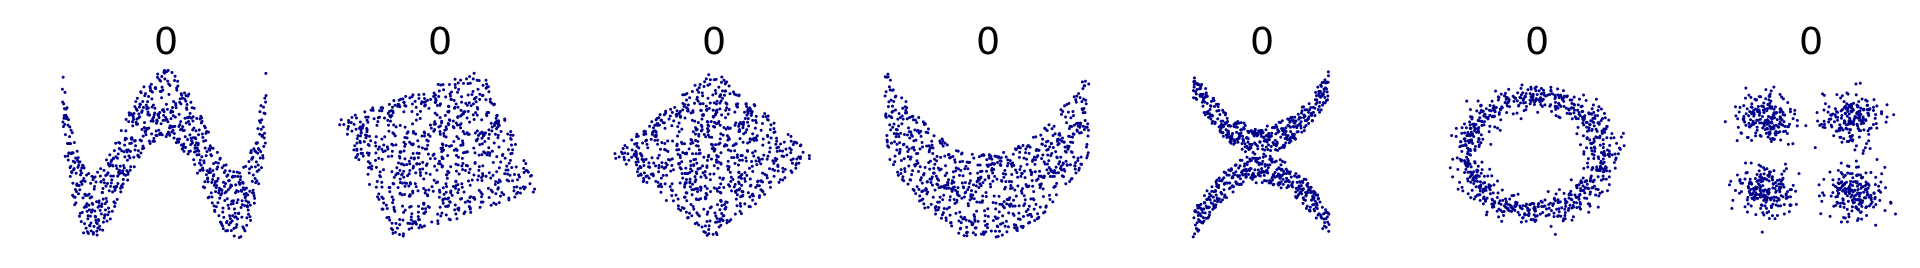
- Pearson 상관계수는 선형 관계를 표현
- 복잡한 비선형 관계는 잘 나타내지 못함
- 상관계수가 낮아도 비선형 관계가 존재할 수 있음
퀴즈
산점도에 대한 설명으로 가장 적절한 것은?
퀴즈를 풀려면 대화형 기능을 불러와야 합니다.