변수의 변형
변수 변형의 목적
- 선형 모형은 독립변수와 종속변수의 관계를 직선으로 표현
- 독립변수를 비선형 변환하면 원래 척도에서 휘어진 관계도 선형 모형으로 표현 가능
- 독립변수 자체가 정규분포를 따를 필요는 없음
- 변환 여부는 산점도에서 확인한 관계의 형태와 분석 목적을 기준으로 결정
statsmodels관계식에 수학 함수를 사용하면 변수 변환을 모형에 직접 적용 가능
왜도
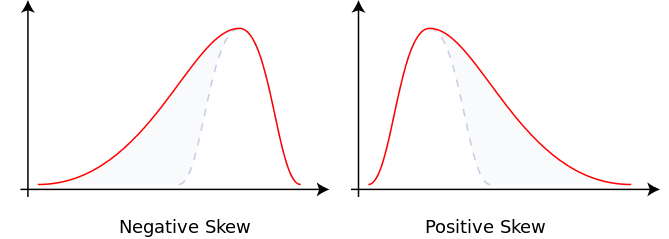
- 왜도(skewness)는 분포의 좌우 비대칭 정도
- 음의 왜도: 왼쪽 꼬리가 더 긴 분포
- 양의 왜도: 오른쪽 꼬리가 더 긴 분포
- 좌우대칭인 분포의 왜도는 0이지만, 왜도 0만으로 좌우대칭을 보장하지는 않음
- 왜도의 크기에 대한 판단 기준은 분야와 자료의 성격에 따라 달라짐
데이터 준비
import pandas as pd
import seaborn as sns
from statsmodels.formula.api import ols

df_car = pd.read_excel("car.xlsx")
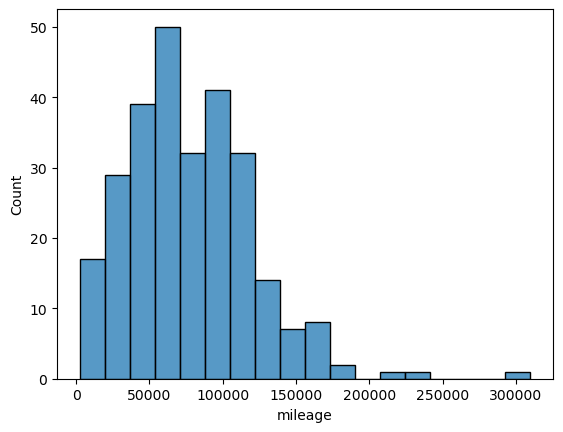
중고차 주행거리의 분포
sns.histplot(x="mileage", data=df_car)
df_car["mileage"].skew()
왜도는 1.0408. 중고차 주행거리(mileage)는 오른쪽 꼬리가 긴 양의 왜도 분포.
로그 함수
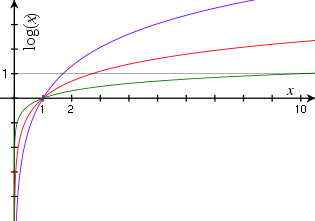
- 로그 함수는 오른쪽 위로 갈수록 증가폭이 완만해지는 형태
- 가로축의 1, 10, 100이 로그축에서는 같은 간격으로 변환됨
- 데이터에 적용하면 오른쪽에 멀리 떨어져 있는 값을 왼쪽으로 끌어당기는 효과
- 독립변수가 오른쪽으로 크게 늘어진 경우, 예를 들어 소득처럼 큰 값이 드문 경우에 간격을 조정할 수 있음
- 로그 변환은 0보다 큰 값에 적용
Python 회귀분석과 산점도
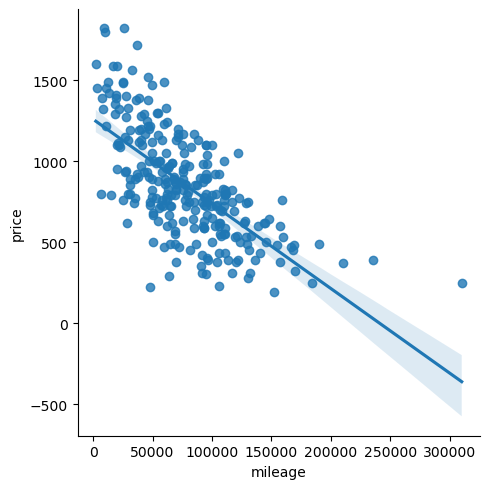
ols("price ~ mileage", df_car).fit().summary()
mileage의 회귀계수:-0.0052, p-value< 0.001- R2:
0.457 - 주행거리가 1단위 증가할 때 예측
price가 평균0.0052감소하는 관계
sns.lmplot(x="mileage", y="price", data=df_car)
Python 로그 함수 적용
import numpy as np

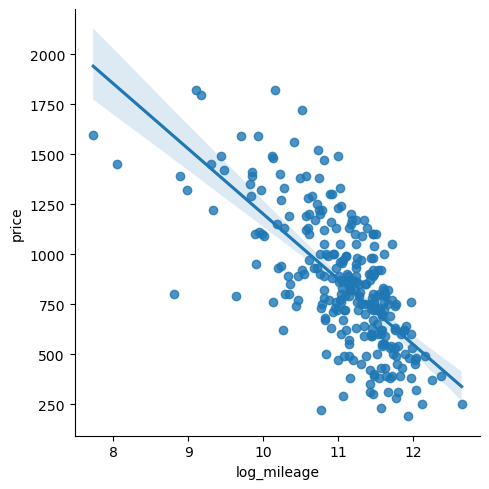
ols("price ~ np.log(mileage)", df_car).fit().summary()
np.log(mileage)의 회귀계수:-326.3958, p-value< 0.001- R2:
0.479 - 원래 주행거리 모형보다 표본 내 설명력이 소폭 증가
- 오른쪽 꼬리를 압축하여 가격과의 관계를 더 선형적으로 표현
df_car["log_mileage"] = np.log(df_car["mileage"])
sns.lmplot(x="log_mileage", y="price", data=df_car)
Box-Cox 변환
- Box-Cox 변환은 로그 변환의 일반화
- λ=0일 때는 로그 함수와 같음
- 0보다 큰 값에만 적용 가능
boxcox에 λ를 지정하지 않으면 변환값이 정규분포를 따른다는 가정 아래 로그우도를 최대화하는 값을 추정
from scipy.stats import boxcox

df_car["mileage_tr"], lambd = boxcox(df_car.mileage)
lambd
결과는 0.5323.
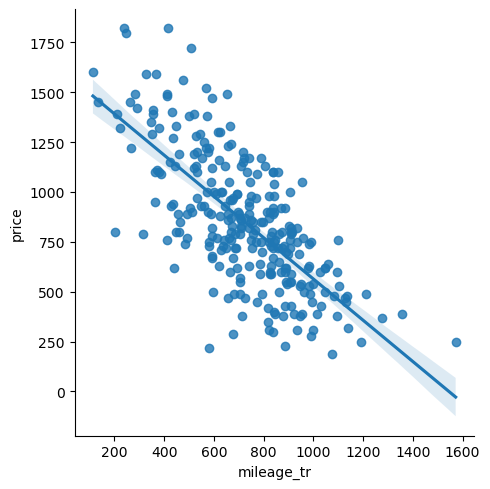
ols("price ~ mileage_tr", df_car).fit().summary()
mileage_tr의 회귀계수:-1.0349, p-value< 0.001- R2:
0.498 - 원자료, 로그, Box-Cox 세 모형 중 가장 높은 표본 내 설명력
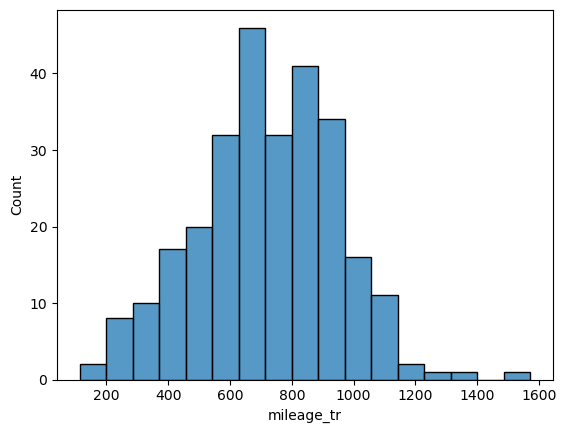
Box-Cox 변환 결과
sns.histplot(x="mileage_tr", data=df_car)
sns.lmplot(x="mileage_tr", y="price", data=df_car)
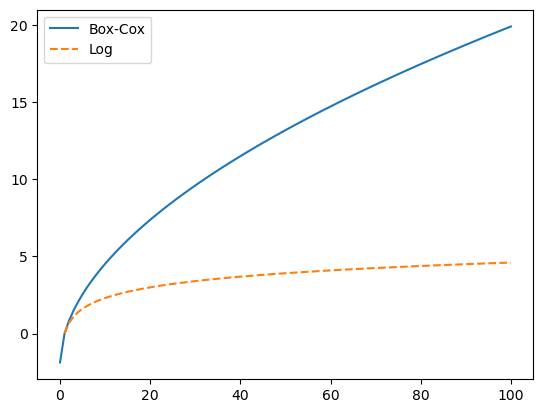
변환 함수의 시각화
import matplotlib.pyplot as plt

x = np.linspace(1, 100, 100)
y1 = boxcox(x, lambd)
plt.plot(x, y1, label="Box-Cox")

y2 = np.log(x)
plt.plot(x, y2, linestyle="dashed", label="Log")
plt.legend()
독립변수의 서열을 이용한 회귀분석
- 독립변수의 서열, 즉 등수가 1 변할 때 종속변수가 얼마나 변하는지 분석
- 이 예제는 독립변수
mileage만 등수로 변환하고 종속변수price는 원래 척도를 유지 - 스피어만 상관계수는 두 변수를 모두 등수로 변환하므로 이 모형과 다름
ols("price ~ mileage.rank()", df_car).fit().summary()
mileage.rank()의 회귀계수:-2.9113, p-value< 0.001- R2:
0.481 - 주행거리 등수가 1 증가할 때 예측
price가 평균2.9113감소하는 관계
df_car["mileage_rank"] = df_car["mileage"].rank()
sns.lmplot(x="mileage_rank", y="price", data=df_car)
sns.histplot(x="mileage_rank", data=df_car)
- 장점
- 단위가 서로 다른 독립변수를 같은 등수 척도로 변환 가능
- 한쪽 꼬리가 긴 독립변수의 간격을 고르게 조정 가능
- 단점
- 새로운 데이터는 기존 데이터의 등수에 맞춰 등수를 산정해야 함
- 예측할 때 기존 관찰 범위를 넘어서면 예측하기 어려움
퀴즈
회귀분석에서 변수 변형을 사용하는 주된 이유로 가장 적절한 것은?
퀴즈를 풀려면 대화형 기능을 불러와야 합니다.