기술 통계: 백분위수와 사분위수
백분위수(Percentiles)
- 데이터를 크기 순으로 정렬했을 때, 특정 퍼센트에 해당하는 값
- 하위 10%에 해당하는 위치의 값을 10퍼센타일이라고 함
- 다른 데이터들과 비교했을 때 상대적으로 상위 또는 하위에 속하는지 파악 가능
🤖 AI 프롬프트
df에서 speed의 10퍼센타일과 90퍼센타일을 구해줘.
df["speed"].quantile([0.1, 0.9]) # 속도의 10퍼센타일과 90퍼센타일
실행 결과
0.1    14.08
0.9    23.03
Name: speed, dtype: float64
- 10퍼센타일은 14.08노트, 90퍼센타일은 23.03노트
사분위수(Quartiles)와 IQR
- 전체 데이터를 순서대로 4등분하는 지점의 값(25%, 50%, 75%)
- 제1사분위수(Q1, 25%), 제2사분위수(Q2, 중간값), 제3사분위수(Q3, 75%)
- 사분위수 범위(IQR, Interquartile Range)는 Q3−Q1이며, 중간 50% 데이터의 퍼짐 정도를 나타냄
- 양 극단의 이상치에 영향을 덜 받는 강건한(robust) 척도
🤖 AI 프롬프트
df에서 speed의 1사분위수, 3사분위수, IQR를 확인해줘.
q1 = df["speed"].quantile(0.25)
q1  # 제1사분위수
실행 결과
np.float64(16.1)
q3 = df["speed"].quantile(0.75)
q3  # 제3사분위수
실행 결과
np.float64(20.325)
iqr = q3 - q1
iqr  # 사분위수 범위
실행 결과
np.float64(4.224999999999998)
- 중간 50%의 속도 구간: 16.1~20.325노트. IQR은 4.225노트
사분위수 범위를 활용한 이상치 식별
- IQR에 1.5를 곱한 값을 사용하여 이상치 판단의 일반적인 기준으로 삼음(Tukey 방법)
- 상한선: Q3+1.5×IQR보다 큰 값
- 하한선: Q1−1.5×IQR보다 작은 값
- 표준편차를 이용한 식별 방법보다 이상치에 강건한 방식
🤖 AI 프롬프트
df의 speed가 1사분위수와 3사분위수에서 IQR 1.5배를 벗어나는 행을 보여줘.
lower = q1 - 1.5 * iqr
upper = q3 + 1.5 * iqr
lower  # IQR 하한선
실행 결과
np.float64(9.762500000000005)
upper # IQR 상한선
실행 결과
np.float64(26.662499999999994)
df.query("speed < @lower or speed > @upper")[["ship_name", "speed"]]
실행 결과
   ship_name  speed
5   Ship_006    5.2
10  Ship_011   34.5
12  Ship_013    7.6
- 하한선은 9.7625노트, 상한선은 26.6625노트
- 기준을 벗어난 선박:
Ship_006(5.2노트),Ship_011(34.5노트),Ship_013(7.6노트) - 3시그마 규칙보다 구간이 좁아 7.6노트도 이상치로 식별
상자 수염 그림
- 상자 수염 그림(Box and Whisker plot): 사분위수 범위와 이상치를 한눈에 볼 수 있도록 도식화한 그래프
- 상자(Box)는 Q1부터 Q3까지(IQR)를 그리며, 그 안의 선은 중간값 표시
- 수염(Whisker)은 Q1−1.5×IQR 이상, Q3+1.5×IQR 이하 범위 안의 실제 최솟값과 최댓값까지 표시
🤖 AI 프롬프트
seaborn으로 df의 speed 열에 대한 상자 수염 그림을 그려줘.
import seaborn as sns

sns.boxplot(data=df, x="speed")
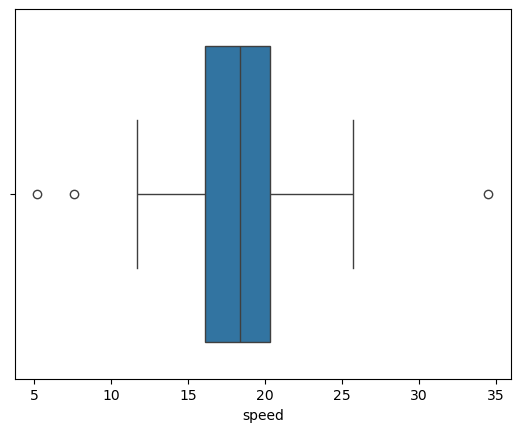
- 상자 안의 선: 중간값 18.35노트
- 수염 바깥의 점: 5.2노트, 7.6노트, 34.5노트
퀴즈
- 계산 문제는
ship.xlsx를 불러온df의crew_size열 전체를 사용
사분위수 범위(IQR)는 어느 구간의 퍼짐을 나타내나요?
퀴즈를 풀려면 대화형 기능을 불러와야 합니다.