스태킹
스태킹
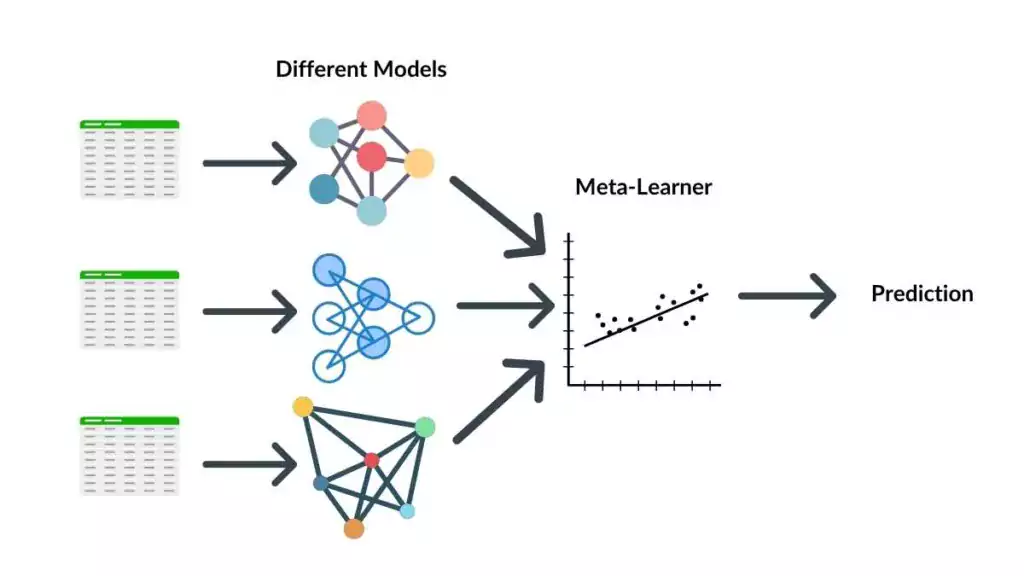
- 스태킹(stacking): 여러 모델의 예측을 다시 입력으로 사용하는 방식
- 1단계 모델들이 각자 예측
- 2단계 메타 모델이 그 예측 결과를 보고 최종 판단
- 서로 성격이 다른 모델을 조합할 때 활용
실습 준비
- 앙상블 문서에서 데이터를 불러오고 분할한 노트북에서 이어서 실행
- 앞에서 준비한
X,X_train,X_test,y_train,y_test를 그대로 사용
실습 프롬프트
🤖 AI 프롬프트
datacenter_incident.xlsx 데이터를 8:2로 train과 test로 분할해(random_state=42)
타깃 incident_next_hour에서 0은 정상, 1은 1시간 이내 장애 발생이야.
StackingClassifier의 1단계 모델로 결정트리와 KNN을 사용해줘.
2단계 모델은 결정트리로 설정해줘.
학습 데이터로 스태킹 모델을 학습하고 테스트 정확도를 확인해줘.
필요한 라이브러리를 불러오고 각 단계에 초보자를 위한 한글 주석을 달아줘.
StackingClassifier 실습
- 결정트리와 KNN의 예측을 결합
- 최종 모델은 얕은 결정트리 사용
- KNN 앞에 표준화를 적용해 입력 변수의 단위 차이 조정
cv=5: 학습 데이터를 5개로 나누어, 각 사례의 정답을 학습하지 않은 기본 모델의 예측으로 메타 모델 학습
from sklearn.ensemble import StackingClassifier
from sklearn.metrics import accuracy_score
from sklearn.tree import DecisionTreeClassifier
from sklearn.neighbors import KNeighborsClassifier
from sklearn.pipeline import make_pipeline
from sklearn.preprocessing import StandardScaler

stack_clf = StackingClassifier(
    estimators=[
        ("tree", DecisionTreeClassifier(max_depth=4, random_state=42)),
        (
            "knn",
            make_pipeline(
                StandardScaler(),
                KNeighborsClassifier(n_neighbors=5),
            ),
        ),
    ],
    final_estimator=DecisionTreeClassifier(max_depth=2, random_state=42),
    cv=5,  # 메타 모델 학습에 사용할 교차검증 분할 수
)

stack_clf.fit(X_train, y_train)
y_pred_stack = stack_clf.predict(X_test)
accuracy_score(y_test, y_pred_stack)
실행 결과
0.725
- 스태킹의 테스트 정확도: 72.5%
같은 데이터에서의 모델 비교
- 같은 학습·테스트 분할에서 실행한 결과
- 기본 설정에서의 비교이며 모든 데이터에서 같은 순위를 보장하는 결과는 아님
| 모델 | 테스트 정확도 |
|---|---|
| 단일 결정트리 | 71.5% |
| 랜덤 포레스트 | 73.0% |
| AdaBoost | 72.0% |
| 경사 부스트 | 71.5% |
| 스태킹 | 72.5% |
퀴즈
스태킹(stacking)의 특징으로 가장 적절한 것은?
퀴즈를 풀려면 대화형 기능을 불러와야 합니다.