차원 축소
차원 축소(Dimensionality Reduction): 고차원 데이터의 중요한 정보는 최대한 유지하면서 더 낮은 차원으로 변환하는 기법
목표 및 장점
과적합 방지: 모델 복잡도를 줄여 일반화 성능 향상
계산 효율성 증대: 학습 속도 향상, 메모리 및 저장 공간 절약
시각화 용이: 2D 또는 3D로 데이터를 시각화하여 패턴 파악
차원의 저주 완화: 고차원 공간의 데이터 희소성과 거리 계산 문제 완화
불필요하거나 노이즈가 많은 특성을 제거해 성능 향상 가능
고려사항
차원 축소 과정에서 일부 정보 손실이 발생할 수 있음
특성 추출로 생성된 새 특성은 원래 특성의 의미를 직관적으로 해석하기 어려울 수 있음
예: 사람의 다양한 성격 특성을 외향적/내향적 등 몇 가지 차원으로 표현
여러 가지 차원 축소 기법
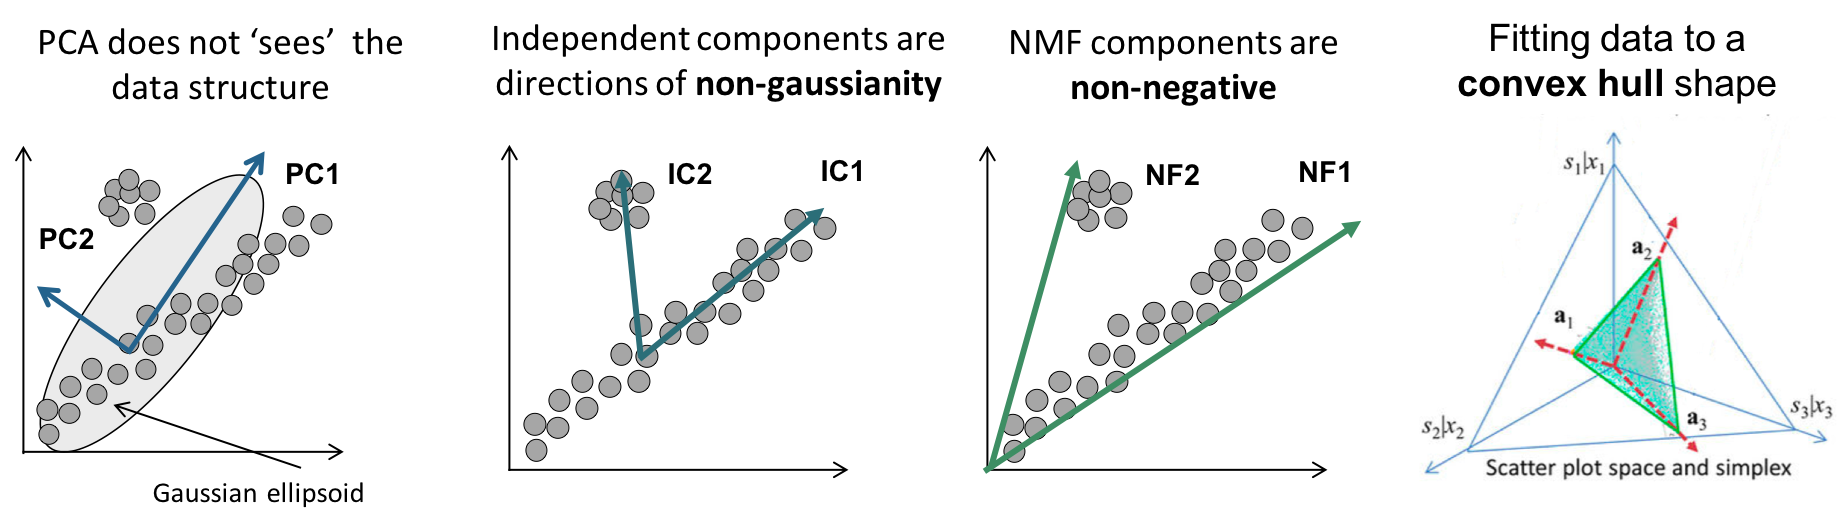
주성분 분석(Principal Component Analysis, PCA)
고차원 데이터를 저차원으로 변환하여 데이터의 분산을 최대한 보존
독립성분 분석(Independent Component Analysis, ICA)
관측 데이터가 여러 독립적인 신호의 혼합물로 구성되어 있다고 가정
비음행렬 분해(Non-Negative Matrix Factorization, NMF)
데이터 시각화를 위한 차원축소
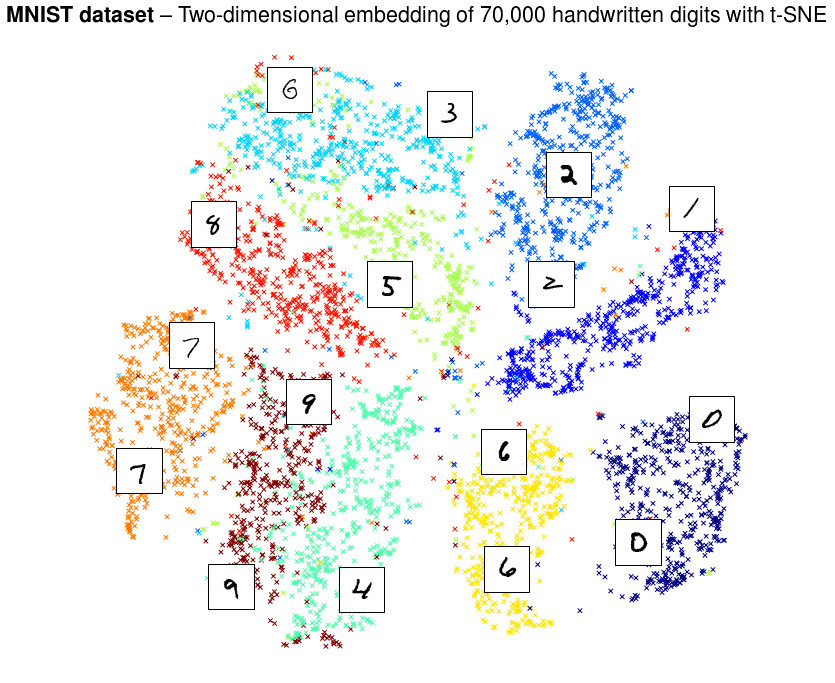
t-SNE(t-Distributed Stochastic Neighbor Embedding)
고차원 데이터의 부분적 특징을 보존하는 차원 축소 기법
시각화에 주로 사용
방법
고차원 공간에서 다변량 정규분포를 기반으로 유사성을 확률로 계산
저차원 공간에서 다변량 t분포를 기반으로 유사성을 확률로 계산
두 확률 분포의 차이를 KL 발산으로 측정
KL 발산이 최소화되도록 저차원 공간의 좌표를 결정
단점 및 해석상 주의점
계산 비용이 높음
같은 데이터셋에서도 실행할 때마다 다른 결과가 나올 수 있음
저차원 공간의 거리가 반드시 고차원 공간의 거리와 비례하지는 않음
비선형 차원 축소 기법
더 발전된 UMAP 기법도 사용됨
주성분 분석
주성분 분석(Principal Component Analysis, PCA)
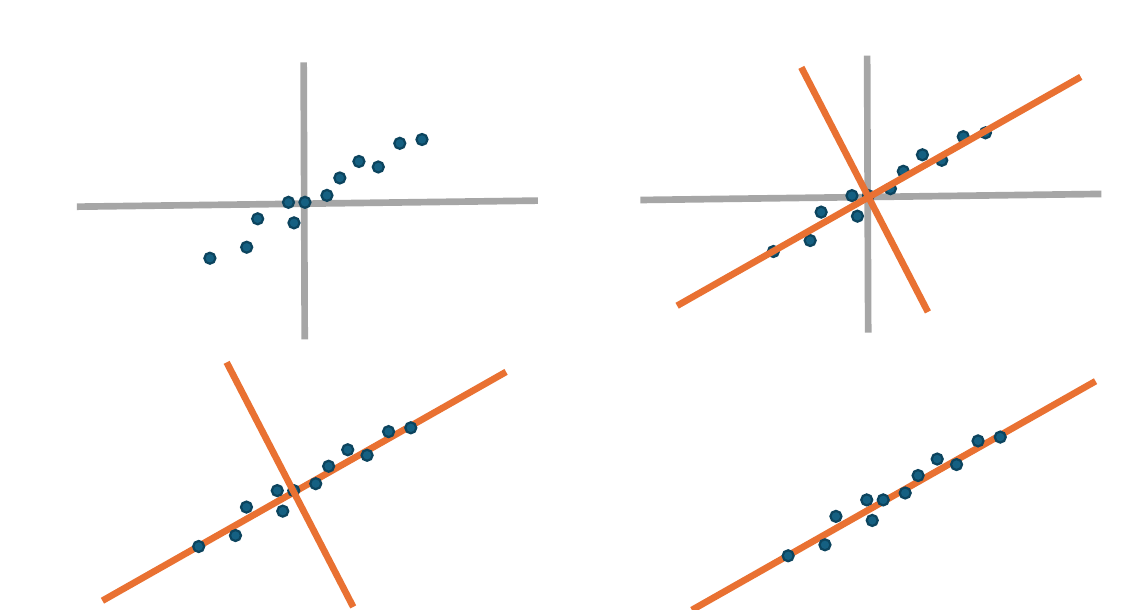
여러 변수가 함께 움직이는 방향을 새 축으로 만드는 방법
제1주성분(PC1): 데이터가 가장 크게 퍼지는 방향
제2주성분(PC2): PC1과 겹치지 않는 두 번째 방향
원래 변수들을 서로 상관이 적은 새 축으로 바꿔 표현
일부 정보 손실은 있지만 설명력으로 손실 정도 확인 가능
PCA 실습: 데이터 로딩
K-Means 실습과 같은 7개 운항 변수 사용
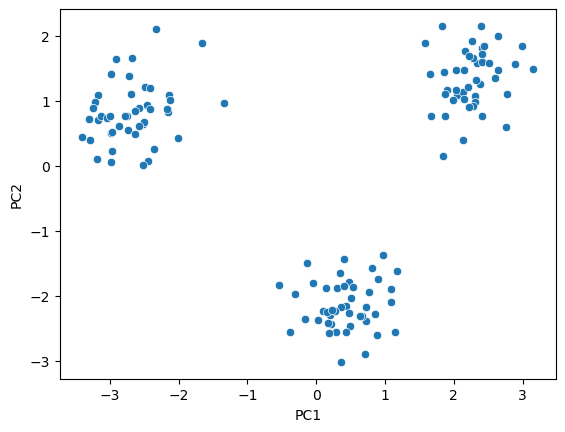
PCA로 PC1, PC2의 2차원으로 압축
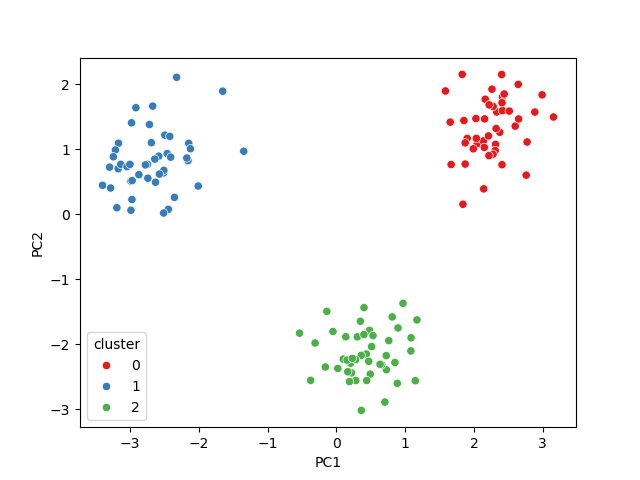
K-Means 군집 번호를 색상으로 표시해 군집 분리 정도 확인
import pandas as pd
import matplotlib.pyplot as plt
import seaborn as sns
from sklearn.cluster import KMeans
from sklearn.decomposition import PCA
from sklearn.preprocessing import StandardScaler
df_ship = pd.read_excel("ship_cluster.xlsx" )
PCA 실습: 변수 선택 및 표준화
feature_cols = [
"route_distance_nm" ,
"avg_payload_ton" ,
"daily_engine_hour" ,
"service_speed_knot" ,
"fuel_use_ton_day" ,
"port_stay_hour" ,
"maintenance_interval_day" ,
]
X_cluster = df_ship[feature_cols]
X_scaled = StandardScaler().fit_transform(X_cluster)
PCA 실습: PCA 실시
pca = PCA(n_components=2 )
pc = pca.fit_transform(X_scaled)
df_pca = df_ship.copy()
df_pca["PC1" ] = pc[:, 0 ]
df_pca["PC2" ] = pc[:, 1 ]
sns.scatterplot(data=df_pca, x="PC1" , y="PC2" )
PCA 실습: K-Means 시각화
kmeans = KMeans(n_clusters=3 , random_state=42 , n_init=10 )
df_pca["cluster" ] = kmeans.fit_predict(X_scaled)
sns.scatterplot(
data=df_pca,
x="PC1" ,
y="PC2" ,
hue="cluster" ,
palette="Set1" ,
)
분산 설명력
분산 설명력(Explained Variance Ratio)
각 주성분이 원래 데이터의 전체 정보 중 몇 퍼센트를 담는지 나타내는 지표
예: PC1이 60%, PC2가 20%를 설명하면 두 주성분만으로 원래 정보의 80%를 보존
실습 데이터는 PC1, PC2만으로 대부분의 구조 확인 가능
pca.explained_variance_ratio_
엘보우 방법
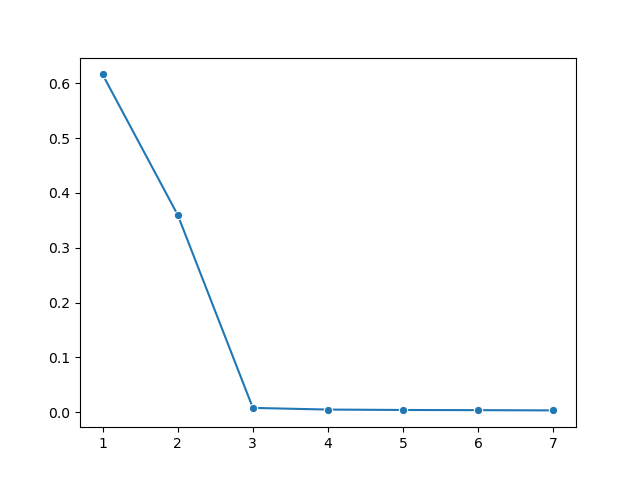
주성분 수를 늘려가며 각 성분이 설명하는 분량의 변화를 그래프로 시각화
설명력이 급격히 낮아지는 엘보우 지점을 주성분 개수 후보로 선택
일반적으로 누적 분산 설명력이 80~90%를 넘어서는 지점을 기준으로 판단
import numpy as np
pca_full = PCA().fit(X_scaled)
evr = pca_full.explained_variance_ratio_
sns.lineplot(x=range (1 , len (evr) + 1 ), y=evr, marker="o" )
np.cumsum(evr)
분산 설명력 결과 해석
실습 데이터는 PC1과 PC2로 약 97.6% 설명
2차원 산점도로 전체 구조 확인 가능
PC1, PC2 평면에서 세 군집이 뚜렷하게 분리
군집 결과를 눈으로 확인할 때 PCA 시각화 활용
차원 축소를 전처리로 사용할 때
PCA는 시각화뿐 아니라 모델 입력 변수 줄이기에도 사용
여러 운항 변수에서 몇 개 주성분을 만들고 예측 모델의 입력으로 사용 가능
설명력이 낮은 뒤쪽 주성분은 노이즈가 많을 수 있음
주의: 주성분은 원래 변수 의미와 바로 연결해 해석하기 어려움
실습 데이터: 설비 운전 상태 PCA
수업용 합성 설비 운전 기록 600건
단위와 범위가 다른 8개 센서·운전 변수로 PCA 수행
비표준화 PCA와 표준화 PCA의 분산 설명력 비교
operation_mode는 PCA 입력에서 제외하고 시각화 색상으로만 사용
컬럼 설명 motor_speed_rpm모터 회전 속도(rpm) torque_nm모터 토크(N·m) power_kw소비 전력(kW) vibration_mm_s진동 속도(mm/s) bearing_temp_c베어링 온도(°C) lubricant_temp_c윤활유 온도(°C) acoustic_db운전 소음(dB) coolant_flow_l_min냉각수 유량(L/min) operation_mode운전 모드(low_load, normal_load, high_load)
데이터 불러오기와 변수 선택
import pandas as pd
df_machine = pd.read_excel("machine_operation_pca.xlsx" )
feature_cols = [
"motor_speed_rpm" ,
"torque_nm" ,
"power_kw" ,
"vibration_mm_s" ,
"bearing_temp_c" ,
"lubricant_temp_c" ,
"acoustic_db" ,
"coolant_flow_l_min" ,
]
X_machine = df_machine[feature_cols]
다음 문제의 코드와 본문에서 사용한 PCA 코드를 실행하여 답하세요.