
클러스터링
비지도학습
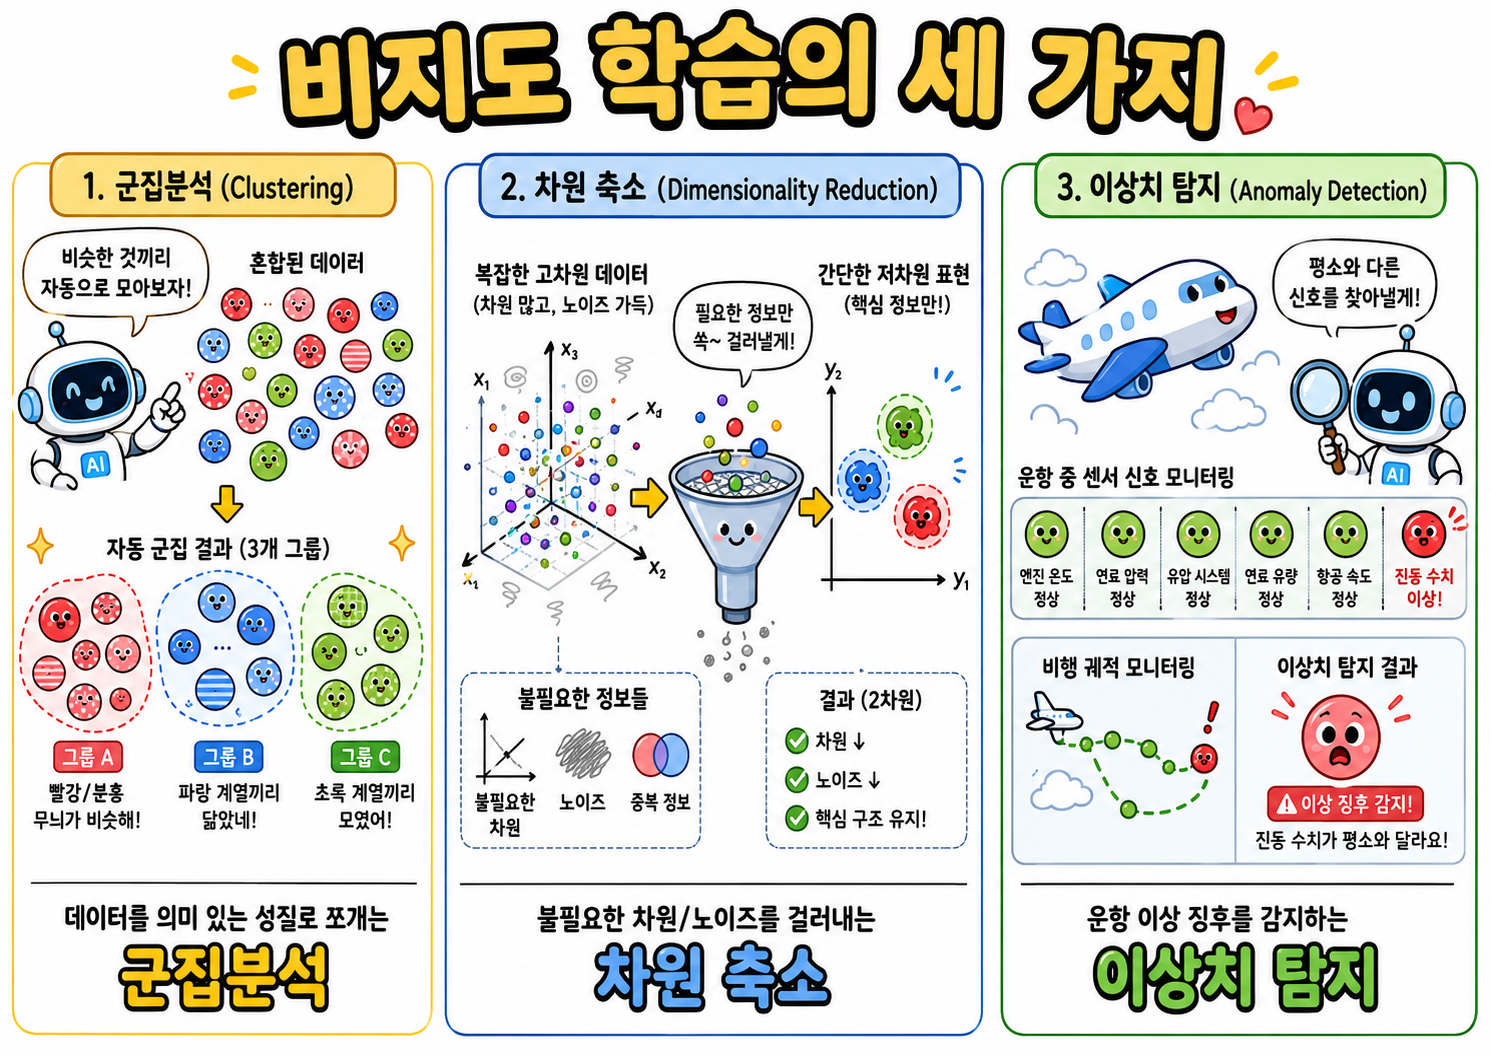
- 비지도학습(Unsupervised Learning): 정답 라벨 없이 변수만 있는 데이터 활용
- 예측보다 데이터 안의 숨은 구조와 반복 패턴 파악이 목적
- 주요 활용 분야
- 데이터를 의미 있는 성질로 쪼개는 군집분석(Clustering)
- 불필요한 차원/노이즈를 걸러내는 차원 축소(Dimensionality Reduction)
- 운항 이상 징후를 감지하는 이상치 탐지(Anomaly Detection)
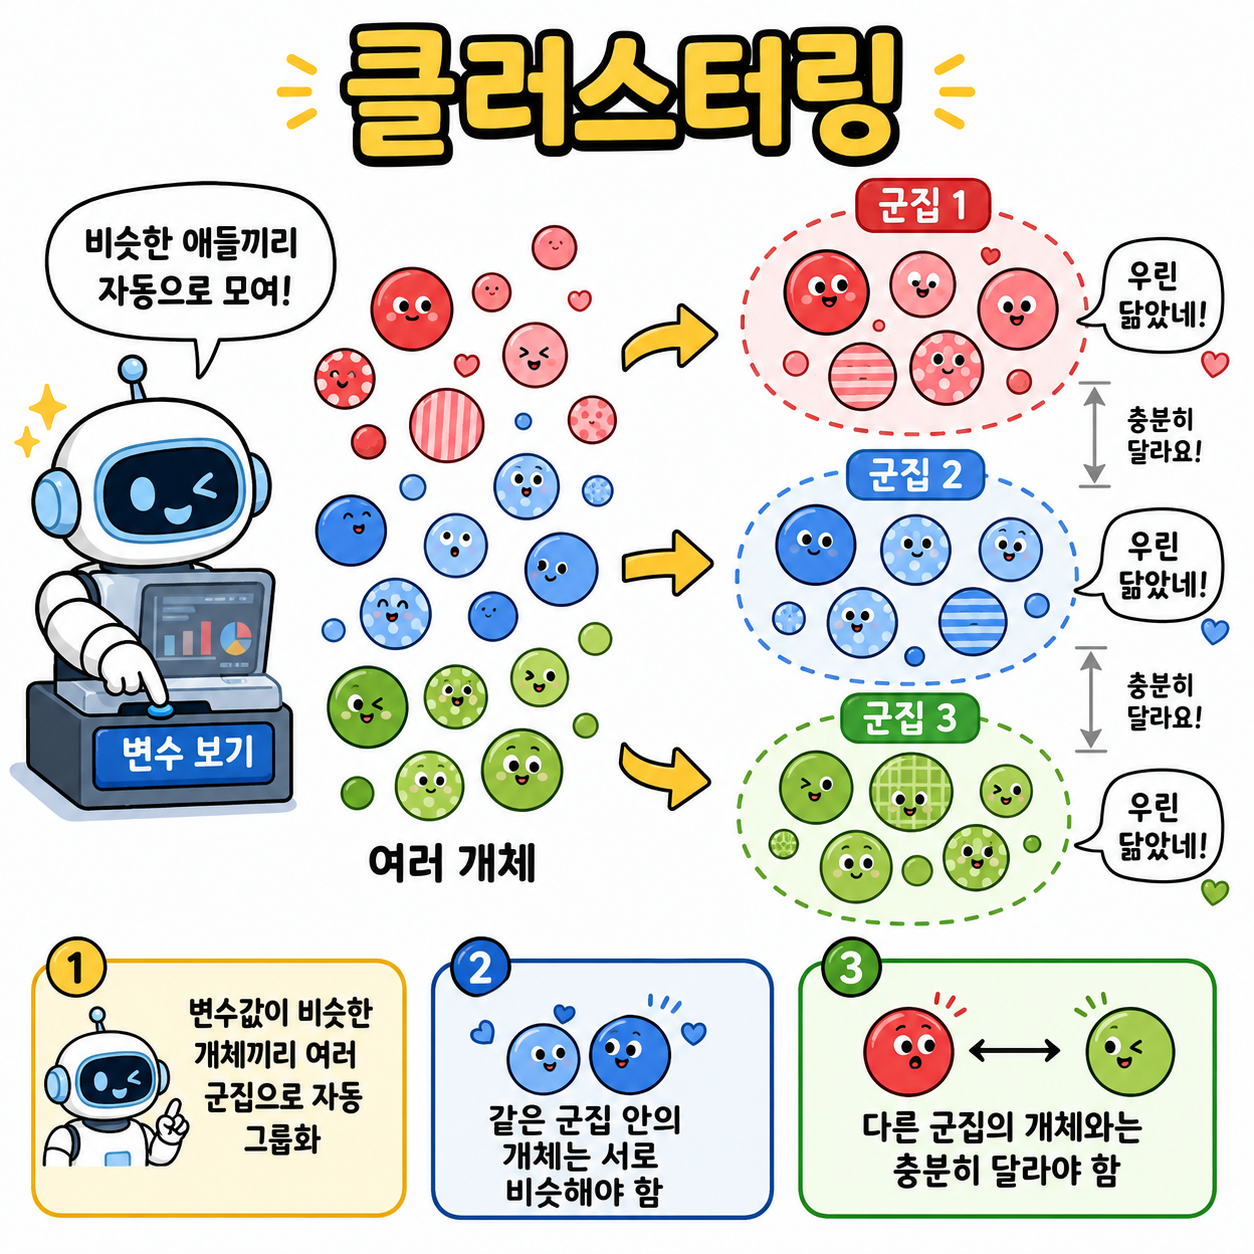
군집분석의 목적과 절차
- 변수값이 비슷한 개체끼리 여러 군집(Cluster)으로 자동 그룹화
- 같은 군집 안의 개체는 서로 비슷해야 함
- 다른 군집의 개체와는 충분히 달라야 함
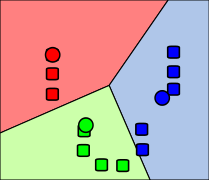
클러스터링의 종류
- 파티션(partition) 알고리즘: 수평적인 군집들로 나눔
- K-Means
- Mixture of Gaussian
- Spectral Clustering
- 위계적(hierarchical) 알고리즘: 큰 군집 안에 작은 군집들이 포함되는 형태로 나눔
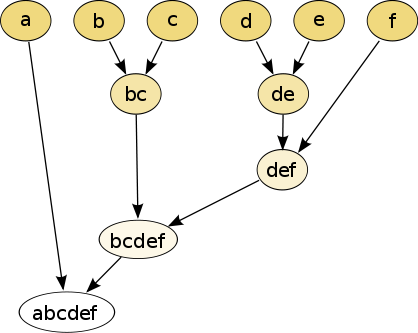
계층적 군집화
- 데이터를 단계적으로 묶어가며 군집 구조를 찾는 방법
- 군집 개수를 처음부터 꼭 정하지 않아도 됨
- 기본 방식
- 병합형: 각 데이터를 하나의 군집으로 시작해 가장 가까운 군집끼리 차례로 합침
- 분할형: 전체 데이터를 하나의 군집으로 시작해 점점 작은 군집으로 나눔
- 결과 표현
- 덴드로그램으로 군집이 합쳐지는 과정을 시각화
- 어느 높이에서 자르느냐에 따라 군집 개수가 달라짐
밀도 기반 군집화
- 데이터가 많이 모여 있는 밀집 영역을 군집으로 찾는 방법
- 대표 알고리즘: DBSCAN
- 기본 아이디어
- 가까운 이웃이 충분히 많은 점을 중심으로 군집을 형성
- 밀도가 낮은 지역의 점은 군집에 포함하지 않고 이상치로 볼 수 있음
- 주요 개념
- 반경: 주변 이웃을 찾는 거리 기준
- 최소 이웃 수: 군집 중심으로 인정되기 위한 최소 데이터 수
- 이상치: 어느 밀집 영역에도 속하지 않는 점
- 장점
- 군집 개수를 미리 정하지 않아도 됨
- 둥근 모양이 아닌 복잡한 형태의 군집도 찾을 수 있음
- 이상치 탐지에 유용
군집 결과 평가
- 분류와 달리 정답 라벨이 없는 상황에서 군집의 적절성을 판단
- 좋은 군집의 기준
- 같은 군집 안의 데이터는 서로 비슷해야 함
- 다른 군집의 데이터는 서로 달라야 함
- 군집 수가 너무 많거나 너무 적지 않아야 함
- 평가 방법
- 실루엣 계수: 같은 군집 안에서는 가깝고, 다른 군집과는 먼 정도를 평가
- 해석 가능성: 각 군집이 실제 업무나 도메인 지식으로 설명 가능한지 확인
퀴즈
비지도학습에 대한 설명으로 가장 적절한 것은?
퀴즈를 풀려면 대화형 기능을 불러와야 합니다.