로지스틱 회귀분석
입력의 선형 결합을 불량 확률로 바꾸는 로지스틱 회귀 분류 실습
숫자의 선형 결합을 확률로 바꾸기
- 로지스틱 회귀분석(logistic regression): 입력 변수를 가중합한 점수를 바탕으로 양성 확률을 계산하는 분류 모델
- 이름에 회귀가 들어가지만 이 실습의 예측 대상은 불량 여부라는 범주
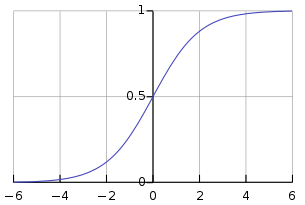
로지스틱 함수
p=P(y=1∣X)=1+exp(−z)1
- b0: 절편, b1,b2,b3: 입력 변수의 계수
- 로지스틱 함수: 어떤 실수 z도 0과 1 사이의 값으로 변환
- z=0이면 p=0.5. z가 커질수록 불량 확률 증가
- 확률 예측과 클래스 결정은 별개 단계. 확률을 문턱값과 비교해 최종 클래스 결정
Python으로 로지스틱 함수 계산
- 함수의 입력
z: 입력 변수들을 선형 결합한 값 math.exp(-z): 수식의 exp(−z) 계산
import math

def logistic(z):
    return 1 / (1 + math.exp(-z))
logistic(-1) # z = -1일 때의 양성 확률
실행 결과
0.2689414213699951
logistic(0) # z = 0일 때의 양성 확률
실행 결과
0.5
logistic(2) # z = 2일 때의 양성 확률
실행 결과
0.8807970779778823
- 입력값이 -1, 0, 2로 커질 때 양성 확률은 각각 약 26.9%, 50%, 88.1%로 증가
실습 프롬프트
🤖 AI 프롬프트
electronic_parts.xlsx를 불러와서 로지스틱 회귀분석으로 분류하는 코드를 작성해줘.
타깃은 defective이며 0은 정상, 1은 불량이야. 나머지 변수는 입력 변수로 사용해.
학습·검증·테스트 데이터를 60%·20%·20%로 나눠 줘.
학습 데이터로 학습하고 계수와 절편을 출력해줘.
테스트 데이터로 선택된 나무의 최종 테스트 정확도를 확인해 줘.
각 단계에 초보자를 위한 한글 주석을 달아줘.
모델 학습
LogisticRegression: 입력 변수의 선형 결합을 불량 확률로 바꾸는 분류 모델fit()에 훈련 데이터의 입력 변수와 정답 전달
from sklearn.linear_model import LogisticRegression

model = LogisticRegression(
    solver="liblinear",  # 이진 분류에 사용할 최적화 방법
    max_iter=1000,       # 최적화 반복 횟수의 상한
    random_state=42,
)
model.fit(X_train, y_train)
실행 결과
LogisticRegression(max_iter=1000, random_state=42, solver='liblinear')
학습한 계수
coef_: 입력 변수의 계수- 양의 계수: 다른 입력이 같을 때 그 변수의 값이 커질수록 예측 불량 확률 증가
- 다른 입력이 같을 때 해당 변수가 원래 단위로 1 증가하면 선형 결합 z가 계수만큼 변화
pd.Series(model.coef_[0], index=features)
실행 결과
exposure_hours         0.178420
humidity               0.033656
contamination_index    0.024087
dtype: float64
- 세 계수 모두 양수. 이 데이터에서 세 입력 변수의 값이 클수록 예측 불량 확률이 커지는 관계
- 계수는 확률 자체의 변화량이 아님. 같은 계수라도 출발 확률에 따라 확률 변화가 달라짐
model.intercept_[0] # 입력값이 모두 0일 때의 절편
실행 결과
np.float64(-5.248848545277525)
- 절편은 음수. 즉, 모든 입력 변수가 0이면 z=-5.24로, 확률로 변환하면 0%에 가까움.
테스트 정확도
- 학습에 사용하지 않은 테스트 데이터에서 평가
from sklearn.metrics import accuracy_score

y_pred = model.predict(X_test)
accuracy_score(y_test, y_pred)
실행 결과
0.743
퀴즈
이 실습에서 로지스틱 회귀분석은 어떤 문제를 해결하는 모델인가요?
퀴즈를 풀려면 대화형 기능을 불러와야 합니다.