훈련 성능과 실전 성능의 차이
- 훈련 성능: 모델이 이미 본 데이터에 대한 성능
- 테스트 성능: 모델이 처음 보는 데이터에 대한 성능
- 업무 적용에서는 테스트 성능이 더 중요
- 훈련 성능만 높으면 실제 데이터에서 실패 가능
- 실습 전제: 앞 장의 California Housing
X, y, X_train, X_test 사용
편향과 분산의 교환
- 모형의 귀납 편향: 데이터의 구조에 대한 모형의 가정
- 예: 선형 모형은 데이터가 직선 패턴을 가질 것으로 가정
- 머신러닝 모형은 이러한 가정 아래 훈련 데이터의 패턴을 일반화
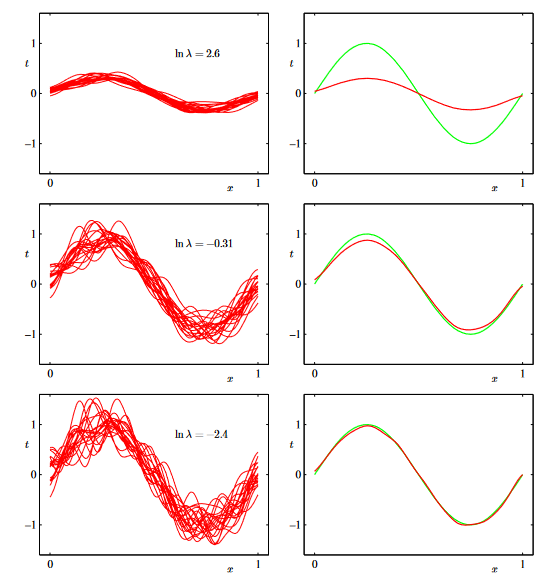
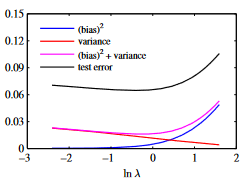
- 편향-분산 교환(bias-variance trade-off)
- 편향이 강하면 분산이 작아짐
- 학습 데이터셋에 따라 결과가 크게 달라지지 않음
- 작은 데이터셋에서 성능이 좋음
- 편향이 약하면 분산이 커짐
- 학습 데이터셋에 따라 결과가 크게 달라짐
- 큰 데이터셋에서 성능이 좋음
과대적합과 과소적합
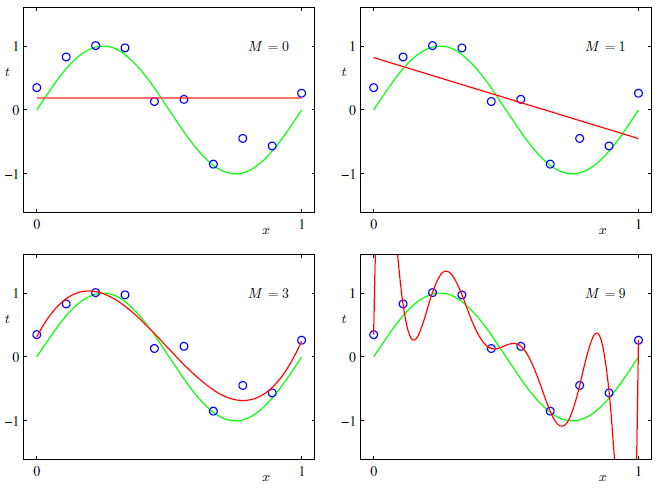
- 과대적합(overfitting): 훈련 데이터의 세부 패턴과 잡음까지 외운 상태
- 훈련 점수는 높지만 테스트 점수는 낮음
- 데이터가 조금 바뀌면 예측이 불안정
- 복잡한 모델일수록 과대적합 가능성 증가
- 과소적합(underfitting): 모델이 너무 단순해 중요한 패턴도 잡지 못한 상태
- 훈련 점수와 테스트 점수가 모두 낮음
- 데이터의 기본 관계를 충분히 반영하지 못함
- 모델 복잡도를 조금 높이거나 변수를 보강할 필요
정칙화
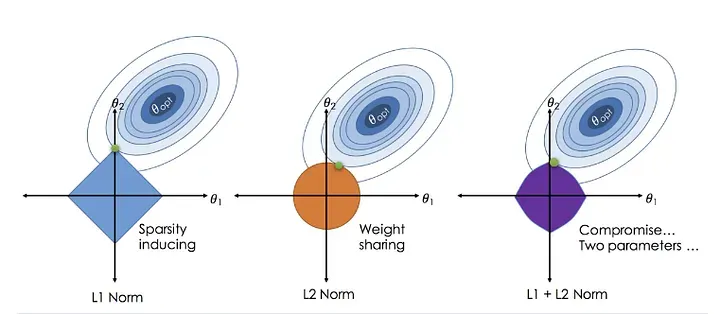
- 정칙화(regularization): 모델이 너무 복잡해지지 않도록 제약을 주는 방법
- 목적: 훈련 데이터의 우연한 잡음보다 반복되는 패턴에 집중
- 모델별 정칙화 예
- 결정트리:
max_depth, min_samples_leaf로 분기 수 제한
- 선형 회귀: 계수 크기에 벌점을 주어 과도한 계수 억제
- Ridge: 큰 계수를 전반적으로 작게 만듦
- Lasso: 중요하지 않은 계수를 0에 가깝게 만듦
- KNN:
n_neighbors를 키워 예측을 더 부드럽게 만듦
- 정칙화 강도는 검증 성능을 보며 조절
깊은 결정트리의 과대적합 확인
- 깊이 제한이 없는 트리는 훈련 데이터를 매우 자세히 분할
- 훈련 데이터에서는 거의 완벽한 성능 가능
- 테스트 데이터에서는 성능 하락 가능
deep_tree = DecisionTreeRegressor(random_state=42)
deep_tree.fit(X_train, y_train)

deep_tree.score(X_train, y_train)
deep_tree.score(X_test, y_test)
max_depth로 복잡도 제한
max_depth: 트리의 최대 깊이 제한- 작은 깊이는 단순한 모델
- 큰 깊이는 복잡한 모델
- 적절한 제한은 테스트 성능 안정화에 도움
limited_tree = DecisionTreeRegressor(max_depth=6, random_state=42)
limited_tree.fit(X_train, y_train)

limited_tree.score(X_train, y_train)
limited_tree.score(X_test, y_test)
선형 회귀의 정칙화
- 일반 선형 회귀는 계수 크기에 별도 제한 없음
- Ridge와 Lasso는 계수가 지나치게 커지는 상황 억제
alpha: 정칙화 강도
- 작을수록 일반 선형 회귀에 가까움
- 클수록 더 강하게 단순화
- 선형 모델 정칙화는 표준화 후 적용 권장
Ridge와 Lasso 실습
- 같은 데이터에서 일반 선형 회귀, Ridge, Lasso 비교
- 훈련 점수와 테스트 점수의 차이 함께 확인
from sklearn.linear_model import LinearRegression, Ridge, Lasso
from sklearn.metrics import mean_absolute_error, r2_score

model = Ridge(alpha=1.0)

model.fit(X_train, y_train)
train_pred = model.predict(X_train)
r2_score(y_train, train_pred)

test_pred = model.predict(X_test)
r2_score(y_test, test_pred)
KNN의 정칙화
- KNN은 가까운 사례를 기준으로 예측
n_neighbors가 작으면 주변 몇 개 사례에 민감
- 훈련 데이터에는 잘 맞지만 잡음까지 따라갈 수 있음
n_neighbors가 크면 더 많은 사례 평균 사용
하이퍼파라미터 튜닝
- 하이퍼파라미터(hyperparameter): 학습 전에 사람이 정하는 설정값
- 예:
max_depth, alpha, n_neighbors
- 튜닝: 여러 설정을 시험해 검증 성능이 좋은 값 선택
- 테스트 데이터로 하이퍼파라미터를 튜닝하면 테스트에 맞춘 모델이 됨
- 검증 데이터(validation dataset): 모델 선택과 튜닝에 사용하는 중간 평가 데이터
- 테스트 데이터는 최종 테스트에서 한 번만 사용하고 버림
교차검증 개념
- 교차검증(cross validation): 데이터를 여러 번 나누어 반복 평가
- 한 번의 테스트 분할에 따른 우연을 줄이는 방법
- 각 분할의 평균과 변동성 함께 확인
- 데이터가 많지 않을 때 특히 유용
GridSearchCV로 자동 튜닝
GridSearchCV: 후보 설정을 자동으로 반복 평가- 내부에서 교차검증 수행
- 가장 좋은 하이퍼파라미터와 최종 테스트 점수 확인 가능
from sklearn.model_selection import GridSearchCV

param_grid = {
    'kneighborsregressor__n_neighbors': [3, 5, 7, 11, 21],
    'kneighborsregressor__weights': ['uniform', 'distance']
}
knn_search = GridSearchCV(
    make_pipeline(StandardScaler(), KNeighborsRegressor()),
    param_grid=param_grid,
    cv=5,
    scoring='r2'
)

knn_search.fit(X_train, y_train)
knn_search.best_params_
실습 데이터: 사출성형 제품의 인장강도
- 사출성형 공정 조건을 기록한 수업용 합성 생산 데이터 600건
- 공정 조건으로 제품의 인장강도 예측
- 중복 센서와 약한 변수를 포함하여 정칙화 효과 확인 가능
- 모든 입력 변수가 숫자형이므로 앞에서 사용한 회귀 코드 적용 가능
- 인장강도 단위: MPa
| 컬럼 | 설명 |
|---|
resin_temp_c | 수지 온도(°C) |
mold_temp_c | 금형 온도(°C) |
injection_pressure_mpa | 사출 압력(MPa) |
holding_pressure_mpa | 보압(MPa) |
injection_speed_mm_s | 사출 속도(mm/s) |
cooling_time_sec | 냉각 시간(초) |
screw_speed_rpm | 스크루 회전 속도(rpm) |
resin_moisture_pct | 수지 수분율(%) |
cycle_time_sec | 전체 공정 시간(초) |
ambient_humidity_pct | 작업장 습도(%) |
resin_temp_sensor_b_c | 보조 센서의 수지 온도(°C) |
pressure_sensor_b_mpa | 보조 센서의 사출 압력(MPa) |
machine_vibration_mm_s | 설비 진동(mm/s) |
sensor_drift_mv | 센서 오프셋(mV) |
tensile_strength_mpa | 제품 인장강도(MPa) |
데이터 불러오기와 X, y 선택
import pandas as pd

df_molding = pd.read_excel("injection_molding_strength.xlsx")
df_molding.head()
X = df_molding.drop(columns="tensile_strength_mpa")
y = df_molding["tensile_strength_mpa"]
from sklearn.model_selection import train_test_split

X_train, X_test, y_train, y_test = train_test_split(
    X,
    y,
    test_size=0.2,
    random_state=42,
)
