
문턱값
검증 F1이 가장 높은 문턱값을 선택하고 테스트 데이터로 분류 성능 평가
확률을 클래스로 바꾸는 기준
- 문턱값(threshold): 양성 확률을 양성·음성 예측으로 바꾸는 기준
- 불량 확률(p)이 문턱값(t) 이상이면
1, 미만이면0 - 같은 확률에서도 문턱값을 바꾸면 FP, FN, TP, TN과 평가 지표가 달라짐
예측 확률 계산
predict_proba(): 학습한 모델로 검증·테스트 데이터의 클래스별 확률 계산classes_의 순서가[0, 1]인 모델에서[:, 1]은 불량 확률
from sklearn.metrics import (
    accuracy_score, confusion_matrix, f1_score,
    precision_score, recall_score,
)

prob_valid = model.predict_proba(X_valid)[:, 1]
prob_test = model.predict_proba(X_test)[:, 1]
문턱값 0.5의 혼동행렬
- 테스트 사례에서 문턱값 0.5의 예측 확인.
.astype(int): 참거짓을 정수로 변환.- 참(
True)은1, 거짓(False)은0으로 변환
- 참(
y_pred_05 = (prob_test >= 0.5).astype(int)
confusion_matrix(y_test, y_pred_05, labels=[0, 1])
실행 결과
array([[1200,  157],
       [ 357,  286]])
- 불량으로 예측한 443개 중 실제 불량 부품 286개: 정밀도 약 64.6%
- 실제 불량 부품 643개 중 찾아낸 286개: 재현도 약 44.5%
문턱값에 따른 변화
- 정상 8개·불량 8개의 설명용 예시. 각 부품의 정답과 예측 확률을 고정하고 문턱값만 변경
N1–N8: 실제 정상 부품,D1–D8: 실제 불량 부품. 같은 표시의 부품이 어느 칸으로 이동하는지 비교
문턱값 높임
- 양성 예측이 줄어 TP와 FP가 줄어드는 경향
- 애매한 케이스가 줄기 때문에 TP보다 FP가 더 빨리 줄어들 수 있다
- 재현도: TP/(TP+FN)이므로 낮아지는 경향
- 특이도: TN/(TN+FP)이므로 높아지는 경향
- 정밀도: TP/(TP+FP)이므로 높아지는 경향
문턱값 낮춤
- 양성 예측이 늘어 TP와 FP가 늘어나는 경향
- 애매한 케이스가 늘기 때문에 TP보다 FP가 더 빨리 늘어날 수 있다
- 재현도: TP/(TP+FN)이므로 높아지는 경향
- 특이도: TN/(TN+FP)이므로 낮아지는 경향
- 정밀도: TP/(TP+FP)이므로 낮아지는 경향
실습 프롬프트
🤖 AI 프롬프트
앞서 학습한 로지스틱 회귀 모델로 검증 데이터에서 문턱값을 바꿔 가며 평가지표를 출력하고 그래프로 그려줘.
검증 F1이 가장 높은 문턱값을 선택한 뒤, 그 문턱값으로 테스트 데이터의 평가지표를 계산해줘.
검증 데이터의 문턱값별 지표
- 모델을 다시 학습하지 않고 검증 확률에 적용할 기준만 변경
zero_division=0: 양성 예측이 없는 경우 정밀도를 0으로 기록하는 계산 규칙
import numpy as np
import pandas as pd

thresholds = np.linspace(0.1, 0.9, 81)  # 양 끝을 포함해 0.01 간격으로 탐색
rows = []
for t in thresholds:
    pred = (prob_valid >= t).astype(int)
    rows.append({
        "threshold": t,
        "accuracy": accuracy_score(y_valid, pred),
        "precision": precision_score(y_valid, pred, zero_division=0),
        "recall": recall_score(y_valid, pred),
        "specificity": recall_score(y_valid, pred, pos_label=0),
        "f1": f1_score(y_valid, pred),
    })

metrics = pd.DataFrame(rows).set_index("threshold")
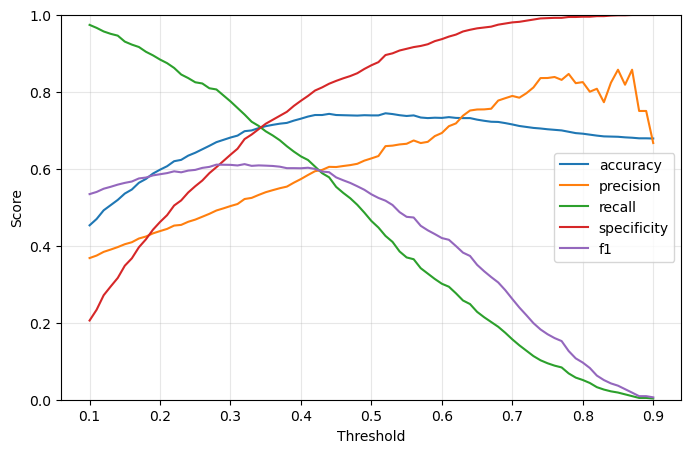
metrics.iloc[[20, 40, 60]]  # 문턱값 0.3, 0.5, 0.7 비교
실행 결과
           accuracy  precision    recall  specificity        f1
threshold
0.3          0.6810   0.503024  0.774845     0.636431  0.610024
0.5          0.7385   0.626834  0.464286     0.868732  0.533452
0.7          0.7150   0.789062  0.156832     0.980088  0.261658
- 낮은 문턱값에서 불량 부품을 더 많이 찾지만 위양성도 증가
- 높은 문턱값에서 불량 예측의 정밀도는 높아지지만 많은 불량 부품을 놓치는 결과
import matplotlib.pyplot as plt

metrics.plot(figsize=(8, 5))
plt.xlabel("Threshold")
plt.ylabel("Score")
plt.ylim(0, 1)
plt.grid(alpha=0.3)
검증 F1이 가장 높은 문턱값 선택
- 정밀도와 재현도를 함께 고려하려는 예시로 F1 사용
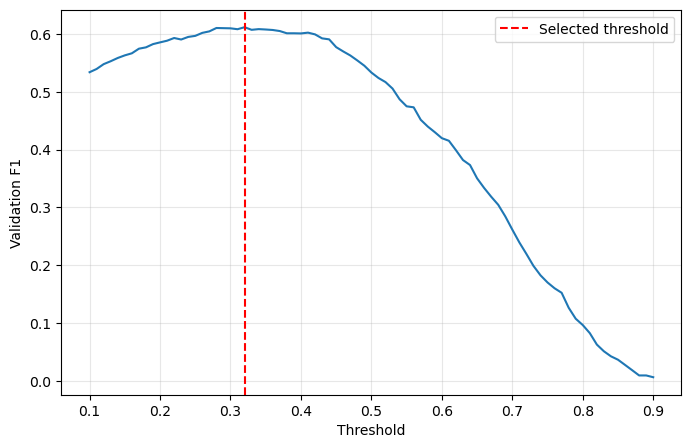
idxmax(): 가장 큰 값이 있는 인덱스 반환. 동률이면 먼저 나온 낮은 문턱값 선택- 검증 데이터의 탐색 범위 안에서 선택한 값. 목적에 따라 재현도나 오류 비용 등 다른 기준도 가능
best_threshold = metrics["f1"].idxmax()
best_threshold
실행 결과
np.float64(0.32)
metrics.loc[best_threshold, "f1"] # 검증 F1
실행 결과
np.float64(0.6119307248236049)
plt.figure(figsize=(8, 5))
plt.plot(metrics.index, metrics["f1"])
plt.axvline(best_threshold, color="red", linestyle="--", label="Selected threshold")
plt.xlabel("Threshold")
plt.ylabel("Validation F1")
plt.legend()
plt.grid(alpha=0.3)
선택한 문턱값의 테스트 평가
- 검증 데이터에서 선택을 마친 뒤 고정된 문턱값으로 테스트 평가
- 비교 대상은 기본 문턱값 0.5. 아래 결과를 보고 다시 문턱값을 고르지 않음
test_rows = []
for t in [0.5, best_threshold]:
    pred = (prob_test >= t).astype(int)
    test_rows.append({
        "threshold": t,
        "accuracy": accuracy_score(y_test, pred),
        "precision": precision_score(y_test, pred, zero_division=0),
        "recall": recall_score(y_test, pred),
        "f1": f1_score(y_test, pred),
    })

pd.DataFrame(test_rows).set_index("threshold")
실행 결과
           accuracy  precision    recall        f1
threshold
0.50          0.743   0.645598  0.444790  0.526703
0.32          0.696   0.519729  0.716952  0.602614
- 선택한 기준에서는 재현도와 F1이 높아지고 정밀도와 정확도는 낮아지는 결과
퀴즈
문턱값을 높일 때 대체로 높아지는 경향이 있는 지표를 고르세요
퀴즈를 풀려면 대화형 기능을 불러와야 합니다.