의사결정 나무
여러 입력 변수에 질문을 던지고 잎의 평균으로 숫자를 예측하는 의사결정나무 회귀
질문으로 예측하기
- 의사결정나무(decision tree): 질문으로 사례를 둘로 나누는 과정을 반복하는 모델
- 질문 지점(node): 한 입력 변수의 값이 문턱값보다 작거나 같은지 확인하는 곳
- 가지(branch): 질문의 답에 따라 이동하는 경로
- 잎(leaf): 질문이 끝나고 최종 예측값을 내는 곳
스무고개와 비슷한 구조. 한 번에 하나의 입력 변수를 확인하고, 답에 따라 사례의 범위를 점차 축소.
나무가 질문을 고르는 방법
나무가 검토하는 질문의 예:
- 통학 시간이 30분 이하인가?
- 월세가 80만 원 이하인가?
- 소음 수준이 3 이하인가?
각 질문으로 훈련 사례를 두 집단으로 분할(split). 분할 뒤 각 집단 안의 만족도 차이가 작아지는 질문을 우선 선택.
회귀나무의 잎에 도착한 뒤 사용하는 값은 그 잎에 모인 훈련 사례의 타깃 y 평균.
실습 프롬프트
🤖 AI 프롬프트
housing.xlsx의 data 시트로 주거 만족도를 예측하는 의사결정나무를 만들어줘.
통학 시간·월세·소음 수준을 입력으로, score를 타깃으로 사용해.
학습 후, 질문 규칙을 텍스트와 그림으로 보여줘.
cases.xlsx의 새 사례에 대한 만족도를 예측해 표에 추가하고,
파이썬 코드와 초보자를 위한 한글 주석을 작성해줘.
얕은 나무 학습
from sklearn.tree import DecisionTreeRegressor

model = DecisionTreeRegressor(
    max_depth=3,          # 질문을 최대 세 단계로 제한
    min_samples_leaf=12,  # 한 잎에 남길 최소 사례 수
    random_state=42,      # 같은 조건에서 같은 결과 재현
)
model.fit(X, y)
실행 결과
DecisionTreeRegressor(max_depth=3, min_samples_leaf=12, random_state=42)
max_depth=3: 뿌리에서 잎까지 질문을 최대 세 번 사용min_samples_leaf=12: 각 잎에 훈련 사례를 최소 12개 유지fit(X, y): 세 입력 변수와 만족도의 관계 학습
학습한 질문 확인
from sklearn.tree import export_text

tree_rules = export_text(model, feature_names=features)
print(tree_rules)
실행 결과
|--- commute <= 41.50
|   |--- noise <= 3.50
|   |   |--- rent <= 83.00
|   |   |   |--- value: [83.20]
|   |   |--- rent >  83.00
|   |   |   |--- value: [72.18]
|   |--- noise >  3.50
|   |   |--- rent <= 74.50
|   |   |   |--- value: [68.33]
|   |   |--- rent >  74.50
|   |   |   |--- value: [55.73]
|--- commute >  41.50
|   |--- noise <= 3.50
|   |   |--- rent <= 90.50
|   |   |   |--- value: [65.52]
|   |   |--- rent >  90.50
|   |   |   |--- value: [55.21]
|   |--- noise >  3.50
|   |   |--- rent <= 90.00
|   |   |   |--- value: [50.58]
|   |   |--- rent >  90.00
|   |   |   |--- value: [40.14]
- 첫 질문: 통학 시간이 41.5분 이하인지 확인
- 두 번째 질문: 각 가지에서 소음 수준이 3.5 이하인지 확인
- 세 번째 질문: 월세를 기준으로 다시 분할
- 최종 구조: 깊이 3, 잎 8개
첫 번째 잎으로 가는 경로:
통학 시간 ≤ 41.5분
→ 소음 수준 ≤ 3.5
→ 월세 ≤ 83만 원
→ 만족도 83.20점 예측
value: [83.20]은 이 잎에 모인 훈련 사례의 평균 만족도. 세 조건을 모두 만족하는 새 사례도 같은 값으로 예측.
새로운 사례 예측
cases = pd.read_excel("cases.xlsx", sheet_name="cases")
cases.head()
실행 결과
   commute  rent  noise
0       15    60      1
1       35    85      3
2       55   110      5
cases.xlsx에는 입력 변수만 존재. 아직 만족도나 예측값이 없는 상태.
cases["prediction"] = model.predict(cases)
cases
실행 결과
   commute  rent  noise  prediction
0       15    60      1   83.197674
1       35    85      3   72.177500
2       55   110      5   40.142105
prediction 열에 나무가 예측한 만족도 추가.
- 첫 사례: 통학 15분, 월세 60만 원, 소음 1 → 만족도 약 83.2점
- 둘째 사례: 통학 35분, 월세 85만 원, 소음 3 → 만족도 약 72.2점
- 셋째 사례: 통학 55분, 월세 110만 원, 소음 5 → 만족도 약 40.1점
각 예측값은 계산식으로 세 값을 더한 결과가 아니라, 질문에 답하며 도착한 잎의 평균.
나무 시각화
import matplotlib.pyplot as plt
from sklearn.tree import plot_tree

plt.figure(figsize=(16, 8))  # 넓은 나무가 잘 보이도록 크기 지정
plot_tree(
    model,                    # 시각화할 학습된 나무
    feature_names=features,   # 질문에 표시할 입력 변수 이름
    filled=True,              # 예측값에 따라 노드 색상 표시
    rounded=True,             # 노드 상자의 모서리를 둥글게 표시
    precision=1,              # 숫자를 소수점 한 자리까지 표시
)
plt.show()
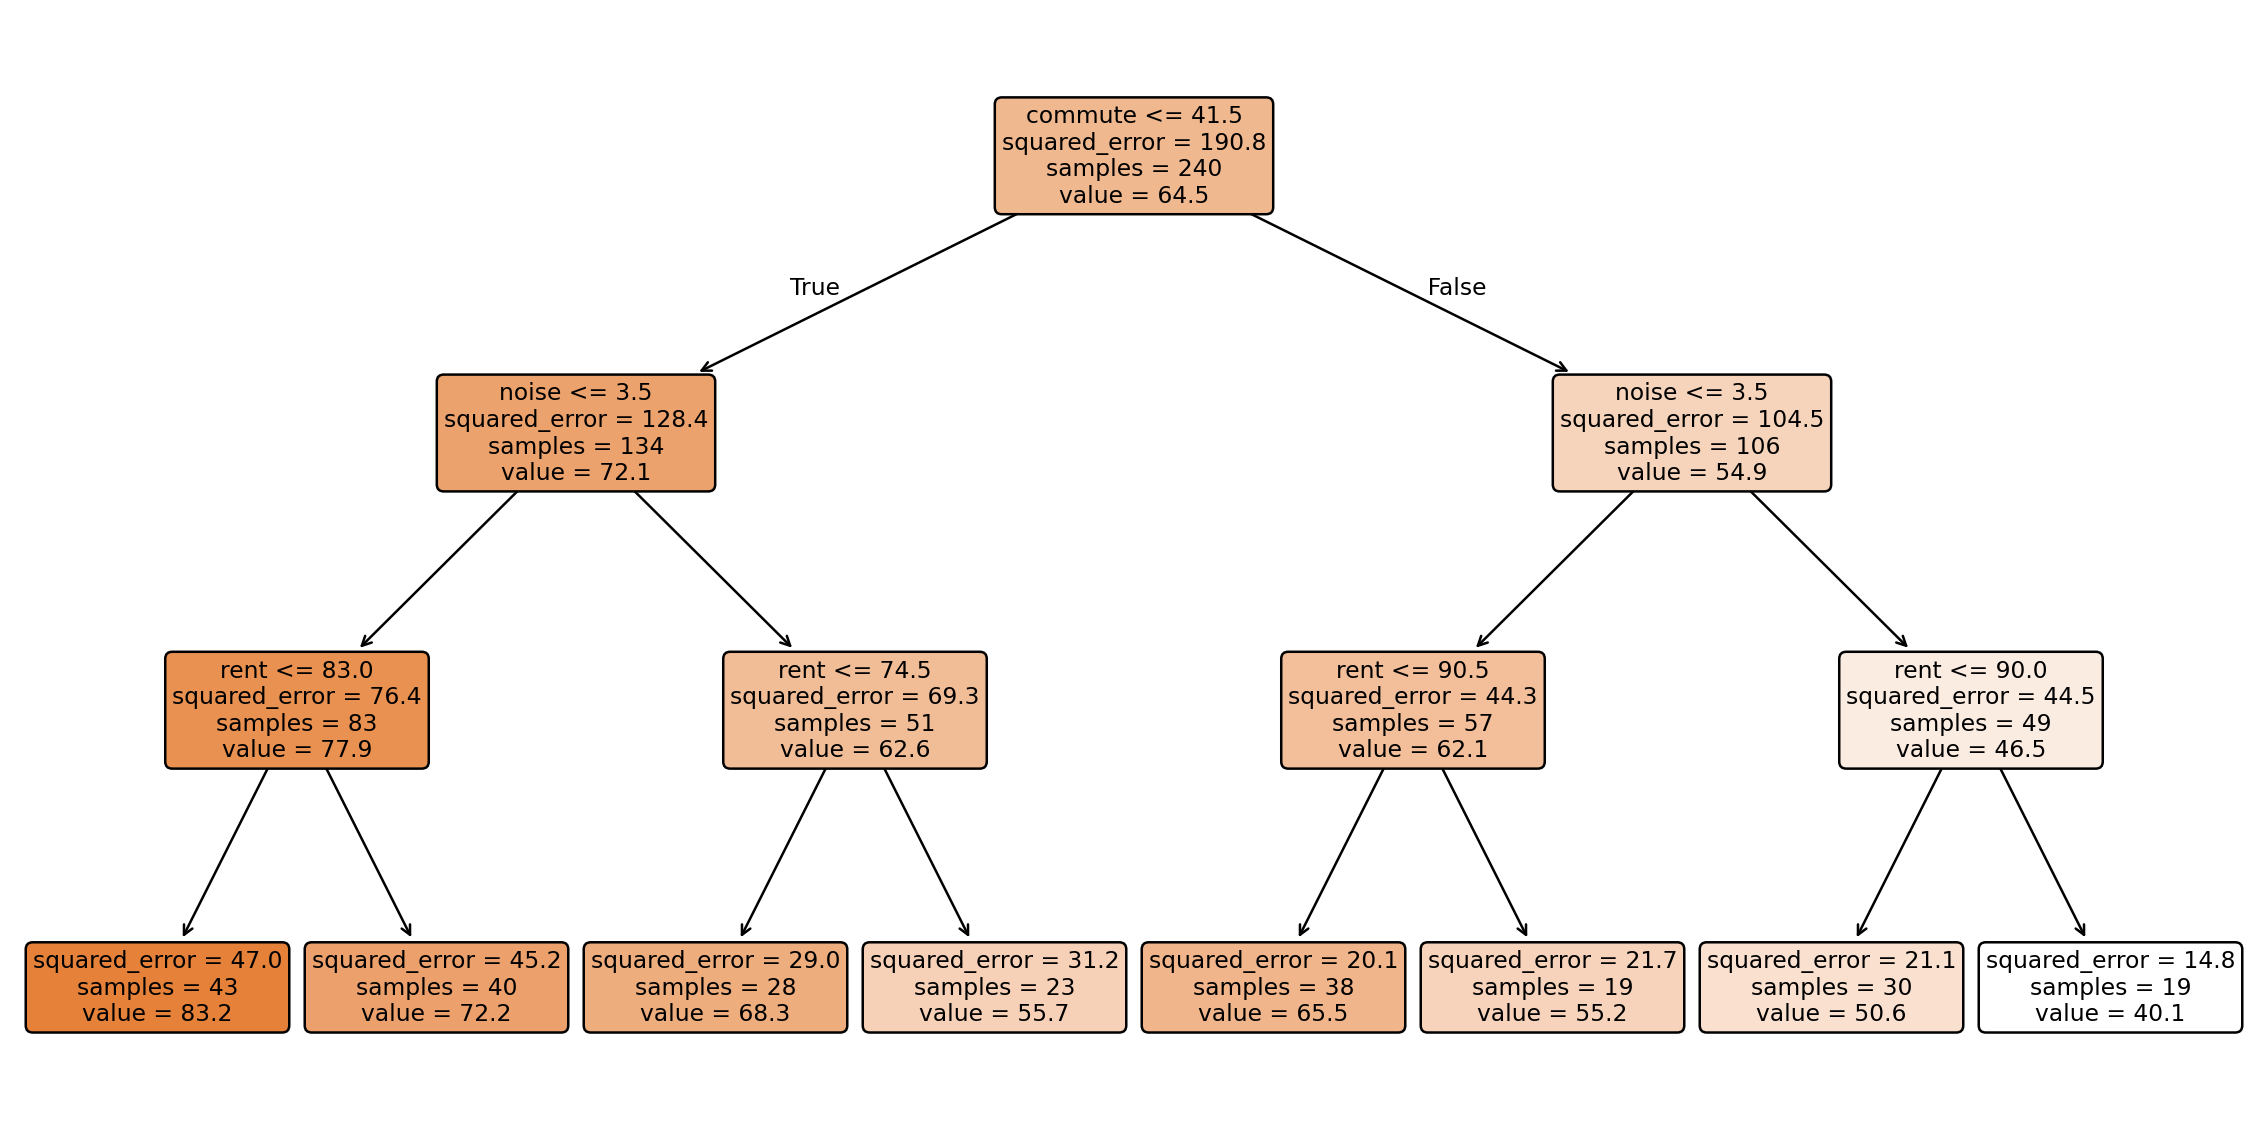
- 위쪽 상자: 첫 질문이 있는 뿌리(root)
- 왼쪽 가지: 질문의 조건을 만족하는 사례
- 오른쪽 가지: 질문의 조건을 만족하지 않는 사례
samples: 해당 지점에 도착한 훈련 사례 수value: 해당 지점에 모인 사례의 평균 만족도
나무의 깊이
- 얕은 나무: 적은 수의 큰 집단과 단순한 규칙
- 깊은 나무: 많은 수의 작은 집단과 세밀한 규칙
- 지나치게 깊은 나무: 훈련 사례를 너무 잘게 나눌 위험
- 깊이 조절:
max_depth로 질문 단계 제한
퀴즈
의사결정나무가 새 사례를 예측하는 과정으로 가장 적절한 것은?
퀴즈를 풀려면 대화형 기능을 불러와야 합니다.