부스팅
부스팅
- 부스팅(boosting): 약한 모델을 순서대로 학습해 앞 모델의 오류를 보완하는 방법
- 앞 단계에서 틀린 부분에 다음 모델이 더 집중
- 성능이 강력하지만 학습 설정에 민감할 수 있음
- 대표 모델: Gradient Boosting, XGBoost, LightGBM
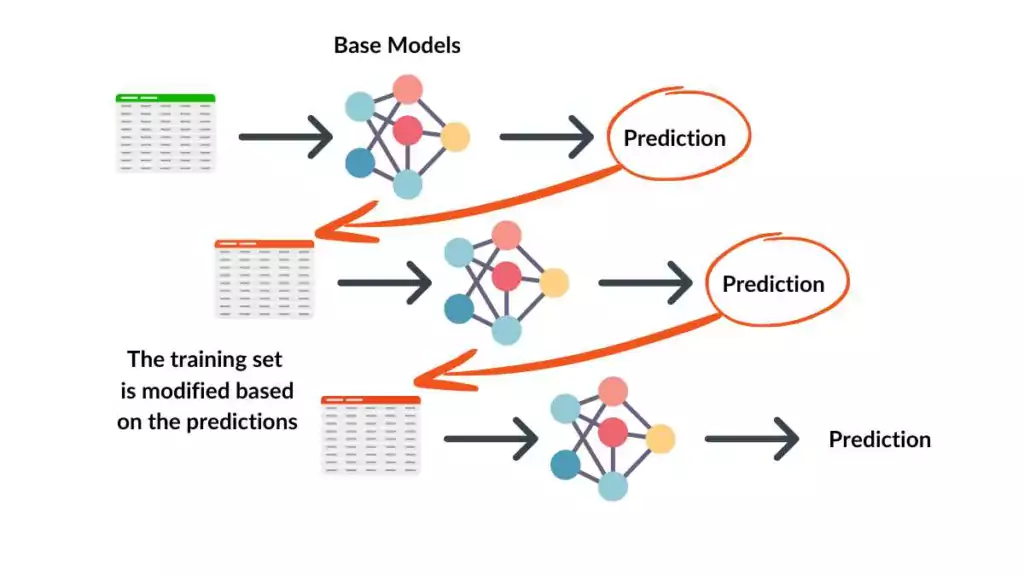
실습 준비
- 앙상블 문서에서 데이터를 불러오고 분할한 노트북에서 이어서 실행
- 앞에서 준비한
X,X_train,X_test,y_train,y_test를 그대로 사용
실습 프롬프트
🤖 AI 프롬프트
datacenter_incident.xlsx 데이터를 8:2로 train과 test로 분할해(random_state=42)
타깃 incident_next_hour에서 0은 정상, 1은 1시간 이내 장애 발생이야.
AdaBoostClassifier와 GradientBoostingClassifier를 사용해줘.
두 모델 모두 n_estimators=100, random_state=42로 설정해줘.
학습 데이터로 두 모델을 학습하고 테스트 정확도를 비교해줘.
필요한 라이브러리를 불러오고 각 단계에 초보자를 위한 한글 주석을 달아줘.
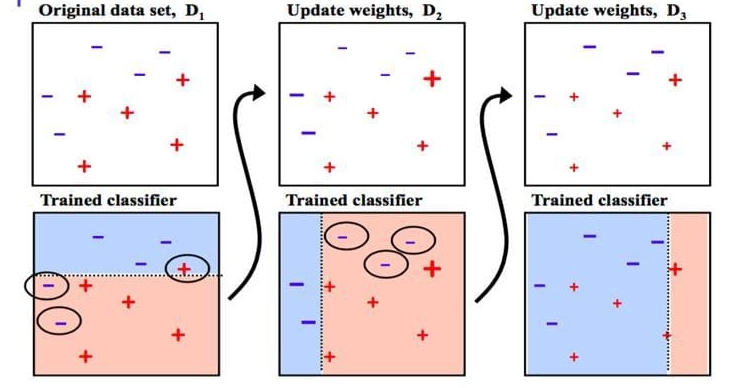
AdaBoost
- 이전 모델에서 잘못 분류한 사례에 가중치를 주어 다음 모델을 학습
from sklearn.ensemble import AdaBoostClassifier
from sklearn.metrics import accuracy_score

ada = AdaBoostClassifier(
    n_estimators=100,  # 순서대로 학습할 모델 수의 상한
    random_state=42,
)
ada.fit(X_train, y_train)

y_pred_ada = ada.predict(X_test)
accuracy_score(y_test, y_pred_ada)
실행 결과
0.72
- AdaBoost의 테스트 정확도: 72.0%
경사 부스트
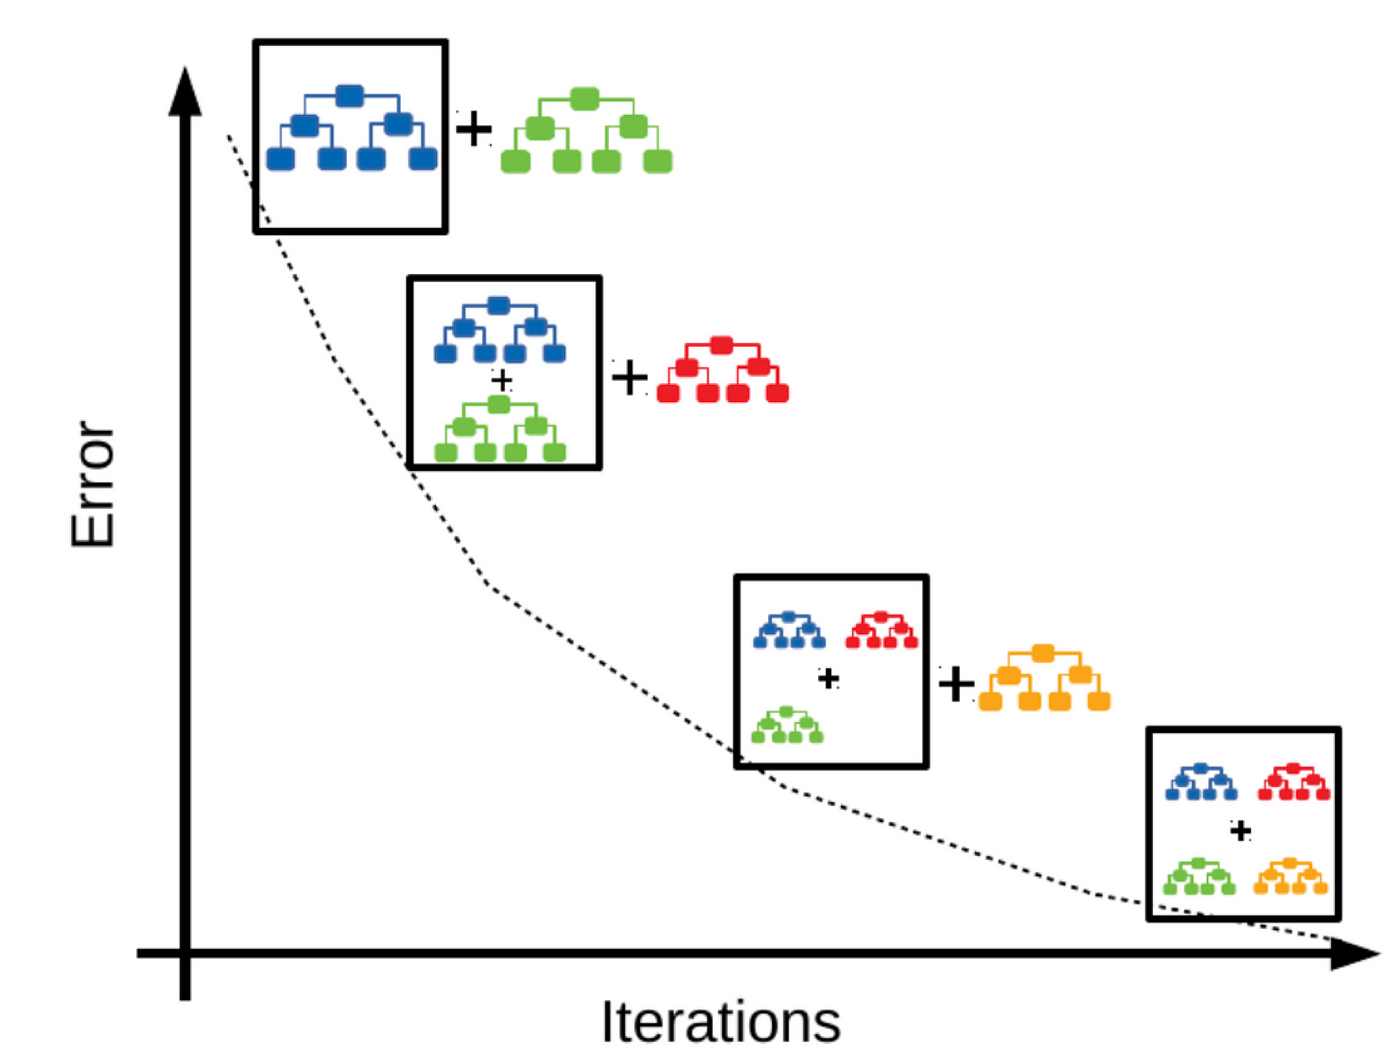
- 경사 부스트(gradient boosting): 현재 예측의 손실을 줄이는 방향으로 새 모델을 순서대로 학습
- 새 모델의 예측을 기존 예측에 더해 남은 오류 보완
from sklearn.ensemble import GradientBoostingClassifier

gb = GradientBoostingClassifier(
    n_estimators=100,  # 순서대로 추가할 모델 수
    random_state=42,
)
gb.fit(X_train, y_train)

y_pred_gb = gb.predict(X_test)
accuracy_score(y_test, y_pred_gb)
실행 결과
0.715
- 경사 부스트의 테스트 정확도: 71.5%
앙상블의 동향: 경사부스팅 계열
- 표 형태의 데이터에서 나무 기반 경사부스팅 알고리즘 활용
- 대표 라이브러리: XGBoost, LightGBM, CatBoost
- 이 실습의
GradientBoostingClassifier도 경사부스팅 계열 - 모델 수와 학습 설정에 따라 정확도·계산량이 달라지므로 데이터에 맞는 설정 필요
퀴즈
AdaBoost가 다음 모델을 학습하는 방식으로 가장 적절한 것은?
퀴즈를 풀려면 대화형 기능을 불러와야 합니다.