ROC 곡선과 PR 곡선
테스트 예측 확률로 ROC·PR 곡선을 그리고 ROC AUC·평균 정밀도 해석
🤖 AI 프롬프트
앞서 계산한 테스트 데이터의 불량 확률과 실제 정답으로 ROC 곡선과 PR 곡선을 그려줘.
ROC AUC와 AP(평균 정밀도)를 계산해서 출력해줘.
ROC 곡선
- 수신자 조작 특성 곡선(Receiver Operating Characteristic curve)
- 원래 레이더 수신기의 성능을 평가하던 용어
- 가로축 FPR: 실제 정상 부품을 불량으로 잘못 예측한 비율, FP/(TN+FP), 즉 1 - 특이도
- 세로축 TPR: 실제 불량 부품을 찾아낸 비율, TP/(TP+FN), 즉 재현도
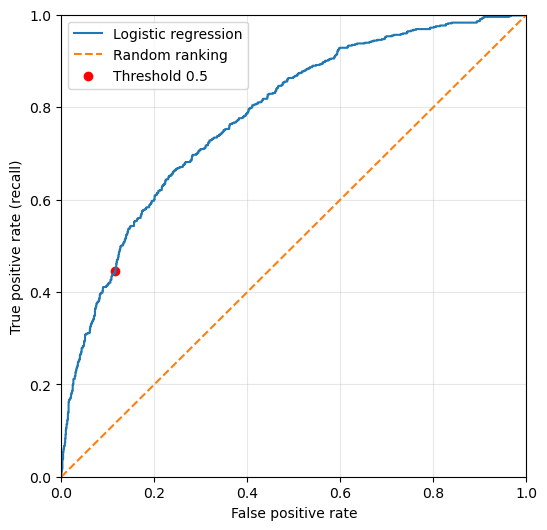
테스트 ROC 곡선 그리기
roc_curve()에는 최종 0·1 예측이 아니라 불량 확률 전달- 2,000개 테스트 사례의 서로 다른 확률로 촘촘한 곡선 작성. 임의의 보간이나 평활화는 사용하지 않음
drop_intermediate=False: 모든 확률 기준의 점 유지
import matplotlib.pyplot as plt
from sklearn.metrics import recall_score, roc_curve, roc_auc_score

fpr, tpr, roc_thresholds = roc_curve(y_test, prob_test, drop_intermediate=False)

plt.figure(figsize=(6, 6))
plt.plot(fpr, tpr, label="Logistic regression")
plt.plot([0, 1], [0, 1], "--", label="Random ranking")
plt.scatter(1 - recall_score(y_test, y_pred_05, pos_label=0),
            recall_score(y_test, y_pred_05), color="red", label="Threshold 0.5")
plt.xlabel("False positive rate")
plt.ylabel("True positive rate (recall)")
plt.xlim(0, 1)
plt.ylim(0, 1)
plt.legend()
plt.grid(alpha=0.3)
plt.show()
곡선하 면적(AUC)
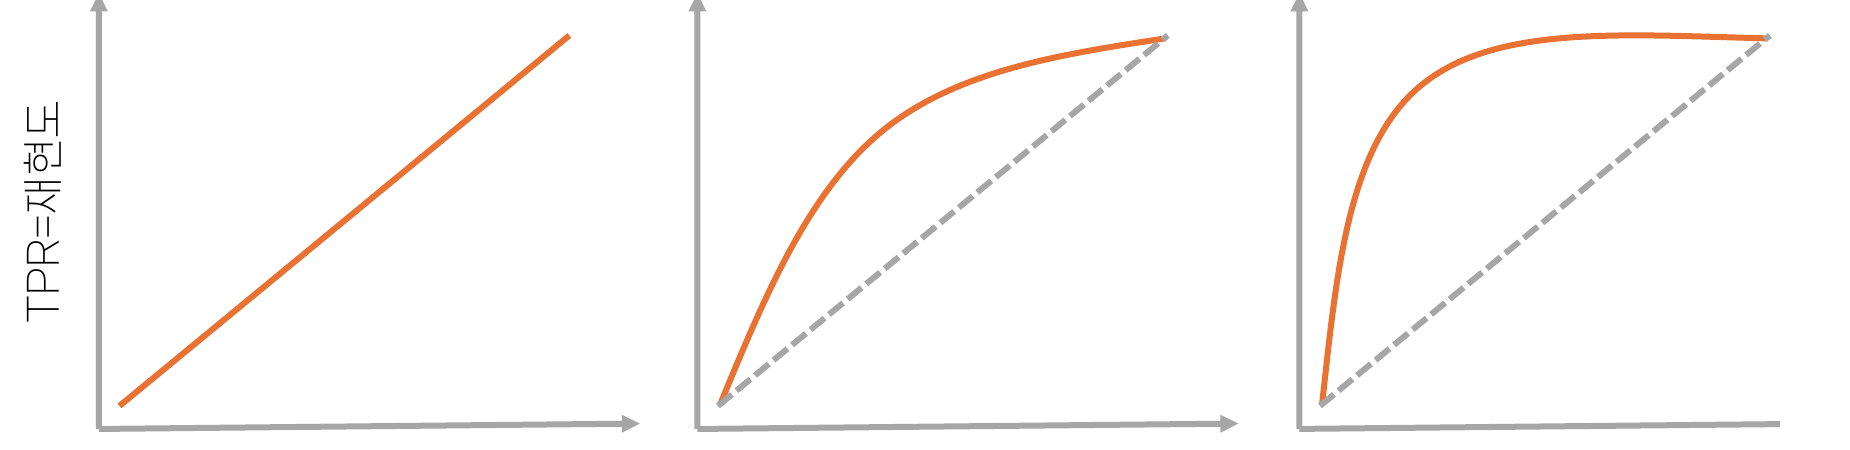
- 곡선이 왼쪽 위에 가까울수록 낮은 위양성률에서 높은 재현도를 달성
- 곡선하 면적(Area Under the Curve): 양성 사례의 점수를 음성 사례보다 높게 매기는 구분 능력의 요약
- 무작위 순위의 ROC AUC는 0.5 수준. 1은 완전한 구분
roc_auc_score(y_test, prob_test)
실행 결과
0.7808357333840658
- ROC AUC 약 0.781. 무작위 순위보다 구분 능력이 높지만 두 클래스가 겹친 상태
PR 곡선
- PR 곡선(precision-recall curve): 문턱값에 따른 정밀도와 재현도의 관계
- 가로축: 재현도. 세로축: 정밀도
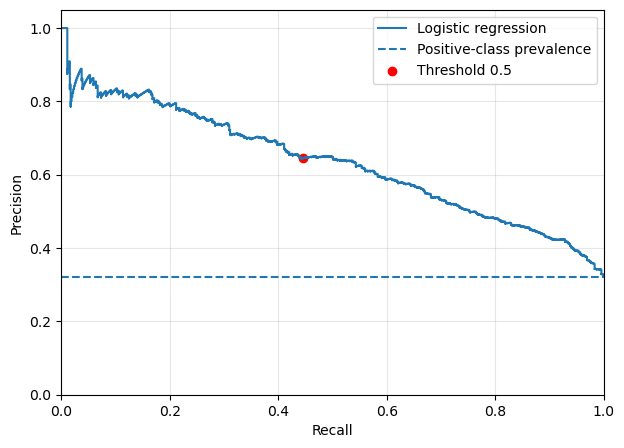
- 오른쪽 위에 가까울수록 실제 불량 부품을 많이 찾으면서 불량 예측의 신뢰도도 높게 유지
- ROC 곡선은 양성이 드문 경우 모형의 성능을 과대평가하기 쉬움
- 양성이 드문 경우 정밀도가 낮아도 FPR은 크게 높아지지 않을 수 있음
테스트 PR 곡선 그리기
precision_recall_curve()반환 순서: 정밀도, 재현도, 문턱값- 문턱값이 커지는 순서이며 재현도는 감소. 정밀도는 위아래로 움직일 수 있음
- 마지막 정밀도 1, 재현도 0은 끝점을 위한 관례이며 대응하는 문턱값이 없음
from sklearn.metrics import (
    precision_score, precision_recall_curve, average_precision_score,
)

pr_precision, pr_recall, pr_thresholds = precision_recall_curve(y_test, prob_test)
positive_rate = y_test.mean()

plt.figure(figsize=(7, 5))
plt.step(pr_recall, pr_precision, where="post", label="Logistic regression")
plt.axhline(positive_rate, linestyle="--", label="Positive-class prevalence")
plt.scatter(recall_score(y_test, y_pred_05), precision_score(y_test, y_pred_05),
            color="red", label="Threshold 0.5")
plt.xlabel("Recall")
plt.ylabel("Precision")
plt.xlim(0, 1)
plt.ylim(0, 1.05)
plt.legend()
plt.grid(alpha=0.3)
positive_rate # 테스트 데이터의 양성 비율
실행 결과
np.float64(0.3215)
- 기준선 약 32.2%. 문턱값 0.5의 점은 재현도 약 44.5%, 정밀도 약 64.6%
- 재현도를 높이려면 불량 확률이 낮은 사례까지 포함. 이 데이터에서는 그 과정에서 정밀도가 낮아지는 경향
평균 정밀도로 곡선 요약
- 평균 정밀도(average precision, AP): PR 곡선 아래 면적으로 정밀도와 재현도를 함께 요약한 지표
- 재현도를 높이면서 정밀도를 얼마나 잘 유지하는지 나타내는 수치. PR 곡선이 오른쪽 위에 가까울수록 AP가 높은 경향
average_precision_score()에 실제 정답과 불량 확률을 전달해 계산
average_precision_score(y_test, prob_test)
실행 결과
0.6332584848629705
- AP 약 0.633. 양성 비율 약 0.322의 무작위 순위 기준보다 높은 결과
퀴즈
ROC 곡선 함수에 불량 확률을 전달하는 이유는?
퀴즈를 풀려면 대화형 기능을 불러와야 합니다.