
K-Means 군집 수 결정
군집 수 선택 방법
- K-Means는 분석 전에 군집 수를 먼저 결정할 필요
- 실제로는 다양한 K개의 군집 수로 분석을 한 후, 적절한 군집 수를 선택
- 군집 수를 변화시켜 가며 지표가 가장 좋은 지점을 선택
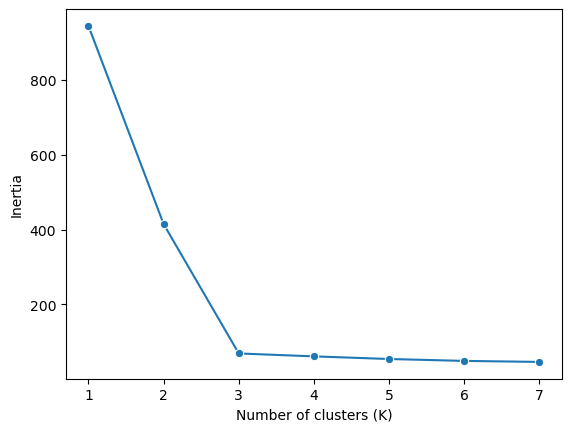
- 관성의 그래프를 그려서 그래프가 꺾이는 군집 수를 선택
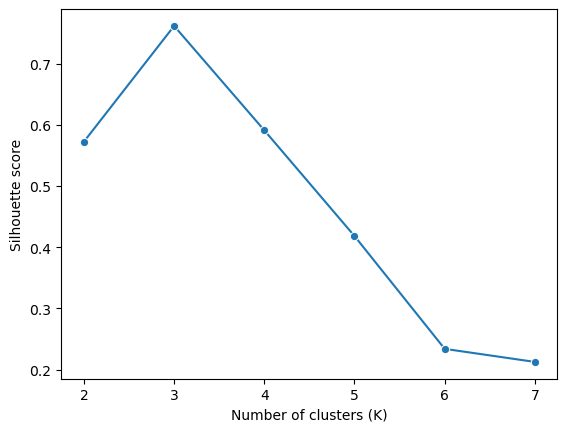
- 실루엣 계수가 가장 높아지는 군집 수를 선택
- 해석 가능성: 각 군집을 도메인 지식으로 설명할 수 있는지
관성(inertia)
- K-Means에서 자주 쓰는 평가 지표
- 각 데이터가 자신이 속한 군집 중심에서 얼마나 떨어져 있는지를 제곱해 모두 더한 값
- 관성이 작을수록 군집 내부가 더 조밀하다는 뜻
- 단, 군집 수를 늘리면 관성은 거의 항상 작아지므로 단독 기준으로 쓰기 어려움
수식으로 보는 관성
Inertia=k=1∑Kxi∈Ck∑∥xi−μk∥2
- Ck: k번째 군집에 속한 데이터의 집합
- μk: k번째 군집의 중심점. 군집에 속한 데이터의 평균 μk=∣Ck∣1xi∈Ck∑xi
- ∥xi−μk∥2: 데이터 xi와 중심점 μk 사이 유클리드 거리의 제곱. 변수가 여러 개이면 변수별 차이의 제곱을 모두 더한 값
- K-Means는 바로 이 값을 줄여 나가는 알고리즘
- 배정 단계: 각 xi를 가장 가까운 μk에 배정하면 관성이 줄거나 같음
- 갱신 단계: μk를 군집의 평균으로 바꾸면 관성이 줄거나 같음
- 두 단계를 반복하면 관성이 더 줄지 않는 지점에서 멈춤
- K=1이면 중심점은 전체 평균이고, 관성은 전체 데이터의 편차 제곱합
- 표준화한 데이터는 변수마다 편차 제곱합이 사례 수와 같으므로, K=1의 관성은 사례 수 × 변수 수
- 실습 데이터: 135×7=945
- K를 늘릴수록 각 데이터가 더 가까운 중심점을 얻으므로 관성은 거의 항상 감소. K가 사례 수와 같으면 0
kmeans.inertia_ # 표준화한 데이터의 군집 내 거리 제곱합
실행 결과
68.47501571220504
- 군집 3개의 관성은 약 68.48
- 같은 데이터와 표준화 조건에서 다른 군집 수의 관성과 비교
엘보우 방법
🤖 AI 프롬프트
K=1부터 7까지의 관성을 표와 그래프로 비교하고, 적절한 군집 수를 선택해줘.
- K를 1개부터 늘려가며 관성(inertia)을 계산
- K가 늘면 관성이 줄지만, 어느 순간부터 개선 폭 감소
- 그래프가 급하게 내려가다 완만해지는 지점을 후보 K로 판단
- 실습 데이터에서는 K=3 부근의 변화 확인
inertia = []

for k in range(1, 8):
    km = KMeans(n_clusters=k, random_state=42, n_init=10).fit(X_scaled)
    inertia.append(km.inertia_)

pd.DataFrame({"n_clusters": range(1, 8), "inertia": inertia})
실행 결과
   n_clusters     inertia
0           1  945.000000
1           2  414.772130
2           3   68.475016
3           4   60.665505
4           5   53.623641
5           6   48.533510
6           7   45.817593
- K=2에서 K=3으로 늘릴 때 관성은 약 414.77에서 68.48로 크게 감소
- K=4에서는 약 60.67로 감소 폭이 작아져 K=3을 후보로 선택
import matplotlib.pyplot as plt
import seaborn as sns

plt.figure()
sns.lineplot(x=range(1, 8), y=inertia, marker="o")
plt.xlabel("Number of clusters (K)")
plt.ylabel("Inertia")
실루엣 계수(silhouette score)
🤖 AI 프롬프트
K=2부터 7까지의 실루엣 계수를 표와 그래프로 비교하고 적절한 군집 수를 선택해줘.
- 각 데이터가 같은 군집에는 얼마나 가깝고 다른 군집에는 얼마나 먼지 평가
- 값의 범위는 −1부터 1
- 1에 가까울수록 군집 내부는 조밀하고 군집 사이는 잘 분리됨
- 0에 가까우면 군집 경계가 서로 겹침
- 음수이면 다른 군집에 더 가까운 데이터가 있을 수 있음
- 여러 K의 실루엣 계수를 비교하되 엘보우 결과와 해석 가능성도 함께 고려
수식으로 보는 실루엣 계수
데이터 xi 하나에 대해 두 가지 거리를 계산:
- a(i): xi와 같은 군집에 속한 다른 모든 데이터 사이의 평균 거리. 군집 내부의 응집도 a(i)=∣CI∣−11j∈CI,j=i∑d(xi,xj)
- b(i): xi와 다른 군집의 데이터 사이 평균 거리를 군집마다 구한 뒤, 그중 가장 작은 값. 가장 가까운 이웃 군집까지의 거리 b(i)=J=Imin∣CJ∣1j∈CJ∑d(xi,xj)
데이터 xi의 실루엣 계수:
s(i)=max{a(i),b(i)}b(i)−a(i)- a(i)≪b(i): 자기 군집에는 가깝고 이웃 군집에는 멀다는 뜻. s(i)는 1에 가까움
- a(i)≈b(i): 두 군집 사이의 경계에 있음. s(i)는 0에 가까움
- a(i)>b(i): 이웃 군집이 자기 군집보다 더 가까움. s(i)는 음수이며, 잘못 배정됐을 가능성
- 분모를 max로 두어 값이 항상 −1과 1 사이에 오도록 정규화
- 군집에 데이터가 하나뿐이면 a(i)를 정의할 수 없으므로 s(i)=0으로 둠
전체 실루엣 계수(silhouette_score)는 모든 데이터의 s(i)를 평균한 값:
- 관성과 달리 군집 사이의 거리 b(i)를 함께 보므로, K를 늘린다고 무조건 좋아지지 않음
- 모든 데이터 쌍의 거리가 필요하므로 데이터가 많으면 계산 비용이 큼
from sklearn.metrics import silhouette_score

silhouette_scores = []

for k in range(2, 8):
    labels = KMeans(
        n_clusters=k, random_state=42, n_init=10
    ).fit_predict(X_scaled)
    silhouette_scores.append(silhouette_score(X_scaled, labels))

pd.DataFrame({
    "n_clusters": range(2, 8),
    "silhouette_score": silhouette_scores,
})
실행 결과
   n_clusters  silhouette_score
0           2          0.572614
1           3          0.761804
2           4          0.591116
3           5          0.418261
4           6          0.233808
5           7          0.212440
- 비교한 K 중 K=3의 실루엣 계수가 약 0.7618로 가장 높음
- 엘보우 결과와 함께 보면 군집 3개가 적절한 후보
plt.figure()
sns.lineplot(x=range(2, 8), y=silhouette_scores, marker="o")
plt.xlabel("Number of clusters (K)")
plt.ylabel("Silhouette score")
퀴즈
K-Means의 관성(inertia)에 대한 설명으로 가장 적절한 것은?
퀴즈를 풀려면 대화형 기능을 불러와야 합니다.