
이상치 탐지와 처리
이상치의 의미
- 이상치(outlier): 다른 관측치와 비교해 드물거나 기존 패턴에서 크게 벗어난 관측치
- 정상치(inlier): 분석 기준에서 일반적인 패턴에 속하는 관측치
- 이상치 여부는 데이터의 구조와 탐지 방법에 따라 달라지며, 탐지 결과만으로 오류라고 단정할 수 없음
- 이상치가 생기는 주요 원인
- 입력하는 사람의 실수 또는 센서 오류
- 제대로 교정되지 않은 측정 장비 또는 환경 변화로 인한 측정 오류
- 데이터 단위 변환이나 스케일링 과정에서의 잘못된 처리
- 매우 드문 사건이나 특이한 현상
- 데이터가 다양한 집단에서 수집된 경우
- 결측치를 부정확한 값으로 대치한 경우
- 예: 관행적으로 결측치를 99로 입력하는 경우
- 예: 다봉분포에서 평균값으로 대치하는 경우
이상치 다루기
- 수정해야 할 경우
- 데이터 포인트의 원본과 대조했을 때 입력이 잘못된 경우
- 삭제해야 할 경우
- 데이터 포인트가 연구의 모집단에 속하지 않는 경우
- 실험 절차나 측정이 잘못된 경우
- 진단 지표를 기계적으로 적용해 데이터를 삭제하면 안 됨
- 데이터 삭제에는 객관적 이유가 필요
- 데이터를 삭제한 경우 결과 보고에 포함해야 함
- 삭제 여부를 결정하기 어려운 경우
- 삭제한 데이터셋과 삭제하지 않은 데이터셋을 따로 분석하고 결과 비교
- 모형을 수정해야 할 경우
- 중요한 변수의 누락
- 상호작용
- 비선형성
실습 준비
- 서로 다른 분포를 가진 5개 데이터셋, 각 300개 관측치
dataset: 데이터셋 구분,sensor_a·sensor_b: 탐지에 사용할 두 센서값type: 수업용 데이터의 신호(signal)·잡음(noise) 구분- 그림의 색상으로만 사용하며 모델 학습에서는 제외
- 두 센서값은 비슷한 범위로 구성. 실제 데이터의 단위·범위가 다르면 거리 기반 방법을 적용하기 전에 표준화 검토
실습 프롬프트
🤖 AI 프롬프트
outlier_detection.csv의 dataset별로 sensor_a와 sensor_b를 산점도로 그려줘.
EllipticEnvelope, OneClassSVM, IsolationForest, LocalOutlierFactor로
각 데이터셋을 따로 학습하고 정상과 이상의 경계를 비교해줘.
type은 그림의 색상으로만 사용하고 학습 입력에서는 제외해.
EllipticEnvelope, IsolationForest, LocalOutlierFactor의 contamination은 0.15,
OneClassSVM은 nu=0.15, kernel="rbf", gamma="scale"로 설정해.
LocalOutlierFactor는 n_neighbors=35, novelty=True로 새 좌표를 예측해.
난수를 사용하는 모델은 random_state=42로 고정해.
각 단계에 초보자를 위한 한글 주석을 달아줘.
데이터 확인
import numpy as np
import pandas as pd

df_outlier = pd.read_csv("outlier_detection.csv")
df_outlier.head()
실행 결과
   sensor_a  sensor_b         dataset    type
0 -0.563413 -0.365339  single_cluster  signal
1 -0.182347  0.078352  single_cluster  signal
2 -0.667129 -0.673359  single_cluster  signal
3  0.099650 -0.025302  single_cluster  signal
4  1.081618  0.668264  single_cluster  signal
dataset_names = df_outlier.dataset.unique().tolist()
데이터 분포 시각화
# 시각화
import matplotlib.pyplot as plt
import seaborn as sns

dataset = df_outlier.query('dataset == "single_cluster"')
sns.scatterplot(x="sensor_a", y="sensor_b", hue="type", data=dataset)
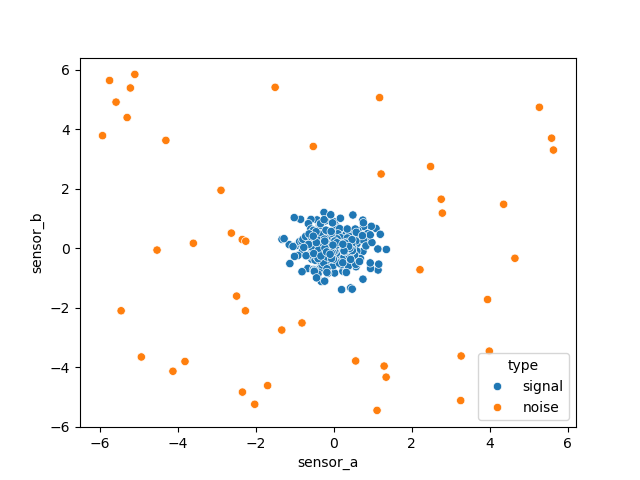
- 여러 데이터셋을 나란히 비교
g = sns.FacetGrid(df_outlier, col="dataset", hue="type")
g.map(sns.scatterplot, "sensor_a", "sensor_b")
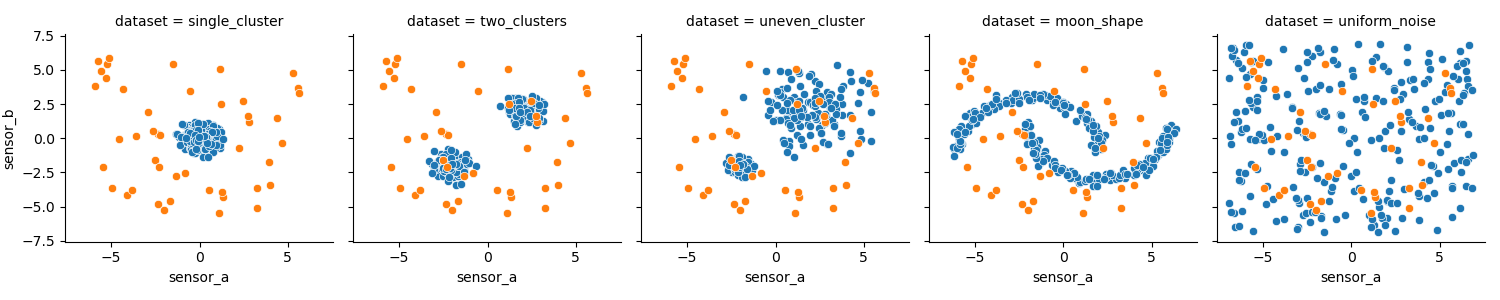
탐지 경계를 비교하는 함수
- 학습 입력:
sensor_a,sensor_b두 열 fit(X): 해당 데이터셋에 모델 학습predict(...): 새로운 좌표를 정상1또는 이상-1로 판정- 검은 선: 격자에서 예측값이
-1에서1로 바뀌는 경계 - 다음 함수는 네 알고리즘의 결과를 같은 방식으로 그리기 위한 공통 코드
def apply_outlier_detection(algorithm):
    g = sns.FacetGrid(
        df_outlier,
        col="dataset",
        col_order=dataset_names,
        hue="type",
    )
    g.map(sns.scatterplot, "sensor_a", "sensor_b")

    xx, yy = np.meshgrid(
        np.linspace(-7, 7, 150),  # 센서값 범위를 덮는 150개 좌표
        np.linspace(-7, 7, 150),
    )

    for i, ax in enumerate(g.axes.flat):
        dataset_name = dataset_names[i]
        X = df_outlier.query(
            "dataset == @dataset_name"
        )[["sensor_a", "sensor_b"]].to_numpy()

        algorithm.fit(X)
        Z = algorithm.predict(np.c_[xx.ravel(), yy.ravel()])  # 격자를 두 열의 좌표로 변환
        Z = Z.reshape(xx.shape)  # 예측값을 원래 격자 모양으로 복원
        ax.contour(xx, yy, Z, levels=[0], linewidths=2, colors="black")

    return g.add_legend()
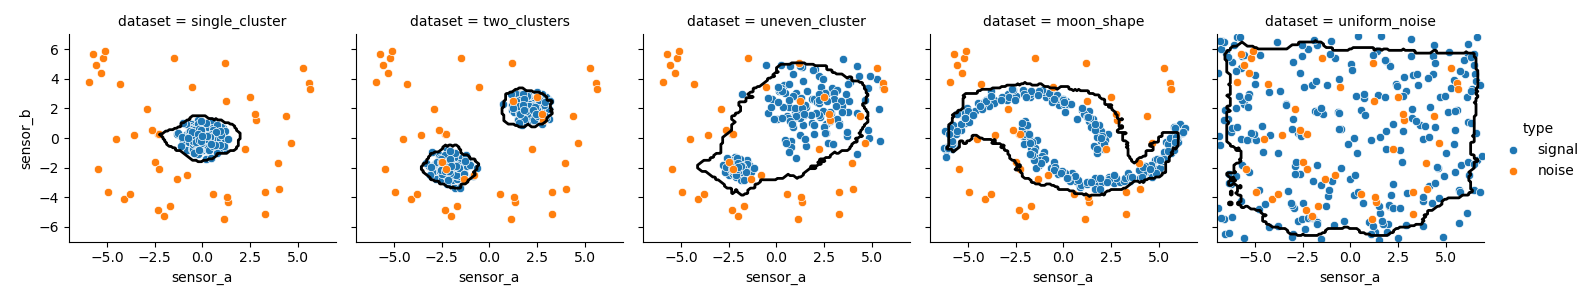
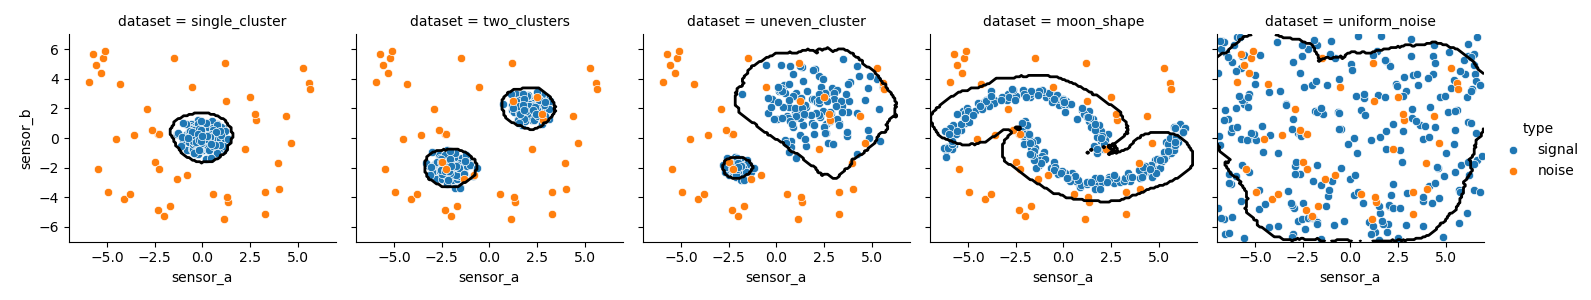
- 각 데이터셋에 알고리즘을 학습한 뒤, 격자상의 모든 점을 예측해 정상/이상 경계를 그림
EllipticEnvelope
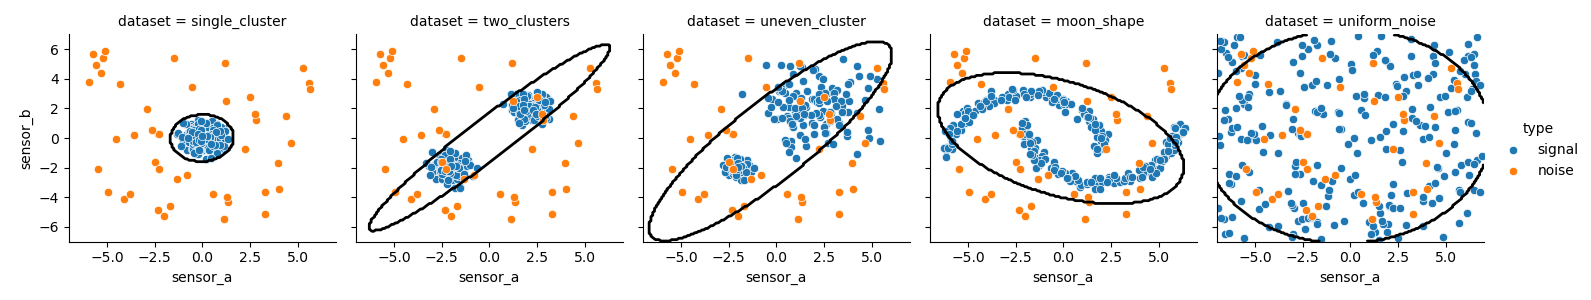
- 정상 데이터가 하나의 다변량 정규분포에 가깝다고 가정
- 이상치의 영향을 줄여 중심과 공분산을 추정하고, 타원형 정상 영역에서 멀리 떨어진 점을 탐지
- 여러 군집이나 초승달 모양을 하나의 타원으로 설명하기는 어려움
contamination=0.15: 학습 데이터의 예상 이상치 비율을 15%로 지정해 판정 문턱값 설정- 데이터 생성 시의 잡음 비율을 참고한 실습 설정이며, 실제 데이터에서는 근거에 따라 조정
from sklearn.covariance import EllipticEnvelope

outliers_fraction = 0.15  # 실습에서 가정한 이상치 비율
algorithm = EllipticEnvelope(
    contamination=outliers_fraction,
    random_state=42,
)
apply_outlier_detection(algorithm)
OneClassSVM
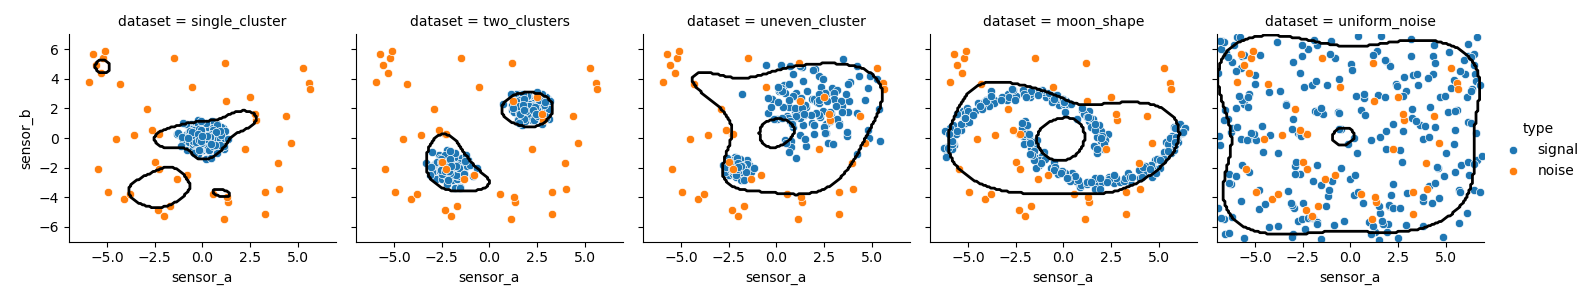
- 정상 데이터가 주로 차지하는 영역을 커널 기반 경계로 학습
- RBF 커널의
gamma: 각 관측치가 경계에 영향을 미치는 범위 조절- 작은 값: 넓은 영향 범위
- 큰 값: 국소적인 영향 범위
"scale": 변수 개수와 입력 분산을 이용해 계산하는 기본 설정
nu: 정상 영역을 학습할 때, 학습 데이터가 영역 밖에 놓이는 것을 얼마나 허용할지 조절하는 값nu=0.15: 학습 데이터의 최대 15%가 정상 영역 밖에 놓이는 것을 허용하는 기준- 값을 높이면 더 많은 학습 데이터를 영역 밖에 둘 수 있어, 정상 영역을 더 엄격하게 정하는 경향
from sklearn.svm import OneClassSVM

algorithm = OneClassSVM(
    nu=0.15,  # contamination과 구분되는 SVM의 경계 설정
    kernel="rbf",
    gamma="scale",
)
apply_outlier_detection(algorithm)
Isolation Forest
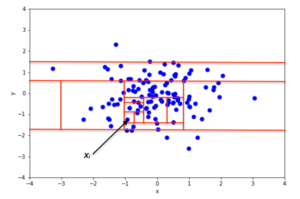
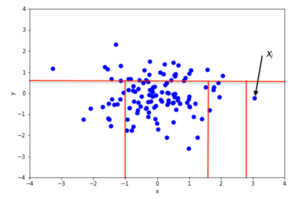
- 데이터를 분할하는 트리(tree)를 무작위로 만듦
- 이상치는 뿌리에서 짧은 거리 안에서 고립되는 경향이 있음
- 트리를 많이 만들어 forest를 구성하고, 쉽게 고립되는 점을 찾음
from sklearn.ensemble import IsolationForest

algorithm = IsolationForest(
    contamination=outliers_fraction,
    random_state=42,
)
apply_outlier_detection(algorithm)
LocalOutlierFactor
- 국소 이상치 계수(Local Outlier Factor, LOF): 관측치의 국소 밀도를 주변 이웃의 밀도와 비교
n_neighbors=35: 밀도 추정과 비교에 사용하는 가까운 이웃 수- 해당 관측치: 가까운 이웃 35개까지의 거리를 이용해 밀도 추정
- 각 이웃: 자기 주변의 가까운 이웃 35개를 이용해 밀도 추정
- 해당 관측치의 밀도와 이웃들의 밀도를 비교해, 주변보다 밀도가 낮은 점을 이상치 후보로 판단
novelty=True: 학습에 없던 새 좌표에predict()를 사용하기 위한 설정- 이 실습에서는 경계를 그리는 격자와 시험 좌표에 적용
- 학습 데이터 자체의 이상치를 찾을 때는 기본 설정인
novelty=False와fit_predict(X)사용
from sklearn.neighbors import LocalOutlierFactor

algorithm = LocalOutlierFactor(
    n_neighbors=35,  # 밀도 추정과 비교에 사용할 이웃 수
    contamination=outliers_fraction,
    novelty=True,  # 격자상의 새로운 좌표를 예측
)
apply_outlier_detection(algorithm)
알고리즘별 예측 실습
uneven_cluster로 네 모델을 학습하고, 학습에 사용하지 않은 두 좌표를 판정- 같은 좌표에 대한 판정이 탐지 기준에 따라 어떻게 달라지는지 비교
X_practice = (
    df_outlier
    .query('dataset == "uneven_cluster"')
    [["sensor_a", "sensor_b"]]
    .to_numpy()
)

test_points = np.array([
    [0.0, -3.0],
    [1.5, -2.0],
])
models = {
    "EllipticEnvelope": EllipticEnvelope(
        contamination=outliers_fraction, random_state=42,
    ),
    "OneClassSVM": OneClassSVM(nu=0.15, kernel="rbf", gamma="scale"),
    "IsolationForest": IsolationForest(
        contamination=outliers_fraction, random_state=42,
    ),
    "LocalOutlierFactor": LocalOutlierFactor(
        n_neighbors=35, contamination=outliers_fraction, novelty=True,
    ),
}

predictions = pd.DataFrame(index=["(0, -3)", "(1.5, -2)"])
for name, model in models.items():
    model.fit(X_practice)
    predictions[name] = model.predict(test_points)

predictions
실행 결과
           EllipticEnvelope  OneClassSVM  IsolationForest  LocalOutlierFactor
(0, -3)                   1            1               -1                  -1
(1.5, -2)                -1            1                1                  -1
1: 정상 판정,-1: 이상 판정(0, -3): EllipticEnvelope·OneClassSVM은 정상, IsolationForest·LOF는 이상으로 판정(1.5, -2): OneClassSVM·IsolationForest는 정상, EllipticEnvelope·LOF는 이상으로 판정- 판정 불일치는 각 방법이 사용하는 분포·경계·고립·밀도 기준의 차이
- 실무에서는 점수나 판정만으로 삭제하지 않고 원자료·수집 조건·업무 맥락을 함께 확인
퀴즈
이상치란 어떤 관측치인가요?
퀴즈를 풀려면 대화형 기능을 불러와야 합니다.