앙상블
앙상블 학습
- 앙상블: 여러 모델의 예측을 결합하는 방법
- 한 모델의 판단보다 여러 모델의 판단을 모아 안정성 향상
- 분류에서는 다수결이나 확률 평균 사용
- 회귀에서는 여러 예측값의 평균 사용
- 종류
- 배깅: 복원추출한 데이터로 모델들을 독립적으로 학습하고 예측 결합
- 부스팅: 앞 모델의 오류를 보완하도록 모델들을 순서대로 학습
- 스태킹: 여러 모델의 예측을 입력으로 받아 최종 모델이 결합 방법 학습
왜 단일 모델보다 안정적인가
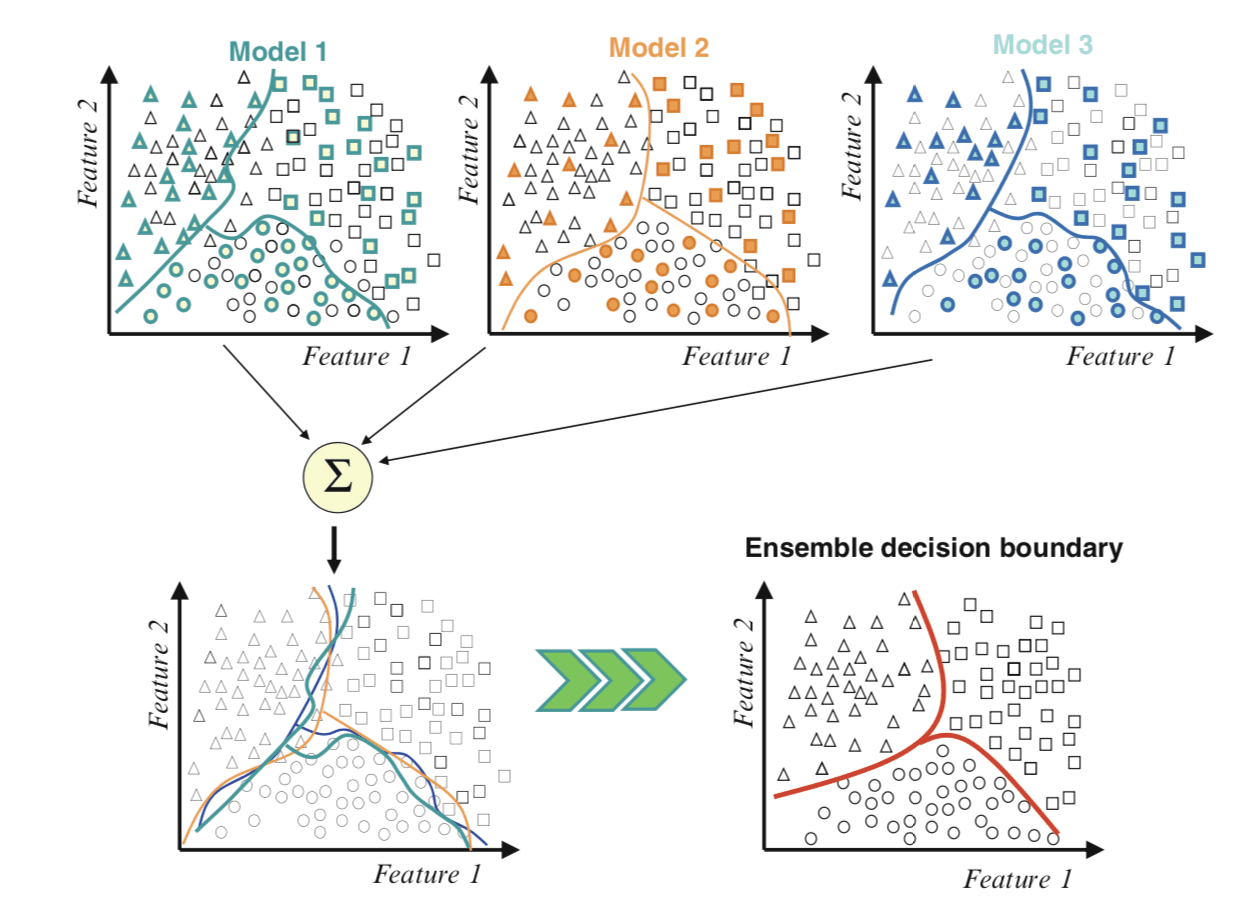
- 단일 모델은 학습 데이터의 구성이나 잡음에 따라 예측 결과가 크게 달라질 수 있음
- 서로 다른 모델의 오류가 완전히 같지는 않음
- 여러 예측을 결합하면 우연한 오류를 줄일 수 있음
- 여러 모델을 결합하면 학습 데이터가 달라졌을 때 예측 결과의 차이가 줄어들 수 있음
앙상블의 단점
- 학습 시간과 자원 사용 증가: 여러 모델을 학습하므로 더 많은 시간과 메모리 필요
- 예측 속도 저하: 여러 모델의 예측을 구하고 결합하는 과정에서 응답 시간 증가 가능
- 해석의 어려움: 여러 모델의 판단이 결합되므로 최종 예측의 근거를 설명하기 어려워질 수 있음
실습 데이터: 데이터센터 장애 위험 예측
- 현재 서버 상태로 1시간 이내 장애 발생 여부 예측
- 9개 숫자형 입력 변수로 장애 발생 여부 분류
incident_next_hour는0=정상,1=장애 발생
| 컬럼 | 설명 |
|---|---|
cpu_util_pct |
CPU 사용률(%) |
memory_util_pct |
메모리 사용률(%) |
disk_io_mb_s |
초당 디스크 입출력량(MB/s) |
request_rate_per_sec |
초당 요청 수 |
p95_latency_ms |
95번째 백분위 응답시간(ms) |
packet_loss_pct |
패킷 손실률(%) |
recent_deployments_7d |
최근 7일 배포 횟수 |
uptime_days |
재시작 후 가동 일수 |
room_temp_c |
서버실 온도(°C) |
incident_next_hour |
1시간 이내 장애 여부(0=정상, 1=장애 발생) |
실습 준비
import pandas as pd
from sklearn.model_selection import train_test_split

df_server = pd.read_excel("datacenter_incident.xlsx")

df_server.head()
실행 결과
   cpu_util_pct  memory_util_pct  disk_io_mb_s  request_rate_per_sec  \
0          59.0             92.8         342.3                  1076
1          43.5             42.7         289.4                   780
2          29.3             51.4         234.1                   667
3          12.9             48.7         166.9                   420
4          66.6             53.8         281.4                   723

   p95_latency_ms  packet_loss_pct  recent_deployments_7d  uptime_days  \
0           160.1             0.17                      3           83
1           135.8             0.56                      1          167
2           156.4             0.53                      3          365
3           134.0             0.62                      2          160
4           107.6             0.29                      1           61

   room_temp_c  incident_next_hour
0         26.5                   1
1         18.0                   0
2         22.1                   1
3         22.5                   0
4         26.8                   0
df_server["incident_next_hour"].value_counts().sort_index()
실행 결과
incident_next_hour
0    671
1    329
Name: count, dtype: int64
- 정상 671건, 장애 발생 329건
학습·테스트 데이터 분할
- 학습 800건: 모델 학습
- 테스트 200건: 학습에 쓰지 않은 데이터에서 정확도 평가
- 배깅·부스팅·스태킹 실습에서 같은 분할 사용
X = df_server.drop(columns="incident_next_hour")
y = df_server["incident_next_hour"]

X_train, X_test, y_train, y_test = train_test_split(
    X,
    y,
    test_size=0.2,     # 전체의 20%를 테스트 데이터로 보관
    random_state=42,   # 세 앙상블 실습에서 같은 사례로 분할
    stratify=y,        # 정상과 장애의 비율 유지
)
X_train.shape # 학습 데이터의 사례 수와 입력 변수 수
실행 결과
(800, 9)
X_test.shape # 테스트 데이터의 사례 수와 입력 변수 수
실행 결과
(200, 9)
퀴즈
1시간 이내 장애 발생 여부를 예측하는 문제가 분류에 해당하는 이유는?
퀴즈를 풀려면 대화형 기능을 불러와야 합니다.