실습 데이터: 설비 불량 예측 데이터
- 설비 센서와 공정 지표로 불량 여부 예측
- 불량 검출용 이진분류 예제
- 정상 데이터가 더 많은 현장 상황 반영
defect는 0=정상, 1=불량
import pandas as pd

df_defect = pd.read_csv('defect_classification.csv')
df_defect.head()
양성 클래스 설정: 불량 여부 예측
- 불량
defect == 1을 양성(positive, 1)로 설정
- 예측 목적: 불량 제품을 찾아내는 모델
X = df_defect.drop(columns='defect')
y = df_defect['defect']

target_check = y.value_counts().sort_index()
target_check
학습/평가 데이터 분할
- 분류에서는 클래스 비율 유지가 중요
stratify=y로 훈련/테스트의 클래스 비율 유지- 테스트 데이터는 최종 평가용으로 보관
from sklearn.model_selection import train_test_split

X_train, X_test, y_train, y_test = train_test_split(
    X, y,
    test_size=0.2,
    random_state=42,
    stratify=y
)
결정트리 분류 모델 학습
- 조건 분기로 클래스를 예측하는 모델
- 변수 스케일 차이에 민감하지 않음
- 결과 구조가 비교적 직관적
from sklearn.tree import DecisionTreeClassifier
from sklearn.metrics import accuracy_score

tree_clf = DecisionTreeClassifier(max_depth=4, random_state=42)
tree_clf.fit(X_train, y_train)

y_pred_tree = tree_clf.predict(X_test)
accuracy_score(y_test, y_pred_tree)
KNN 분류 모델 학습
- KNN(k-nearest neighbors): 가까운 이웃의 다수결로 분류
- 거리 기반 모델이므로 표준화가 중요
from sklearn.neighbors import KNeighborsClassifier
from sklearn.pipeline import make_pipeline
from sklearn.preprocessing import StandardScaler

knn_clf = make_pipeline(
    StandardScaler(),
    KNeighborsClassifier(n_neighbors=5)
)

knn_clf.fit(X_train, y_train)
y_pred_knn = knn_clf.predict(X_test)
accuracy_score(y_test, y_pred_knn)
나이브 베이즈
- 베이즈 정리를 이용한 분류 알고리즘
- 클래스가 주어졌을 때 입력 변수들이 서로 조건부 독립이라고 단순하게 가정
- 텍스트 분류, 스팸 탐지 등에서 자주 잘 작동
- 기본 아이디어
- 각 클래스가 주어졌을 때 관측된 특징들이 나타날 확률을 계산
- 그 확률이 가장 큰 클래스로 분류
P(C∣X)=P(X)P(X∣C)P(C)
- 의미
- C: 클래스
- X: 관측된 입력 특징
- P(C∣X): 입력 X가 주어졌을 때 클래스가 C일 확률
- P(X∣C): 클래스 C에서 입력 특징 X가 나타날 확률
- P(C): 클래스 C의 사전확률
- 독립 가정
P(X∣C)=P(x1∣C)×P(x2∣C)×⋯×P(xk∣C)
로지스틱 회귀분석
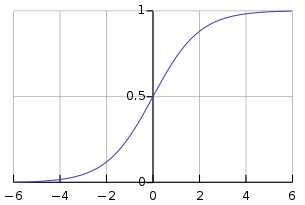
- 독립변수를 선형 결합한 z에 로지스틱 함수를 적용
σ(z)=1+exp(−z)1
- 로지스틱 함수 σ(z)는 0~1 사이에서 매끄럽게 변함
- 출력은 확률로 해석
- 이를 통해 0과 1, 두 가지 집단을 분류할 수 있음
로지스틱 회귀분석 실습
from sklearn.linear_model import LogisticRegression

lr = LogisticRegression(max_iter=1000)
lr.fit(X_train, y_train)
- 특징별 가중치 확인
- 각각의 특징에 가중치를 곱한 총점을 기준으로 분류
lr.score(X_train, y_train)
lr.score(X_test, y_test)
lr.predict_proba(X_test)[:, 1]
lr.predict(X_test)
서포트 벡터 머신
- SVM(support vector machine)
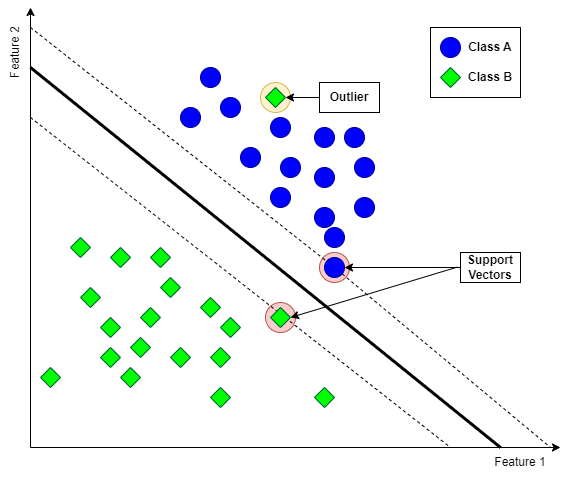
- 클래스를 나누는 결정 경계를 찾는 분류 모델
- 선형 SVM의 경계는 직선, 평면, 초평면 형태
- 핵심 아이디어: 두 클래스 사이의 여유 폭을 가능한 넓게 설정
- 서포트 벡터: 경계 결정에 직접 영향을 주는 가까운 데이터
- 마진(margin): 결정 경계와 서포트 벡터 사이의 거리
- 데이터가 완벽히 나뉘지 않으면 일부 오류를 허용하는 소프트 마진 사용
- 거리와 마진을 사용하므로 표준화가 중요
선형 SVM 분류 실습
- 선형 SVM은 직선 또는 평면으로 클래스를 구분
- 변수 수가 많고 데이터가 비교적 깔끔할 때 좋은 기준 모델
- 설비 지표를 표준화 후 학습
C가 클수록 훈련 오류를 더 강하게 줄이려는 모델
from sklearn.svm import SVC

svm_linear_clf = make_pipeline(
    StandardScaler(),
    SVC(kernel='linear', C=1.0)
)

svm_linear_clf.fit(X_train, y_train)
y_pred_svm_linear = svm_linear_clf.predict(X_test)
accuracy_score(y_test, y_pred_svm_linear)
커널 트릭 원리: 변환 공간의 내적 계산
- 특성 변환(feature mapping): 원래 변수로 새 조합 변수를 만드는 방식
- 예:
temp_index, vibration_index, temp_index^2, temp_index * vibration_index
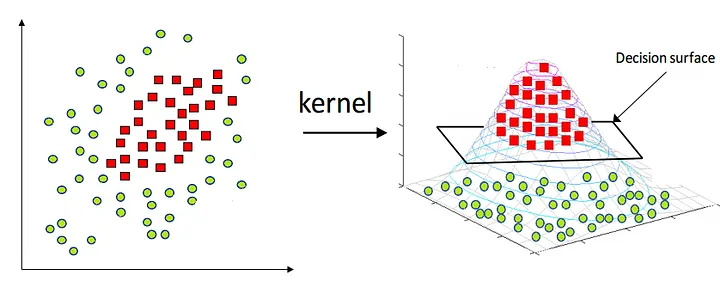
- 커널 트릭(kernel trick): 실제로 특성을 변환하는 대신, 데이터들의 유사도를 다르게 정의하여 마치 특성이 변환된 것과 같은 효과를 내는 기법
- 선형 패턴만 다룰 수 있는 모델을 비선형 패턴을 다루게 만들 수 있음
K(xi,xj)=ϕ(xi)⋅ϕ(xj)
RBF 커널
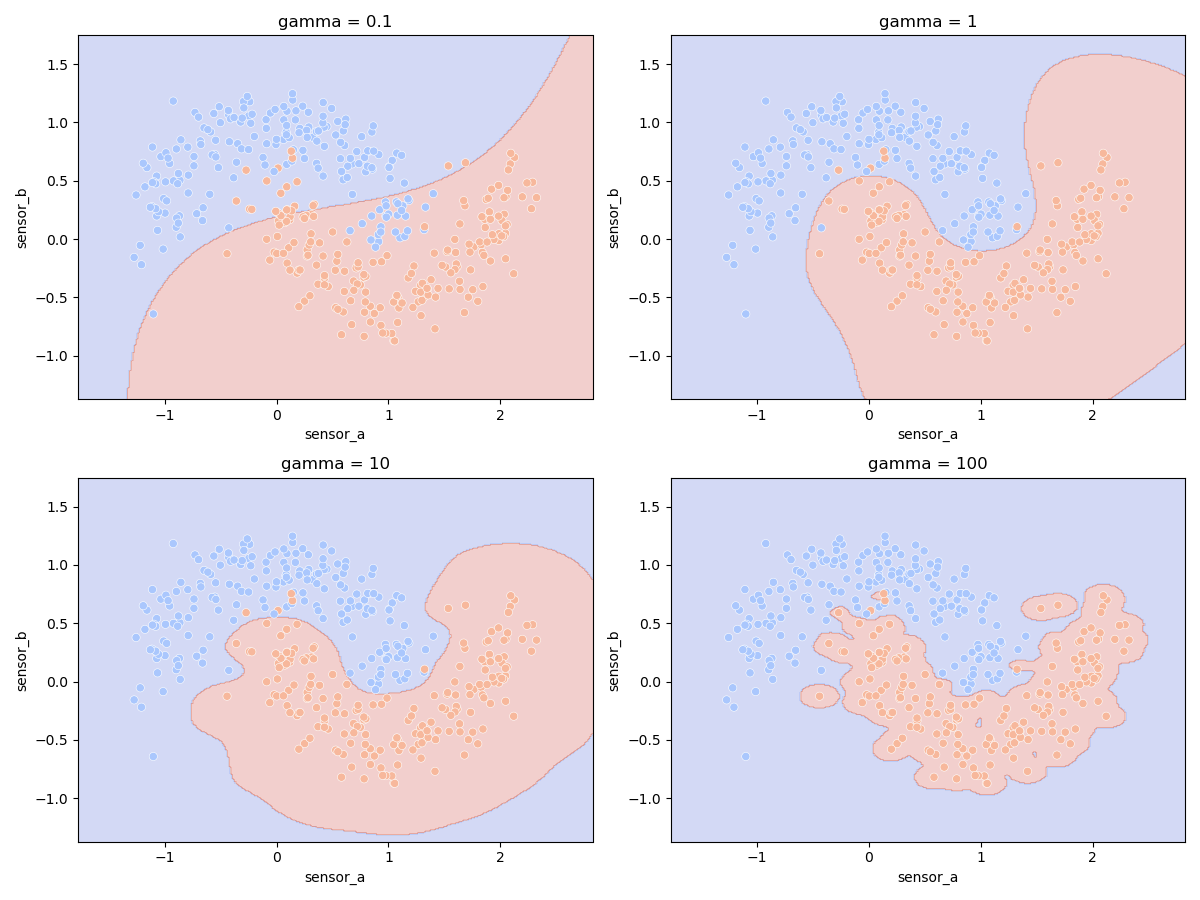
rbf: 거리가 가까운 데이터일수록 더 비슷하다고 계산gamma: RBF 커널에서 한 데이터가 주변에 영향을 주는 범위
- 작음: 넓고 부드러운 경계
- 큼: 좁고 복잡한 경계
- 커널은 자동 성능 향상 장치가 아니라 검증으로 선택할 모델 설정
K(xi,xj)=exp(−γ∥xi−xj∥2)
- 다른 커널의 종류
linear: 원래 변수 공간에서 선형 경계 학습poly: 변수의 제곱, 곱 같은 다항 조합을 반영
gamma에 따른 RBF 결정 경계
커널 SVM 실습
- 같은
X_train, X_test로 선형 커널과 RBF 커널 비교
- RBF 커널은 가까운 점끼리의 유사도를 기준으로 경계 생성
gamma가 클수록 가까운 데이터에 더 민감C와 gamma가 너무 크면 과대적합 위험 증가- 훈련 정확도와 테스트 정확도를 함께 확인
svm_rbf_clf = make_pipeline(
    StandardScaler(),
    SVC(kernel='rbf', C=1.0, gamma='scale')
)

svm_rbf_clf.fit(X_train, y_train)
y_pred_svm_rbf = svm_rbf_clf.predict(X_test)
accuracy_score(y_test, y_pred_svm_rbf)
실습 데이터: 온라인 강의 완주 예측
- 수업용 합성 온라인 학습 기록 800건
- 첫 주 학습 행동으로 최종 강의 완주 여부 예측
- 모든 입력 변수가 숫자형이므로 앞에서 사용한 분류 코드를 그대로 적용
completed는 0=미완주, 1=완주
| 컬럼 | 설명 |
|---|
login_days_week1 | 첫 주 로그인 일수 |
video_watch_pct_week1 | 첫 주 동영상 시청률(%) |
quiz_attempts_week1 | 첫 주 퀴즈 응시 횟수 |
assignment_submitted_week1 | 첫 주 과제 제출 여부(0/1) |
forum_visits_week1 | 첫 주 게시판 방문 횟수 |
previous_courses_completed | 이전 완주 강의 수 |
planned_study_hours_week | 주당 계획 학습시간 |
completed | 최종 완주 여부(0=미완주, 1=완주) |
데이터 불러오기와 X, y 선택
import pandas as pd

df_course = pd.read_excel("online_course_completion.xlsx")
df_course.head()
X = df_course.drop(columns="completed")
y = df_course["completed"]
- 위에서 사용한 데이터 분할과 분류 모델 코드를 다시 실행하여 다음 문제에 답하세요.
