K-Means
k-평균 군집화
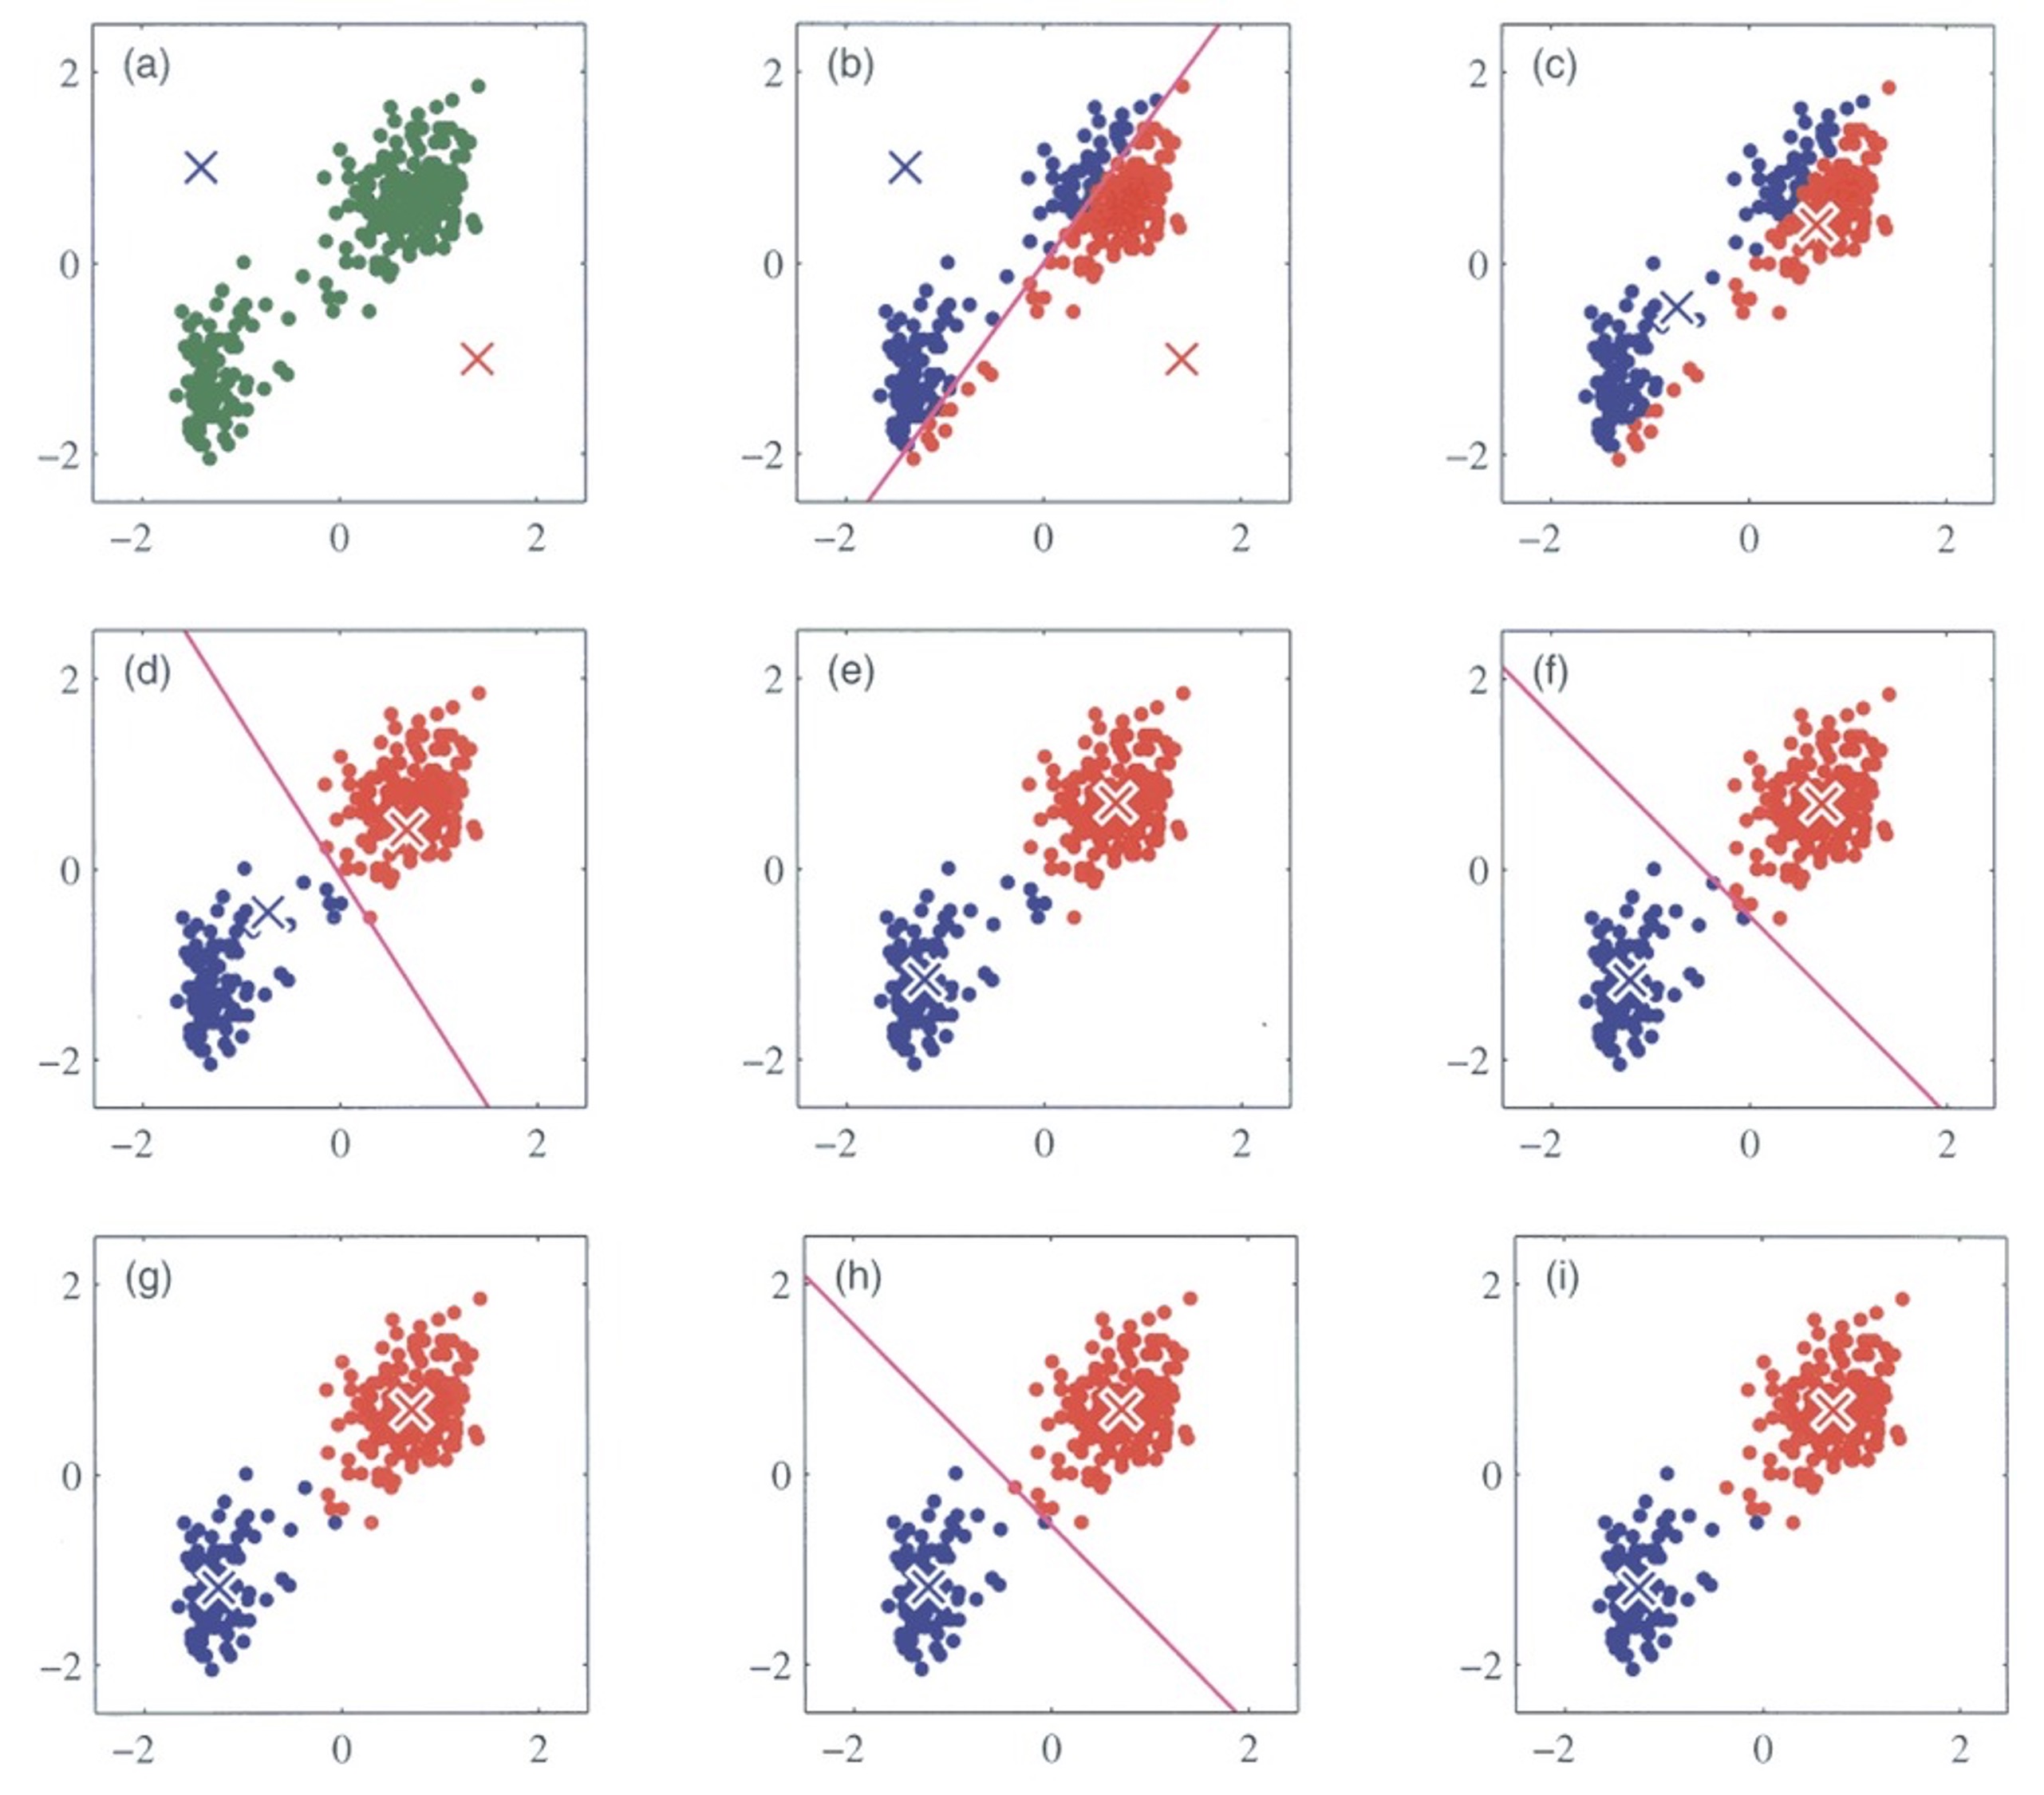
- 대표적인 파티션 클러스터링 알고리즘 중 하나
- K-Means: "K개의 평균"이라는 뜻
- 각 사례가 다른 군집보다 자신이 속한 군집의 중심점에 가장 가깝게 만듦
- 각 군집의 중심점은 해당 군집에 속한 사례들의 평균
- 예시 절차
- 사례들을 두 개의 군집으로 나눌 경우, 무작위로 두 군집의 중심점을 설정
- 각 사례들을 두 중심점 중 더 가까운 중심점의 군집으로 분류
- 각 군집에 속한 사례들을 평균하여 새로운 중심점을 설정
- 더 이상 군집에 변화가 없을 때까지 분류와 중심점 갱신을 반복
실습 프롬프트
🤖 AI 프롬프트
ship_cluster.xlsx의 선박 운항 사례를 K-Means로 군집화해줘.
case_id와 operation_case를 제외한 나머지 열을 입력으로 사용해.
군집 수는 3개
첫 다섯 행의 클러스터링 결과와 관성을 보여줘.
파이썬 코드와 초보자를 위한 한글 주석을 작성해줘.
K-Means 실습: 데이터 로딩
- 실습 패키지 설치
pip install pandas matplotlib seaborn scikit-learn openpyxl numpy
- 임포트와 파일 불러오기
import pandas as pd
import matplotlib.pyplot as plt
import seaborn as sns
from sklearn.cluster import KMeans
from sklearn.preprocessing import StandardScaler

df_ship = pd.read_excel('ship_cluster.xlsx')
K-Means 실습: 군집에 사용할 변수 선택
feature_cols = [
    'route_distance_nm',
    'avg_payload_ton',
    'daily_engine_hour',
    'service_speed_knot',
    'fuel_use_ton_day',
    'port_stay_hour',
    'maintenance_interval_day',
]

X_cluster = df_ship[feature_cols]
X_cluster.shape  # 사례 수와 입력 변수 수
실행 결과
(135, 7)
- 선박 운항 사례 135건, 군집화에 사용할 변수 7개
표준화의 필요성
- K-Means는 두 데이터 점 사이의 거리를 기준으로 비슷한 정도 계산
- 운항거리, 적재량, 연료 사용량처럼 여러 변수의 차이를 합쳐 거리 계산
- 변수 범위가 다르면 큰 숫자의 변수가 군집 결과를 좌우
- 표준화는 변수마다 평균 0, 표준편차 1로 맞춰 같은 기준에서 비교
K-Means 실습: 표준화 및 군집화
- 여러 운항 변수를 함께 사용해 군집화
- 각 운항 사례에 군집 번호 부여
# 변수 기준 맞추기
X_scaled = StandardScaler().fit_transform(X_cluster)

# 군집 수를 3개로 지정하고 군집 번호 생성
kmeans = KMeans(n_clusters=3, random_state=42, n_init=10)
df_ship['cluster'] = kmeans.fit_predict(X_scaled)

df_ship[['case_id', 'operation_case', 'cluster']].head()
실행 결과
  case_id      operation_case  cluster
0   OP099  offshore_logistics        1
1   OP068      coastal_supply        0
2   OP106  offshore_logistics        1
3   OP020       port_rotation        2
4   OP043       port_rotation        2
cluster: 각 운항 사례에 부여된 군집 번호- 군집 번호는 그룹 구분용이며 크기나 우열을 의미하지 않음
관성
- 관성(inertia)
- K-Means에서 자주 쓰는 평가 지표
- 각 데이터가 자신이 속한 군집 중심에서 얼마나 떨어져 있는지를 제곱해 모두 더한 값
- 관성이 작을수록 군집 내부가 더 조밀하다는 뜻
- 단, 군집 수를 늘리면 관성은 거의 항상 작아지므로 단독 기준으로 쓰기 어려움
kmeans.inertia_ # 표준화한 데이터의 군집 내 거리 제곱합
실행 결과
68.47501571220504
- 군집 3개의 관성은 약 68.48
- 같은 데이터와 표준화 조건에서 다른 군집 수의 관성과 비교
최적의 군집 개수 탐색: 엘보우 방법
🤖 AI 프롬프트
K=1부터 7까지의 관성을 표와 그래프로 비교해줘.
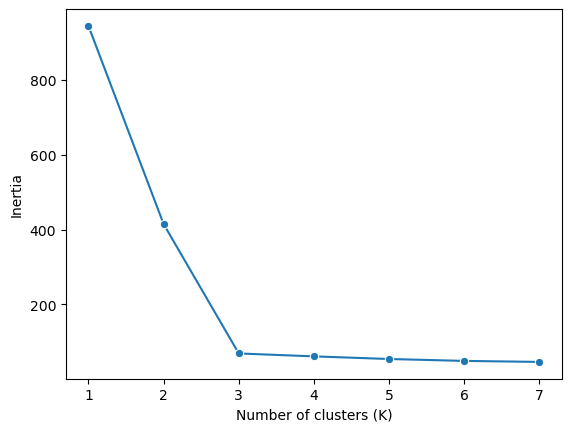
- K-Means는 몇 개의 묶음(K)으로 나눌지 분석가가 사전에 결정해야 함
- K를 1개부터 늘려가며 관성(inertia)을 계산
- 관성: 군집 안 거리의 제곱합, 즉 군집이 퍼진 정도
- K가 늘면 관성이 줄지만, 어느 순간부터 개선 폭 감소
- 그래프가 급하게 내려가다 완만해지는 지점을 후보 K로 판단
- 실습 데이터에서는 K=3 부근의 변화 확인
inertia = []

for k in range(1, 8):
    km = KMeans(n_clusters=k, random_state=42, n_init=10).fit(X_scaled)
    inertia.append(km.inertia_)

pd.DataFrame({"n_clusters": range(1, 8), "inertia": inertia})
실행 결과
   n_clusters     inertia
0           1  945.000000
1           2  414.772130
2           3   68.475016
3           4   60.665505
4           5   53.623641
5           6   48.533510
6           7   45.817593
- K=2에서 K=3으로 늘릴 때 관성은 약 414.77에서 68.48로 크게 감소
- K=4에서는 약 60.67로 감소 폭이 작아져 K=3을 후보로 선택
plt.figure()
sns.lineplot(x=range(1, 8), y=inertia, marker="o")
plt.xlabel("Number of clusters (K)")
plt.ylabel("Inertia")
plt.show()
군집 분리 정도 확인: 실루엣 계수
🤖 AI 프롬프트
K=2부터 7까지의 실루엣 계수를 표와 그래프로 비교해줘.
- 각 데이터가 같은 군집에는 얼마나 가깝고 다른 군집에는 얼마나 먼지 평가
- 값의 범위는 −1부터 1
- 1에 가까울수록 군집 내부는 조밀하고 군집 사이는 잘 분리됨
- 0에 가까우면 군집 경계가 서로 겹침
- 음수이면 다른 군집에 더 가까운 데이터가 있을 수 있음
- 여러 K의 실루엣 계수를 비교하되 엘보우 결과와 해석 가능성도 함께 고려
from sklearn.metrics import silhouette_score

silhouette_scores = []

for k in range(2, 8):
    labels = KMeans(
        n_clusters=k, random_state=42, n_init=10
    ).fit_predict(X_scaled)
    silhouette_scores.append(silhouette_score(X_scaled, labels))

pd.DataFrame({
    "n_clusters": range(2, 8),
    "silhouette_score": silhouette_scores,
})
실행 결과
   n_clusters  silhouette_score
0           2          0.572614
1           3          0.761804
2           4          0.591116
3           5          0.418261
4           6          0.233808
5           7          0.212440
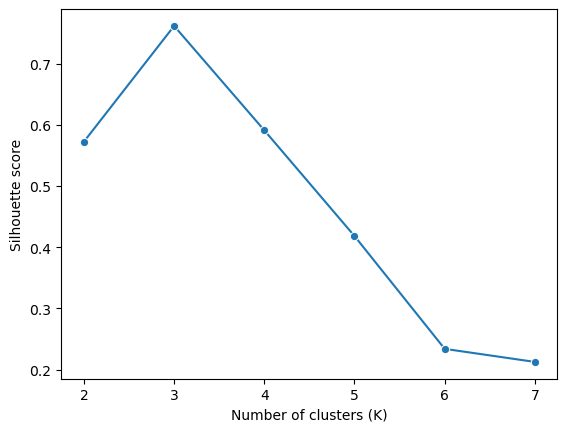
- 비교한 K 중 K=3의 실루엣 계수가 약 0.7618로 가장 높음
- 엘보우 결과와 함께 보면 군집 3개가 적절한 후보
plt.figure()
sns.lineplot(x=range(2, 8), y=silhouette_scores, marker="o")
plt.xlabel("Number of clusters (K)")
plt.ylabel("Silhouette score")
plt.show()
퀴즈
실습 데이터: 물류센터 작업 패턴
- 물류센터 작업 기록 480건
- 일별 주문량, 피킹 작업, 인력, 설비 가동률, 초과근무 패턴으로 운영 유형 탐색
- 정답 라벨 없이 여섯 개 숫자형 변수를 표준화하여 K-Means 적용
| 컬럼 | 설명 |
|---|---|
operation_id |
작업 기록 식별자 |
daily_order_count |
일일 처리 주문 수(건) |
avg_picking_min |
주문당 평균 피킹 시간(분) |
picking_error_pct |
피킹 오류율(%) |
worker_count |
작업 인원(명) |
equipment_utilization_pct |
설비 가동률(%) |
overtime_hour |
일평균 초과근무 시간(시간) |
🤖 AI 프롬프트
warehouse_operations.xlsx에서 operation_id를 제외한 여섯 숫자형 변수를 표준화해줘.
KMeans의 random_state=42, n_init=10을 고정하고,
K=1부터 8까지의 관성과 K=2부터 8까지의 실루엣 계수를 비교해줘.
K=4일 때의 관성과 실루엣 계수도 계산해줘.
군집 수 후보를 해석하고, 파이썬 코드와 한글 주석을 작성해줘.
데이터 불러오기와 변수 선택
df_warehouse = pd.read_excel("warehouse_operations.xlsx")

warehouse_feature_cols = [
    "daily_order_count",
    "avg_picking_min",
    "picking_error_pct",
    "worker_count",
    "equipment_utilization_pct",
    "overtime_hour",
]

X_warehouse = df_warehouse[warehouse_feature_cols]
X_warehouse_scaled = StandardScaler().fit_transform(X_warehouse)
- 위에서 사용한 K-Means, 엘보우 방법, 실루엣 계수 코드를 적용하여 다음 문제에 답하세요.
물류센터 실습에서 별도의 정답 변수 y를 선택하지 않는 이유는?
퀴즈를 풀려면 대화형 기능을 불러와야 합니다.