주성분 회전
- 차원 축소 장의 PCA 실습과 분산 설명력 실습에 이어서 진행
- 앞에서 만든
df_brand,feature_cols,X_scaled를 그대로 사용 - 분산 설명력으로 정한 주성분 2개를 회전
주성분 회전
🤖 AI 프롬프트
factor_analyzer로 varimax 회전을 적용해서 회전 후 성분 적재량을 보여줘.
회전한 성분 점수로 브랜드 이름을 표시한 산점도를 그려줘.
- PCA 결과는 한 변수가 여러 주성분에 동시에 크게 걸리는 경우가 많아 해석이 어려움
- 주성분 회전(rotation): PC1, PC2 축을 함께 돌려서 각 변수가 한 성분에만 크게 걸리도록 만드는 방법
- 축만 돌리므로 두 성분이 함께 담는 정보의 양은 그대로이고, 성분별로 나눠 갖는 몫만 바뀜
varimax 회전
fa_rot = FactorAnalyzer(n_factors=2, method="principal", rotation="varimax")
fa_rot.fit(X_scaled)

pd.DataFrame(fa_rot.loadings_, index=feature_cols, columns=["RC1", "RC2"]).round(2)
실행 결과
             RC1   RC2
quality     0.97 -0.18
atmosphere  0.93 -0.32
special     0.91 -0.33
gift        0.95 -0.07
accessible -0.27  0.92
fast       -0.45  0.85
casual     -0.19  0.96
ordering   -0.14  0.95
cheap      -0.81  0.52
- 회전한 성분은 PC와 구분해 RC(Rotated Component)1, RC2로 표기
- 회전 후에는
cheap,fast를 뺀 7개 문항이 한 성분에만 크게(0.9 이상) 걸림
| 변수 | 회전 전 PC1 | 회전 전 PC2 | 회전 후 RC1 | 회전 후 RC2 |
|---|---|---|---|---|
quality |
-0.85 | 0.50 | 0.97 | -0.18 |
atmosphere |
-0.91 | 0.37 | 0.93 | -0.32 |
special |
-0.90 | 0.35 | 0.91 | -0.33 |
gift |
-0.76 | 0.57 | 0.95 | -0.07 |
accessible |
0.81 | 0.51 | -0.27 | 0.92 |
fast |
0.90 | 0.34 | -0.45 | 0.85 |
casual |
0.77 | 0.60 | -0.19 | 0.96 |
ordering |
0.73 | 0.62 | -0.14 | 0.95 |
cheap |
0.95 | -0.14 | -0.81 | 0.52 |
- 굵은 글씨는 절댓값 0.4 이상인 적재량
- 회전 전에는
quality,gift,accessible,casual,ordering이 PC1, PC2 양쪽에 모두 크게 걸림 cheap: 회전 후에도 두 성분에 함께 걸림- 교차 적재(cross-loading): 한 변수가 여러 성분에 크게 걸리는 것
- 저렴하다는 평가는 RC1과 반대로, RC2와 같은 방향으로 움직임
fast도 RC2(0.85)에 주로 걸리지만 RC1에도 -0.45로 걸림- 빨리 나오는 브랜드일수록 프리미엄 이미지는 약한 편
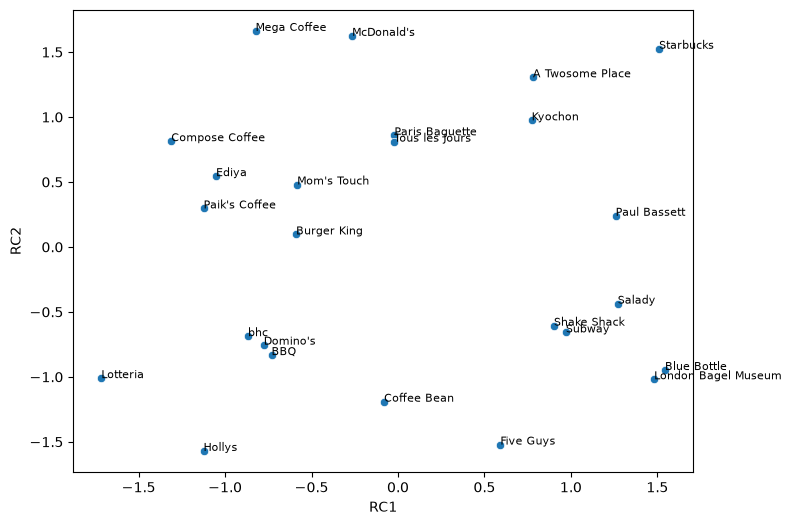
브랜드 지각도
- 지각도(perceptual map): 소비자가 여러 브랜드를 어떻게 인식하는지 평면 위에 나타낸 그림
transform으로 각 브랜드의 회전한 성분 점수 계산ax.text: 각 점 위치에 브랜드 이름 표시
scores = fa_rot.transform(X_scaled)

df_rot = df_brand.copy()
df_rot["RC1"] = scores[:, 0]
df_rot["RC2"] = scores[:, 1]

import matplotlib.pyplot as plt
plt.figure(figsize=(8, 6))  # 이름이 겹치지 않도록 그림을 크게

ax = sns.scatterplot(data=df_rot, x="RC1", y="RC2")
for _, row in df_rot.iterrows():
    ax.text(row["RC1"], row["RC2"], row["brand"], fontsize=8)  # fontsize: 이름이 겹치지 않도록 작게
회전한 성분 해석
| 성분 | 크게 걸리는 변수 | 해석 |
|---|---|---|
| RC1 | 품질(+), 분위기(+), 특별한 날(+), 선물(+), 저렴함(-) | 프리미엄 |
| RC2 | 접근성(+), 빠름(+), 가볍게 들르기(+), 주문 편의(+), 저렴함(+) | 편의성 |
- 지각도에서 브랜드의 위치
- 오른쪽 아래(프리미엄 높음, 편의성 낮음): Blue Bottle, London Bagel Museum, Salady, Subway, Shake Shack, Five Guys
- 왼쪽 위(프리미엄 낮음, 편의성 높음): Mega Coffee, Compose Coffee, Paik's Coffee, McDonald's
- 오른쪽 위(둘 다 높음): Starbucks가 두 축 모두 1.5 정도로 가장 오른쪽 위. A Twosome Place, Kyochon도 이쪽
- 왼쪽 아래(둘 다 낮음): Lotteria, Hollys, bhc, BBQ, Domino's
- 같은 버거 업종에서도 McDonald's와 Five Guys는 정반대 위치
- 차원 축소 실습의 산점도에서 업종끼리 모이지 않은 이유
- 성분 이름(프리미엄, 편의성)은 분석가가 적재량을 보고 붙이는 것이므로, 도메인 지식으로 검토 필요
회전 후 분산 설명력
- 회전하면 성분별 분산 설명력은 바뀌지만, 두 성분의 누적 분산 설명력은 그대로
fa_rot.get_factor_variance()
실행 결과
(array([4.51050985, 3.90374271]),
 array([0.50116776, 0.43374919]),
 array([0.50116776, 0.93491695]))
- 분산 설명력이 PC1 71.5%, PC2 22.0%에서 RC1 50.1%, RC2 43.4%로 바뀜
- 두 성분의 누적 분산 설명력은 회전 전과 같은 93.5%
퀴즈
주성분 회전을 하는 주된 목적으로 가장 적절한 것은?
퀴즈를 풀려면 대화형 기능을 불러와야 합니다.