매니폴드 학습
비슷한 것끼리 가깝게 표현하기
- 새 변수를 만드는 것보다, 비슷한 관측치끼리 가까이 모이도록 하는 것이 목적인 방법
- 고차원 데이터를 시각화할 때 주로 사용
- 예시: 손글씨 숫자 이미지가 8×8 = 64개 픽셀로 이루어진 경우
- 픽셀 하나가 변수 하나이므로 64차원 데이터 → 시각화가 불가능
- 64차원에서 가까운 이미지를 2차원에서 가까운 점으로 표현하여 시각화
t-SNE
- t-SNE(t-Distributed Stochastic Neighbor Embedding): 모든 거리를 살리려 하지 않고, 가까운 이웃 관계를 살리는 데 집중하는 방법
- 원래 공간에서 이웃이던 점들은 그림에서도 꼭 이웃으로 놓음
- 멀리 있던 점들은 멀리 떨어뜨려 놓기만 하고, 얼마나 먼지는 정확히 맞추지 않음
- 그림을 해석할 때 주의할 점
- 무리가 보이는 것은 의미 있음: 비슷한 관측치끼리 모여 있다는 뜻
- 무리의 크기와 무리 사이의 거리는 그대로 해석하면 안 됨: t-SNE는 가까운 이웃 관계만 신경 쓰기 때문
- 실행할 때마다 그림 모양이 달라질 수 있음
- 데이터가 많으면 계산이 오래 걸림
t-SNE는 어떻게 계산하나
- 원래 공간에서 점마다 "다른 점이 내 이웃일 확률"을 계산. 가까울수록 확률이 높음(정규분포 사용)
- 2D 그림에서도 같은 방식으로 이웃 확률을 계산(t분포 사용)
- 두 확률이 최대한 비슷해지도록 그림 속 점의 위치를 조금씩 옮김. 두 확률의 차이는 KL 발산이라는 값으로 측정
- 2D 쪽에 꼬리가 두꺼운 t분포를 쓰기 때문에, 먼 점들은 더 멀리 밀려나고 서로 다른 무리가 더 뚜렷하게 떨어져 보임
실습 프롬프트
🤖 AI 프롬프트
scikit-learn의 손글씨 숫자 데이터(load_digits)를 PCA와 t-SNE로 각각 2차원으로 줄여
숫자별로 색을 다르게 한 산점도를 그려 비교해줘.
Python 코드를 작성하고, 초보자를 위한 한글 주석을 달아줘.
실습: 데이터 불러오기
- scikit-learn에 포함된 손글씨 숫자 데이터 사용
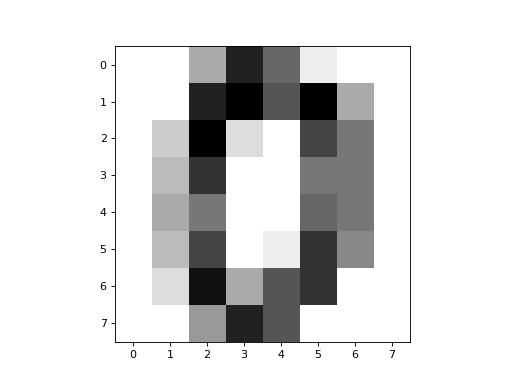
- 이미지 1,797개, 각 이미지는 8×8 = 64개 픽셀
y는 이미지가 나타내는 숫자(0-9)
from sklearn.datasets import load_digits

X, y = load_digits(return_X_y=True)
X.shape
실행 결과
(1797, 64)
첫 번째 이미지를 8×8로 되돌려 그려보면 숫자 0이다.
import matplotlib.pyplot as plt

# 첫 번째 이미지(64개 값)를 8×8로 되돌려 흑백으로 그림 (gray_r: 값이 클수록 검게)
plt.imshow(X[0].reshape(8, 8), cmap="gray_r")
PCA로 2차원 그리기
from sklearn.decomposition import PCA
import seaborn as sns

X_pca = PCA(n_components=2).fit_transform(X)  # 64차원을 PCA로 2차원으로 축소
sns.scatterplot(
  x=X_pca[:, 0],     # 가로축: 첫 번째 주성분
  y=X_pca[:, 1],     # 세로축: 두 번째 주성분
  hue=y,             # 실제 숫자(0-9)에 따라 색을 다르게
  palette="tab10",   # 10가지 색을 구분하기 쉬운 색 조합
  legend="full",     # 범례에 숫자 10개를 모두 표시
  s=10)              # 점 크기
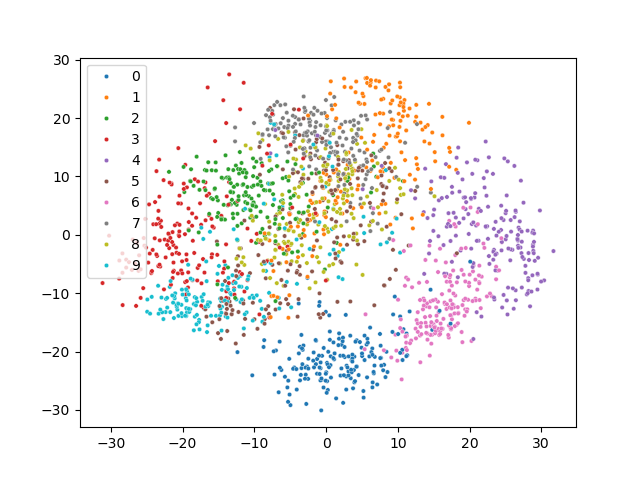
- 0, 4, 6처럼 바깥쪽에 따로 모이는 숫자도 있음
- 하지만 1, 5, 7, 8 등은 가운데에 뒤섞여 구분하기 어려움
t-SNE로 2차원 그리기
from sklearn.manifold import TSNE

# 64차원을 t-SNE로 2차원으로 축소 (random_state: 실행할 때마다 같은 그림이 나오도록 고정)
X_tsne = TSNE(n_components=2, random_state=0).fit_transform(X)
sns.scatterplot(
  x=X_tsne[:, 0],    # 가로축: t-SNE 첫 번째 좌표
  y=X_tsne[:, 1],    # 세로축: t-SNE 두 번째 좌표
  hue=y,             # 실제 숫자(0-9)에 따라 색을 다르게
  palette="tab10",   # 10가지 색을 구분하기 쉬운 색 조합
  legend="full",     # 범례에 숫자 10개를 모두 표시
  s=10)              # 점 크기
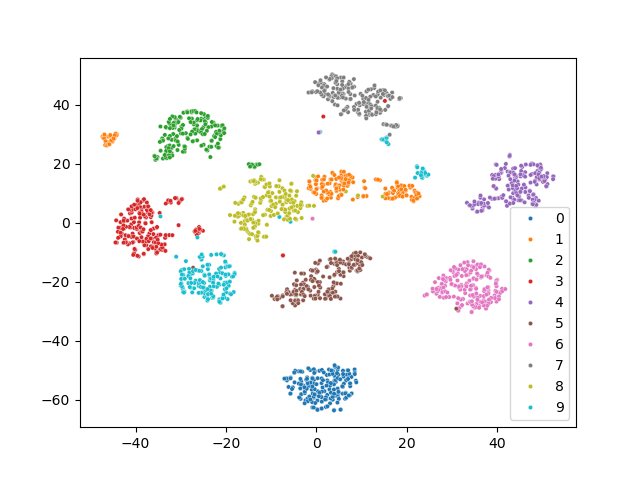
- 숫자별로 무리가 뚜렷하게 나뉨
- 같은 숫자가 두세 개의 작은 무리로 나뉘기도 함: 같은 숫자라도 쓰는 방식이 여러 가지이기 때문
random_state를 바꾸면 무리의 위치와 모양이 달라지지만, 숫자별로 나뉜다는 결과는 비슷함
퀴즈
매니폴드 학습의 주된 목적으로 가장 적절한 것은?
퀴즈를 풀려면 대화형 기능을 불러와야 합니다.