분류 평가 지표
특이도와 위양성률을 계산하고 분류 평가 지표의 분모와 활용 목적 비교
- 혼동행렬 실습의 테스트 정답
y_test와 예측 결과y_pred를 그대로 사용
특이도
- 특이도(specificity): 실제 음성 중 음성으로 찾아낸 비율
- 실습: 정상 부품 1,357개 중 정상으로 찾아낸 1,200개의 비율, 약 88.4%
- 음성을 찾아내는 것이 중요한 경우 사용
- 예: 방역
- 대체로 양성 예측을 보수적으로 하면 특이도가 높아짐
- 위양성률(false positive rate, FPR): 실제 음성을 양성으로 잘못 예측한 비율
pos_label=0: 정상 클래스의 재현도를 계산해 특이도 확인
from sklearn.metrics import recall_score

recall_score(y_test, y_pred, pos_label=0)
실행 결과
0.8843036109064112
특이도가 낮을 경우 문제점
- 질병 검사에서는 음성이 양성보다 훨씬 많은 경우가 많음
- 특이도가 낮으면 실제 음성이 양성으로 잘못 잡히는 위양성이 많아짐
- 실제 양성 비율과 민감도가 같을 때 위양성이 많아지면 정밀도 감소
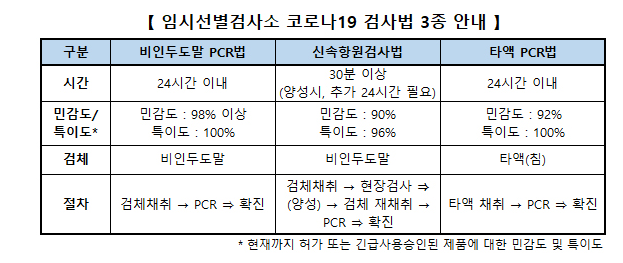
- 실제 양성이 1%인 경우
- 민감도 98%, 특이도 100%일 때: 정밀도 100%
| 실제\예측 | 음성 | 양성 |
|---|---|---|
| 음성 | 9900 | 0 |
| 양성 | 2 | 98 |
- 민감도 90%, 특이도 96%일 때: 정밀도 18.5%
- 약간만 특이도가 낮아도, 정밀도가 크게 떨어짐
| 실제\예측 | 음성 | 양성 |
|---|---|---|
| 음성 | 9504 | 396 |
| 양성 | 10 | 90 |
평가지표
- 분류 모델의 평가지표는 어떤 오류를 더 중요하게 볼 것인지에 따라 선택
- 정확도는 전체 정답률을 보지만, 클래스 불균형이 크면 모델 성능을 과대평가할 수 있음
- 정밀도는 양성 예측의 신뢰도를, 재현도는 실제 양성 탐지 능력을 강조
- F1은 정밀도와 재현도를 함께 고려해야 할 때 사용
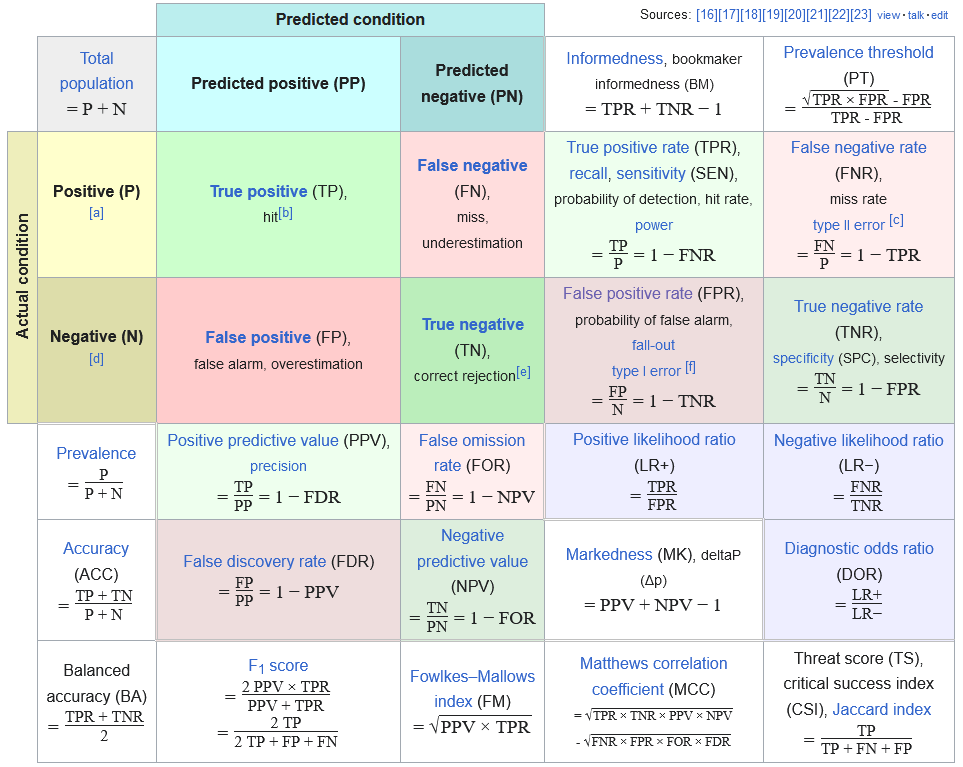
같은 예측에서 지표가 다른 이유
| 지표 | 분모 | 실습 결과 |
|---|---|---|
| 정확도 | 전체 2,000개 | 74.3% |
| 정밀도 | 불량으로 예측한 443개 | 약 64.6% |
| 재현도 | 실제 불량 부품 643개 | 약 44.5% |
| 특이도 | 실제 정상 부품 1,357개 | 약 88.4% |
| F1 | 정밀도와 재현도의 조화 평균 | 약 52.7% |
- 전체 정답률이 74.3%여도 실제 불량 부품의 절반 이상을 놓친 상태
- 어떤 오류가 중요한지 정한 뒤 지표 선택.
퀴즈
불량을 양성으로 정한 실습에서 특이도는 무엇을 나타내나요?
퀴즈를 풀려면 대화형 기능을 불러와야 합니다.