배깅
배깅
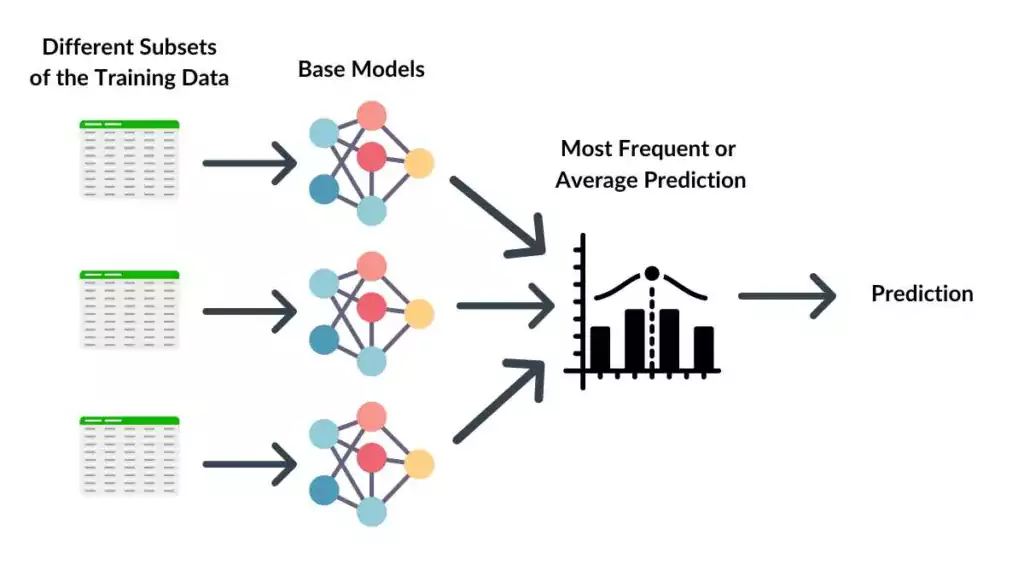
- 배깅(bagging): bootstrap aggregation의 약자
- 원래 데이터에서 복원추출해 같은 크기의 학습 데이터 여러 개 생성
- 복원추출: 뽑은 사례를 다시 넣고 추출하므로 같은 사례가 여러 번 포함 가능
- 각 학습 데이터로 여러 모델을 독립적으로 학습
- 각 모델은 조금씩 다른 데이터를 보고 학습
- 최종 예측은 여러 모델의 평균 또는 다수결
- 대표 모델: 랜덤 포레스트(random forest)
실습 준비
- 앙상블 문서에서 데이터를 불러오고 분할한 노트북에서 이어서 실행
- 앞에서 준비한
X,X_train,X_test,y_train,y_test를 그대로 사용
실습 프롬프트
🤖 AI 프롬프트
앙상블 문서에서 준비한 데이터센터 장애 예측 데이터로 단일 결정트리와 랜덤 포레스트를 비교하는 코드를 작성해줘.
X, X_train, X_test, y_train, y_test는 앞에서 준비한 변수를 그대로 사용해.
타깃 incident_next_hour에서 0은 정상, 1은 1시간 이내 장애 발생이야.
단일 결정트리는 max_depth=4, random_state=42로 설정해줘.
랜덤 포레스트는 n_estimators=200, random_state=42로 설정해줘.
학습 데이터로 두 모델을 학습하고 테스트 정확도를 비교해줘.
랜덤 포레스트의 변수 중요도를 내림차순 표와 막대그래프로 보여줘.
필요한 라이브러리를 불러오고 각 단계에 초보자를 위한 한글 주석을 달아줘.
비교 기준: 단일 결정트리
- 깊이 4인 결정트리 하나를 학습해 랜덤 포레스트와 비교
from sklearn.metrics import accuracy_score
from sklearn.tree import DecisionTreeClassifier

tree_clf = DecisionTreeClassifier(max_depth=4, random_state=42)
tree_clf.fit(X_train, y_train)
y_pred_tree = tree_clf.predict(X_test)
accuracy_score(y_test, y_pred_tree)
실행 결과
0.715
- 단일 결정트리의 테스트 정확도: 71.5%
랜덤 포레스트 분류 실습
- 복원추출한 데이터로 여러 결정트리를 학습해 예측 결합
- 각 분할에서 무작위로 선택한 특성 후보를 사용해 나무 사이의 다양성 확보
- 단일 결정트리보다 과대적합에 강한 편
from sklearn.ensemble import RandomForestClassifier

rf_clf = RandomForestClassifier(
    n_estimators=200,  # 결합할 결정트리 수
    random_state=42,
)
rf_clf.fit(X_train, y_train)

y_pred_rf = rf_clf.predict(X_test)
accuracy_score(y_test, y_pred_rf)
실행 결과
0.73
- 랜덤 포레스트의 테스트 정확도: 73.0%. 이 분할에서는 단일 결정트리보다 1.5%p 높은 결과
랜덤 포레스트 변수 중요도
- 변수 중요도는 모델이 어떤 변수를 많이 활용했는지 확인하는 값
- 높은 중요도는 나무의 분할에서 불순도 감소에 많이 기여했다는 의미
- 인과관계를 바로 의미하지는 않음
import seaborn as sns
import matplotlib.pyplot as plt

importance = pd.DataFrame({
    "feature": X.columns,
    "importance": rf_clf.feature_importances_,
}).sort_values("importance", ascending=False).head(10)

importance
실행 결과
                 feature  importance
3   request_rate_per_sec    0.164793
0           cpu_util_pct    0.137354
4         p95_latency_ms    0.131172
2           disk_io_mb_s    0.124332
1        memory_util_pct    0.108523
5        packet_loss_pct    0.100653
8            room_temp_c    0.096613
7            uptime_days    0.089891
6  recent_deployments_7d    0.046669
- 이 모델에서 중요도가 가장 높은 변수:
request_rate_per_sec
sns.barplot(data=importance, x="importance", y="feature")
plt.show()
퀴즈
배깅(bagging)에 대한 설명으로 가장 적절한 것은?
퀴즈를 풀려면 대화형 기능을 불러와야 합니다.