주성분 분석
주성분 분석
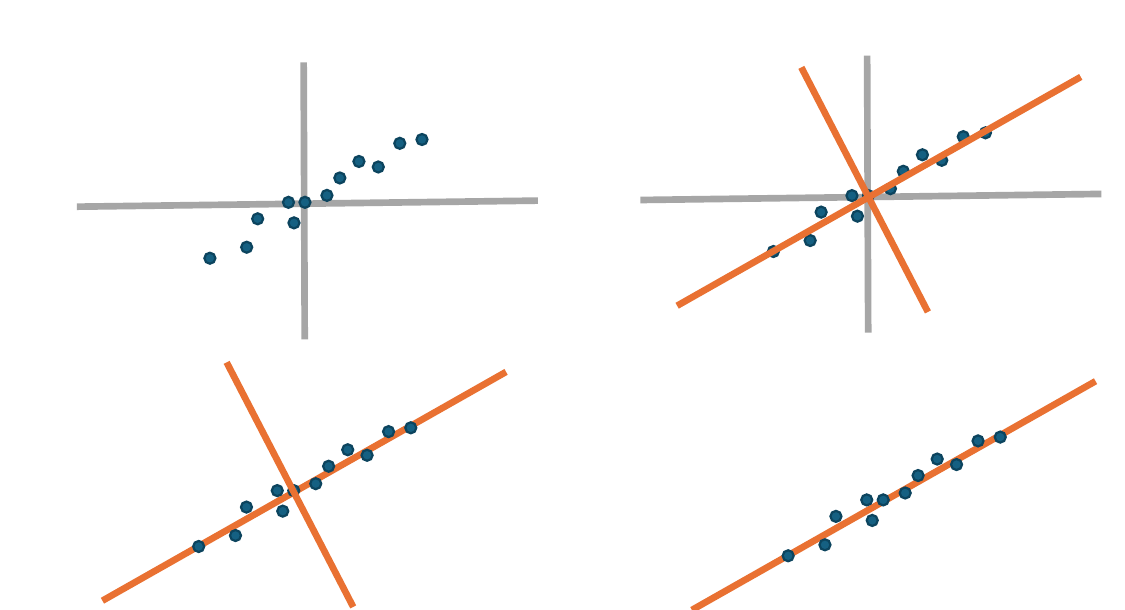
- 주성분 분석(Principal Component Analysis, PCA)
- 여러 변수가 함께 움직이는 방향을 새 축으로 만드는 방법
- 제1주성분(PC1): 데이터가 가장 크게 퍼지는 방향
- 제2주성분(PC2): PC1과 직교하면서 남은 분산을 가장 많이 보존하는 방향
- 원래 변수들을 서로 상관이 없는 새 축으로 바꿔 표현
- 일부 정보 손실은 있지만 설명력으로 손실 정도 확인 가능
실습 준비
실습 프롬프트
🤖 AI 프롬프트
ship_cluster.xlsx에 PCA를 적용해라.
case_id와 operation_case를 제외한 나머지 열을 입력으로 사용해.
표준화한 뒤 PC1과 PC2를 만들고 산점도를 그려줘.
Python 코드를 작성하고, 초보자를 위한 한글 주석을 달아줘.
PCA 실습: 데이터 로딩
- K-Means 실습과 같은 7개 운항 변수 사용
- PCA로 PC1, PC2의 2차원으로 압축
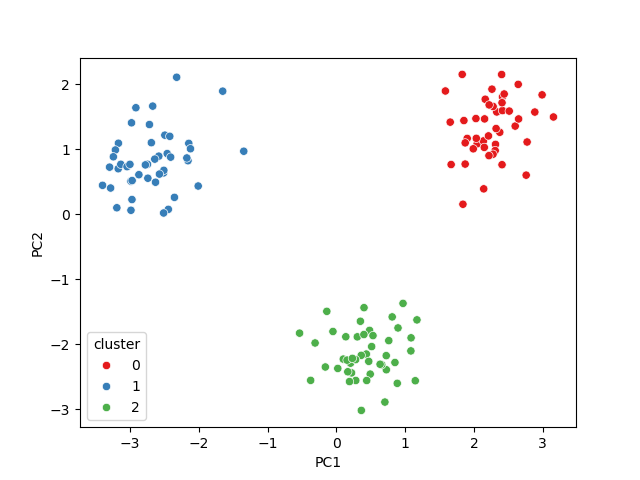
- K-Means 군집 번호를 색상으로 표시해 군집 분리 정도 확인
import pandas as pd
import matplotlib.pyplot as plt
import seaborn as sns
from sklearn.cluster import KMeans
from sklearn.decomposition import PCA
from sklearn.preprocessing import StandardScaler

df_ship = pd.read_excel("ship_cluster.xlsx")
PCA 실습: 변수 선택 및 표준화
feature_cols = [
    "route_distance_nm",
    "avg_payload_ton",
    "daily_engine_hour",
    "service_speed_knot",
    "fuel_use_ton_day",
    "port_stay_hour",
    "maintenance_interval_day",
]

X_cluster = df_ship[feature_cols]
X_scaled = StandardScaler().fit_transform(X_cluster)
PCA 실습: PCA 실시
pca = PCA(n_components=2)
pc = pca.fit_transform(X_scaled)

df_pca = df_ship.copy()
df_pca["PC1"] = pc[:, 0]
df_pca["PC2"] = pc[:, 1]

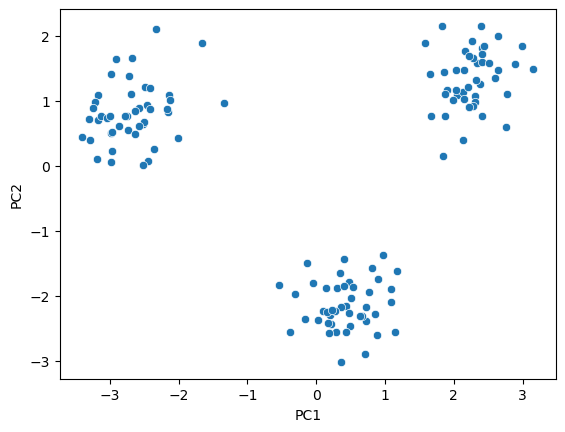
sns.scatterplot(data=df_pca, x="PC1", y="PC2")
PCA 실습: K-Means 시각화
🤖 AI 프롬프트
입력변수에 KMeans 적용해서 3개 군집을 만들어
군집 번호를 PCA 산점도의 색상으로 표시해줘.
kmeans = KMeans(n_clusters=3, random_state=42, n_init=10)
df_pca["cluster"] = kmeans.fit_predict(X_scaled)

sns.scatterplot(
    data=df_pca,
    x="PC1",
    y="PC2",
    hue="cluster",
    palette="Set1",
)
분산 설명력
- 분산 설명력(Explained Variance Ratio)
- 각 주성분이 입력 데이터의 전체 분산 중 얼마나 설명하는지 나타내는 비율
- 예: PC1이 60%, PC2가 20%를 설명하면 두 주성분으로 전체 분산의 80%를 보존
- 실습 데이터는 PC1, PC2만으로 대부분의 구조 확인 가능
pca.explained_variance_ratio_
실행 결과
array([0.61620809, 0.3599329 ])
엘보우 방법
🤖 AI 프롬프트
전체 주성분의 분산 설명력 스크리 플롯을 그려 주성분 수를 판단해줘.
- 주성분 수를 늘려가며 각 성분이 설명하는 분량의 변화를 그래프로 시각화
- 설명력이 급격히 낮아지는 엘보우 지점을 주성분 개수 후보로 선택
- 일반적으로 누적 분산 설명력이 80~90%를 넘어서는 지점을 기준으로 판단
import numpy as np

pca_full = PCA().fit(X_scaled)
evr = pca_full.explained_variance_ratio_

sns.lineplot(x=range(1, len(evr) + 1), y=evr, marker="o")

np.cumsum(evr)
실행 결과
array([0.61620809, 0.97614098, 0.98401056, 0.98884078, 0.99291924,
       0.99668853, 1.        ])
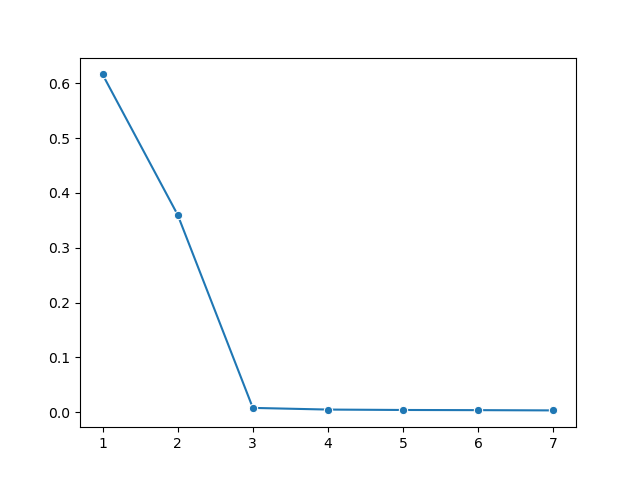
분산 설명력 결과 해석
- 실습 데이터는 PC1과 PC2로 약 97.6% 설명
- 2차원 산점도로 전체 구조 확인 가능
- PC1, PC2 평면에서 세 군집이 뚜렷하게 분리
- 군집 결과를 눈으로 확인할 때 PCA 시각화 활용
차원 축소를 전처리로 사용할 때
- PCA는 시각화뿐 아니라 모델 입력 변수 줄이기에도 사용
- 여러 운항 변수에서 몇 개 주성분을 만들고 예측 모델의 입력으로 사용 가능
- 설명력이 낮은 뒤쪽 주성분은 노이즈가 많을 수 있음
- 주의: 주성분은 원래 변수 의미와 바로 연결해 해석하기 어려움
퀴즈
실습 데이터: 설비 운전 상태 PCA
- 수업용 합성 설비 운전 기록 600건
- 단위와 범위가 다른 8개 센서·운전 변수로 PCA 수행
- 비표준화 PCA와 표준화 PCA의 분산 설명력 비교
operation_mode는 PCA 입력에서 제외하고 시각화 색상으로만 사용
| 컬럼 | 설명 |
|---|---|
motor_speed_rpm |
모터 회전 속도(rpm) |
torque_nm |
모터 토크(N·m) |
power_kw |
소비 전력(kW) |
vibration_mm_s |
진동 속도(mm/s) |
bearing_temp_c |
베어링 온도(°C) |
lubricant_temp_c |
윤활유 온도(°C) |
acoustic_db |
운전 소음(dB) |
coolant_flow_l_min |
냉각수 유량(L/min) |
operation_mode |
운전 모드(low_load, normal_load, high_load) |
데이터 불러오기와 변수 선택
import pandas as pd

df_machine = pd.read_excel("machine_operation_pca.xlsx")

feature_cols = [
    "motor_speed_rpm",
    "torque_nm",
    "power_kw",
    "vibration_mm_s",
    "bearing_temp_c",
    "lubricant_temp_c",
    "acoustic_db",
    "coolant_flow_l_min",
]

X_machine = df_machine[feature_cols]
- 다음 문제의 코드와 본문에서 사용한 PCA 코드를 실행하여 답하세요.
PCA에 대한 설명으로 맞는 것은?
퀴즈를 풀려면 대화형 기능을 불러와야 합니다.