
멀티모달과 피지컬 AI
텍스트 밖으로 넓어지는 AI 애플리케이션으로 네이티브 멀티모달과 실시간 음성, 영상 생성과 월드 모델, 로봇을 제어하는 비전-언어-행동 모델의 흐름을 살펴본다.
- 텍스트 입출력을 넘어 세 방향으로 확장: 입력·출력의 종류(멀티모달), 생성 대상(영상, 월드 모델), 행동(로봇, 피지컬 AI).
네이티브 멀티모달
- 네이티브 멀티모달(native multimodal): 한 모델이 이미지·음성도 토큰으로 바꿔 텍스트와 함께 처리. 생성 원리는 이미지 생성 모델, 오디오 생성 모델.
- 실시간 음성:
- 파이프라인(STT → LLM → TTS): 부품 교체가 쉽지만 지연이 쌓이고 억양·감정이 텍스트로 바뀌며 사라짐.
- 음성 대 음성(speech-to-speech): 한 모델이 음성을 직접 듣고 말함. 지연이 짧고 끼어들기 가능. 예: OpenAI gpt-realtime(2025-08).
- 함수 호출을 붙이면 음성 에이전트. 목소리 사칭, 음성 프롬프트 인젝션 같은 새 위험(가드레일).
출처: OpenAI(2025), Introducing gpt-realtime.
영상 생성과 월드 모델
- 영상 생성: 2025년부터 소리까지 함께 생성(Google Veo 3, OpenAI Sora 2). 물리 법칙을 얼마나 따르는지가 품질 기준.
- 월드 모델(world model): 현재 상태와 행동으로 다음 상태를 예측. 정해진 영상이 아니라 사용자·에이전트의 행동에 반응해 실시간으로 다음 장면을 만듦.
- 예: Genie 3(2025-08). 텍스트로 묘사한 세계를 실시간 생성해 돌아다니고 "비가 오게 하라"처럼 사건을 일으킴. 로봇·에이전트의 훈련장으로 쓰임.
출처: OpenAI(2025), Sora 2 is here. Google DeepMind(2025), Genie 3.
로봇 제어
- 9주 증강의 SayCan·Code as Policies: 언어 모델은 정해진 기술(집기, 옮기기)을 고르거나 조합할 뿐 모터를 직접 움직이지 않음.
- 비전-언어-행동 모델(Vision-Language-Action, VLA): 카메라 영상과 언어 지시를 받아 로봇 동작(관절·그리퍼 명령)을 직접 출력. 웹 지식이 동작으로 옮겨 감(RT-2, 2023: "멸종한 동물을 집어" → 공룡 장난감).
- 최근 흐름: Gemini Robotics 1.5(2025-09)는 추론 모델(ER)이 계획을 세우고 도구를 호출, VLA가 단계별로 실행. π0.7(2026-04)은 처음 보는 로봇에도 바로 적용.
Mermaid 다이어그램 원문
flowchart TD
    U[사용자 지시: 빨래를 색깔별로 분류해] --> P[추론 모델: 상황 파악·계획·도구 호출]
    P -- "다음 단계: 흰 셔츠를 왼쪽 바구니에" --> V[VLA: 카메라 영상 → 모터 명령]
    V --> W[실제 세계]
    W -- 카메라·센서 --> P
    W -- 카메라·센서 --> V
대화형 다이어그램을 불러오기 전에는 원문으로 표시됩니다.
- 11주 자율 에이전트의 계획·관찰 루프 + 정밀한 실행기(13주 오케스트레이션과 같은 분업).
- 차이: 행동을 되돌릴 수 없음. 데이터 부족, 지연, 물리적 안전이 남은 과제.
출처: Brohan 외(2023), RT-2. Google DeepMind(2025), Gemini Robotics 1.5. Physical Intelligence(2026), π0.7.
실습: 이미지 입력
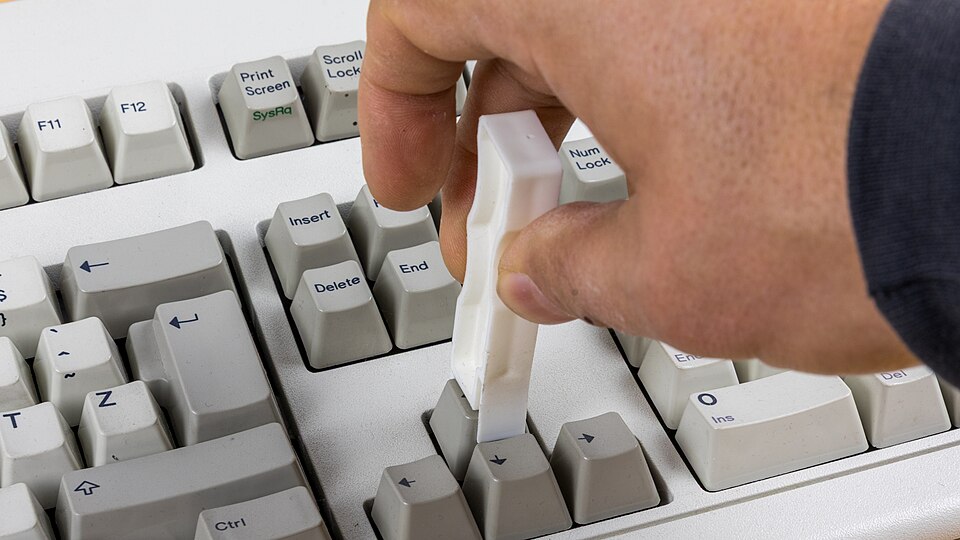
- 마인드몰 고객이 키보드 사진을 올리고 반품 가능 여부를 물음.
content에 텍스트(안내서 규정)와 이미지를 함께 보냄. - 사진: Raimond Spekking, IBM Keyboard Key Cap Removal Tool, CC BY-SA 4.0, Wikimedia Commons.

!pip install -q openai
from pathlib import Path
from openai import OpenAI

client = OpenAI(
    base_url="https://openrouter.ai/api/v1",
    api_key=Path("openrouter-key.txt").read_text().strip(),  # 키 파일에서 읽기
)
model = "openai/gpt-4.1-mini"  # 이미지 입력을 지원하는 모델
image_url = "https://upload.wikimedia.org/wikipedia/commons/thumb/9/92/IBM_Keyboard_Key_Cap_Removal_Tool-1180.jpg/960px-IBM_Keyboard_Key_Cap_Removal_Tool-1180.jpg"
from mindmall_guide import guide

return_policy = guide.split("\n## ")[4]  # 4. 교환과 반품

response = client.chat.completions.create(
    model=model,
    messages=[{
        "role": "user",
        "content": [
            {"type": "text", "text": f"""당신은 마인드몰 고객센터 직원입니다. 아래 규정과 고객이 올린 사진을 보고 답하세요.
사진에서 보이는 사실과 규정을 근거로, 단순 변심 반품이 가능한지 세 문장 이내로 답하세요.

[규정]
{return_policy}

[고객 질문]
산 지 3일 된 키보드인데 마음이 바뀌었어요. 단순 변심으로 반품되나요? 사진 첨부합니다."""},
            {"type": "image_url", "image_url": {"url": image_url}},
        ],
    }],
)
print(response.choices[0].message.content)
print(response.usage.prompt_tokens, "입력 토큰")
실행 결과
사진을 보니 키보드 키캡을 분리하셨습니다. 규정상 기계식 키보드의 키캡이나 스위치를 분리한 경우 단순 변심 반품이 제한됩니다. 따라서 이번 경우는 단순 변심 반품이 불가능합니다.
1153 입력 토큰
-
위 실행에서는 사진의 "키캡을 분리함"을 규정과 연결해 반품 불가라고 답함. 이미지도 토큰이라 입력 토큰이 크게 늘어남.
-
사진만으로 확정할 수는 없으므로 실제로는 "사진상으로는 …로 보입니다"라고 쓰고 최종 판단은 상담원에게(방어적 UX).
-
행동으로 바꾸기: 같은 사진을 보고 정해진 기술 목록 안에서 로봇 계획을 세우게 함(행동 공간 제한).
SKILLS = ["locate(물체)", "move_to(위치)", "grasp(물체)", "align(물체, 위치)", "press_down(물체)", "release()"]

response = client.chat.completions.create(
    model=model,
    messages=[{
        "role": "user",
        "content": [
            {"type": "text", "text": f"""사진 속 뽑힌 키캡을 로봇 팔이 원래 자리에 다시 끼우려 합니다.
다음 기술만 사용해 단계별 계획을 한 줄에 하나씩 쓰세요. 다른 설명은 쓰지 마세요.
기술: {', '.join(SKILLS)}"""},
            {"type": "image_url", "image_url": {"url": image_url}},
        ],
    }],
)
print(response.choices[0].message.content)
실행 결과
locate(뽑힌 키캡)
move_to(뽑힌 키캡 위치)
grasp(키캡)
locate(키캡 원래 자리)
move_to(키캡 원래 자리)
align(키캡, 키캡 원래 자리)
press_down(키캡)
release()
- 위 실행에서는 주어진 기술만으로 찾기 → 집기 → 정렬 → 누르기 → 놓기 순서를 냄. 정밀한 움직임은 각 기술(또는 VLA)의 몫이고, 끼워졌는지 확인하는 관찰 단계는 빠져 있음.
퀴즈
STT → LLM → TTS 파이프라인과 비교한 음성 대 음성 모델의 장점은?
퀴즈를 풀려면 대화형 기능을 불러와야 합니다.