
임베딩을 이용한 평가
임베딩이란
- 임베딩(embedding): 단어, 문장, 문서 등의 텍스트를 일정한 길이의 실수 벡터로 변환한 표현
- 비슷한 문맥이나 의미를 벡터 공간의 가까운 위치에 배치
- 토큰 임베딩: 문장 안의 각 토큰을 하나의 벡터로 표현
- 문맥적 언어 모형에서는 같은 단어도 주변 문맥에 따라 다른 벡터 사용
- 문장 임베딩: 문장이나 응답 전체를 하나의 벡터로 압축
- 검색, 군집화, 의미 유사도 평가에 활용
예시:
- 금융 문맥의 ‘은행’과 나무 열매를 뜻하는 ‘은행’: 표기는 같지만 서로 다른 문맥적 임베딩
- ‘돈을 인출한다’와 ‘돈을 찾는다’: 겹치는 단어가 적어도 가까운 문장 임베딩
임베딩의 모형 의존성
- 각 차원의 의미: 사람이 미리 정하지 않은 학습 결과
- 벡터 배치의 영향 요인: 임베딩 모형, 언어, 학습 데이터, 풀링 방식
- 점수 보고 항목: 임베딩 모형의 이름과 버전
코사인 유사도
코사인 유사도(cosine similarity): 두 임베딩 벡터 와 가 가리키는 방향의 유사도
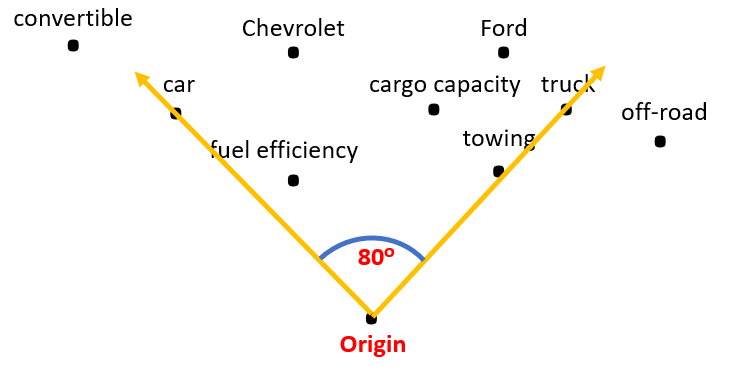
그림: StandingFuture, Wikimedia Commons, CC BY-SA 4.0 (변경 없음)

- 비교 대상: 벡터의 길이가 아닌 두 벡터 사이의 각도
- 같은 방향:
- 직교:
- 반대 방향:
- 주의: 모형마다 다른 점수 분포
- 서로 다른 임베딩 모형의 절대 점수는 직접 비교에 부적합
단어 겹침과 임베딩 유사도
- 단어 겹침 기반: 생성문과 참조문이 공유하는 단어 또는 n-gram을 측정
- 대표 예: BLEU, ROUGE
- 임베딩 기반: 텍스트 벡터 사이의 의미적 근접성을 측정
- 표현이 다른 바꿔 쓰기도 비교 가능
| 관점 | 단어 겹침 기반 | 임베딩 기반 |
|---|---|---|
| 비교 대상 | 동일한 단어·부분 문자열·n-gram | 토큰 또는 문장 벡터 |
| 잘 포착하는 것 | 참조문과 같은 표현, 핵심어의 직접 재사용 | 바꿔 쓰기, 유의어, 문맥상 가까운 표현 |
| 장점 | 빠른 계산과 투명한 과정 | 표면형이 다른 정답의 의미 유사성 반영 |
| 한계 | 올바른 바꿔 쓰기의 과소평가 가능성 | 숫자, 부정, 주체, 사실관계가 달라도 높은 점수 가능성 |
BERTScore
BERTScore: 생성문과 참조문의 문맥적 토큰 임베딩을 비교하는 지표
- 토큰 대응: 상대 문장의 토큰 중 코사인 유사도가 가장 높은 토큰 선택
- 정밀도 : 생성문 토큰을 기준으로 계산한 평균 유사도
- 재현도 : 참조문 토큰을 기준으로 계산한 평균 유사도
- : 정밀도와 재현도의 조화 평균
- 선택 설정: IDF 가중치, 기준 점수 재조정
- 장점: 부분적인 내용 대응과 누락 반영
- 한계:
- 모든 토큰 쌍을 비교하는 계산 비용
- 독립적인 토큰 대응으로 놓치기 쉬운 문장 전체의 논리, 숫자 변화, 부정 표현, 사실 정확성
SemScore
SemScore: 생성 응답과 정답 응답의 문장 임베딩을 비교하는 지표
- 문항 점수: 두 문장 임베딩의 코사인 유사도
- 모형 점수: 문항별 유사도의 평균
| 구분 | BERTScore | SemScore |
|---|---|---|
| 임베딩 단위 | 각 토큰의 문맥적 임베딩 | 응답 전체의 문장 임베딩 |
| 비교 방식 | 토큰마다 가장 유사한 상대 토큰을 대응 | 생성 응답 벡터와 정답 응답 벡터를 한 번 비교 |
| 출력 | 정밀도·재현도· | 코사인 유사도와 문항 평균 |
| 해석에 유리한 상황 | 포함된 내용과 누락된 내용을 부분적으로 살펴볼 때 | 짧은 응답의 전체 의미를 간단히 비교할 때 |
| 주요 약점 | 계산 비용과 독립적인 토큰 대응 | 한 벡터에서 희석될 수 있는 긴 응답의 일부 오류와 불필요한 내용 |
문장 임베딩 유사도 실습
- 임베딩 모형: 한국어 문장 임베딩 모형
- 비교 대상: 생성문과 참조문의 문장 벡터
- 계산 방식: SemScore 방식의 코사인 유사도
!pip install -q sentence-transformers scikit-learn
from sentence_transformers import SentenceTransformer
from sklearn.metrics.pairwise import cosine_similarity
model = SentenceTransformer("jhgan/ko-sroberta-multitask")
candidates = ["은행에서 돈을 찾는다", "은행 계좌에 돈을 입금한다",
              "가을에는 은행 열매가 익는다"]
reference_embedding = model.encode(["은행 계좌에서 돈을 인출한다"])
candidate_embeddings = model.encode(candidates)
similarity_matrix = cosine_similarity(candidate_embeddings, reference_embedding)
scores = similarity_matrix.ravel()  # 후보문별 점수를 한 배열로 정리
scores  # 후보문 순서의 코사인 유사도
실행 결과
array([0.84678376, 0.86919755, 0.33598104], dtype=float32)
- 첫 번째 후보문: 가까운 의미를 반영한 높은 점수
- 두 번째 후보문: 반대 행위인데도 가장 높은 점수
- 세 번째 후보문: 식물 문맥을 반영한 낮은 점수
- 핵심: 공통된 주제와 단어가 핵심 행위의 차이보다 강하게 반영될 가능성