
LLM 벤치마크
벤치마크 Benchmarks
언어 모형의 성능을 객관적이고 일관되며 재현 가능하게 측정하기 위해 만든 표준화된 문제나 과업의 집합
- 객관적 비교: 여러 모형에 같은 시험을 적용해 상대적 강점 비교
- 연구 방향 제시: 모형이 공통으로 어려워하는 문제 발견
- 발전 속도 추적: 시간에 따른 성능 변화 측정
- 약점 분석: 수학, 코딩, 멀티모달 이해 등 능력별 취약점 확인
벤치마크의 한계
- 데이터 오염: 테스트 문제가 훈련 데이터에 포함되어 점수가 부풀 가능성
- 리더보드 과최적화: 일반 능력보다 특정 시험의 점수만 높이도록 개발 방향이 치우칠 가능성
- 제한된 평가 범위: 높은 점수가 실제 환경의 유용성이나 안전성을 완전히 보장하지 않음
- 포화: 상위 모형의 점수가 비슷해져 성능 차이를 구분하기 어려움
- 평가자 의존: LLM이 채점하는 벤치마크는 평가 모형의 오류와 편향을 물려받을 수 있음
대표 벤치마크
- 학술 지식과 추론
- GPQA Diamond: 검색 없이 풀기 어려운 대학원 수준의 과학 질문
- Humanity's Last Exam: 여러 학문 분야의 전문가가 만든 고난도 문제
- FrontierMath: 미공개 문제를 포함한 고급 수학 추론
- 추상 추론
- ARC-AGI-3: 처음 보는 상호작용 환경에서 규칙을 파악하고 적응하는 능력
- 멀티모달 이해
- MMMU-Pro: 이미지가 실제로 필요한 다학문 문제의 이해와 추론
- CharXiv-Reasoning: 과학 논문의 복잡한 도표 이해와 추론
- 소프트웨어 개발과 컴퓨터 사용
- SWE-bench Verified·Pro: 실제 저장소의 이슈를 해결하고 패치를 작성하는 능력
- Terminal-Bench: 격리된 터미널에서 개발·시스템 관리 과업을 끝까지 수행하는 능력
- OSWorld: 운영체제와 응용 프로그램을 조작해 실제 컴퓨터 과업을 수행하는 능력
- 도구 사용과 에이전트
- BFCL: 함수와 도구를 정확히 선택하고 호출하는 능력
- τ3-bench: 사용자와 대화하며 정책·검색·업무 도구를 함께 다루는 능력
- BrowseComp: 웹에서 찾기 어려운 정보를 여러 단계로 탐색하는 능력
- 전문 업무
- HealthBench: 실제 의료 대화에서 응답의 유용성과 안전성
- GDPval: 여러 직업의 문서·슬라이드·스프레드시트 등 업무 산출물
- Agents' Last Exam: 다양한 전문 분야의 장기 실행 과업을 완료하는 능력
같은 이름의 벤치마크도 데이터셋 버전, 공개·비공개 문제, 도구 허용 여부, 추론 강도, 에이전트 실행 틀, 시도 횟수에 따라 점수가 다를 수 있음
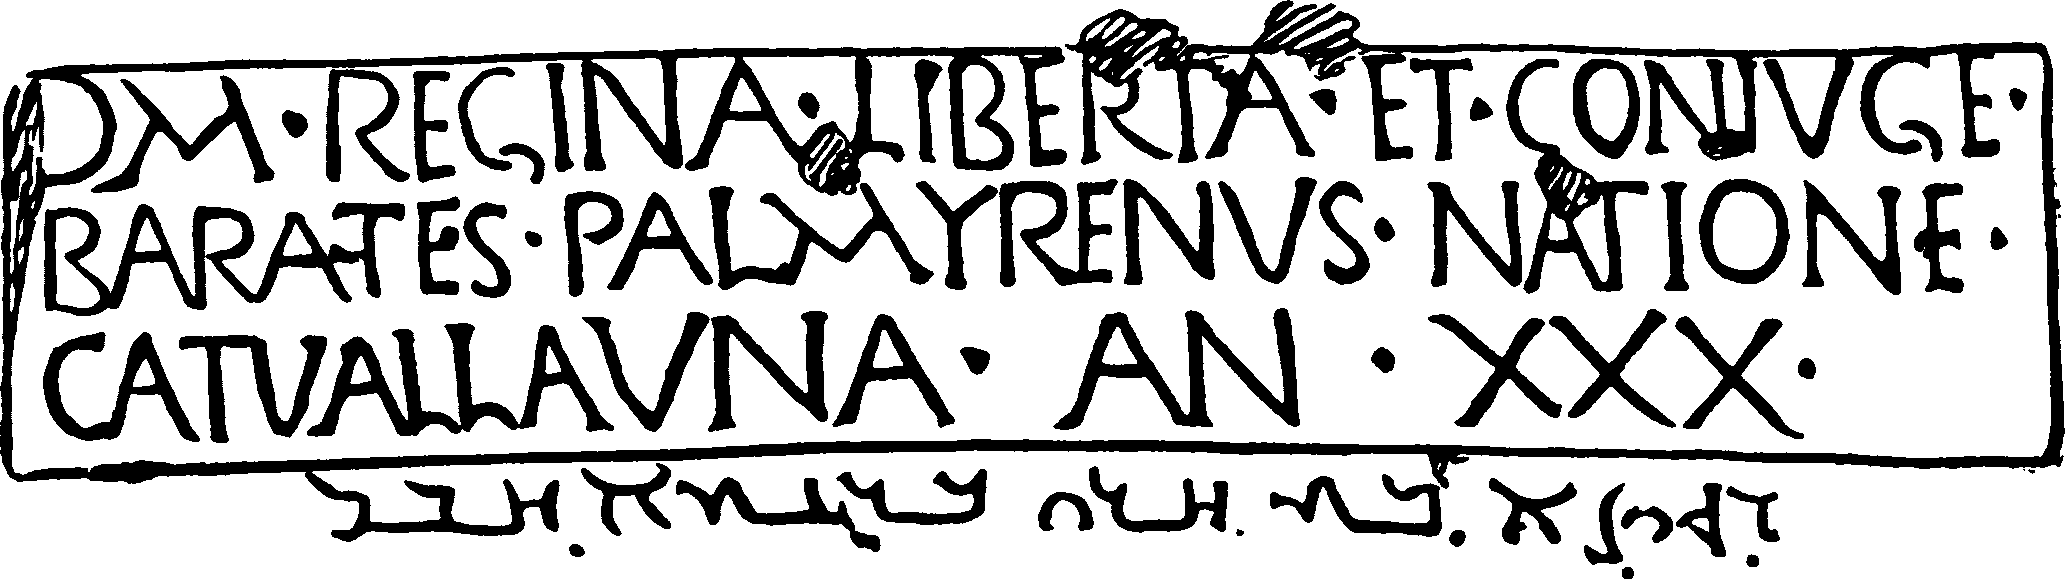
예시: Humanity's Last Exam
- Humanity's Last Exam은 여러 분야의 전문가가 만든 고난도 문제로 구성
- 다음 이미지는 묘비에서 발견된 팔미라 문자 비문의 번역을 요구
벤치마크 성능의 변화
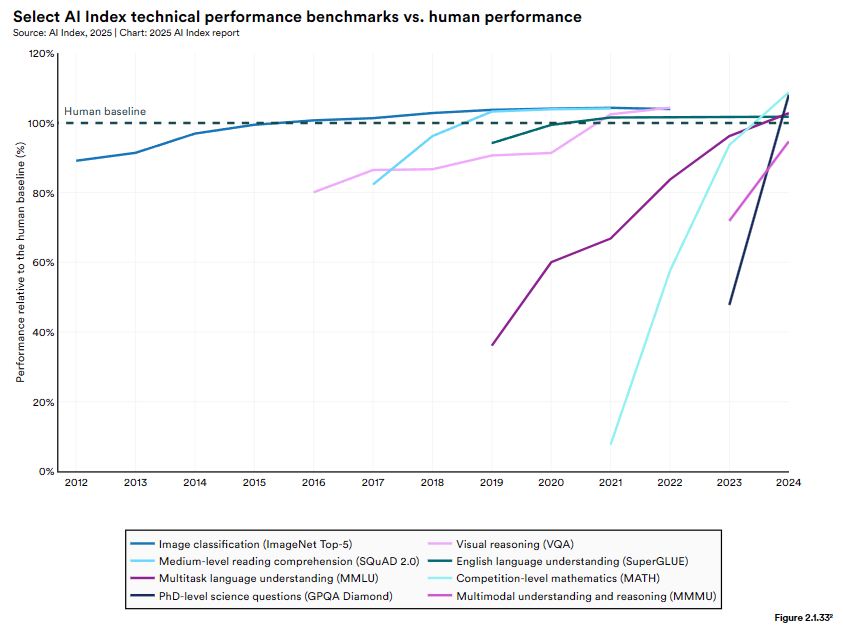
- 여러 전통 벤치마크에서 AI 성능이 인간 기준에 가까워지거나 넘어섬
- 기존 시험의 구분력이 빠르게 약해질 수 있음을 보여 줌
- 포화된 벤치마크는 더 어렵고 현실적인 과업으로 교체해야 함
평가 사이트
Arena.ai
- 두 모형의 이름을 가린 채 응답을 제시하고 사용자의 선택을 모아 순위를 계산
Artificial Analysis
- 여러 지능 평가 결과와 함께 토큰 가격, 과업당 비용, 출력 속도, 첫 토큰 지연 시간, 문맥 길이를 제공
Epoch AI
- 실행한 평가와 외부에서 공개한 결과를 함께 모아 모형별·벤치마크별 성능 변화를 보여 줌
- 개별 실행의 설정과 기록을 확인하며 장기 추세를 살피기 좋음
LiveBench
- 최근 자료를 바탕으로 문제를 주기적으로 갱신하고 객관적인 정답으로 자동 채점
- 추론, 코딩, 에이전트 코딩, 수학, 데이터 분석, 언어, 지시 이행을 나누어 볼 수 있어 오염과 LLM 심사 편향을 줄이려는 평가에 적합
Hugging Face Leaderboards
- 공개 가중치 언어 모형뿐 아니라 임베딩, 비전·언어, 음성 인식 등 다양한 분야의 커뮤니티 리더보드를 찾을 수 있음
- 리더보드마다 운영 주체와 채점 방식이 다르므로 데이터셋, 실행 코드, 갱신일을 함께 확인해야 한다.
Scale Labs
- 에이전트, 전문 지식, 안전성 등 분야별 평가를 제공
OpenRouter Benchmarks
- 모형뿐 아니라 API 공급자, 검색 도구, 도구 사용량 등 실제 실행 설정을 함께 기록
- 같은 과업에서 품질, 비용, 속도의 균형을 비교할 때 유용
평가 목적에 맞는 조합
- 연구용 능력 추적: LiveBench, Epoch AI와 과업별 공식 리더보드
- 공개 모형 탐색: Hugging Face의 분야별 리더보드와 원본 평가 코드
- 제품용 모형 선택: Artificial Analysis·OpenRouter의 품질·비용·속도와 자체 업무 데이터 평가
- 사용자 만족도 비교: Arena.ai 방식의 블라인드 쌍대 비교
- 고위험 배포: 자동 지표, LLM 평가, 전문가 평가, 안전성 시험을 함께 적용
AI 벤치마크 현황: 2026년 10월
- 조사 기준일: 2026년 10월 28일
- 큰 흐름: 지식·수학 시험의 정답률에서 도구를 사용해 실제 업무를 끝내는 능력과 비용으로 평가 범위 확대
- 종합 순위와 분야별 순위의 차이: 코딩, 과학, 문서 작업, 사실성, 사용자 선호에서 서로 다른 모형이 선두
- 최신 개편: Artificial Analysis는 10월 27일 Intelligence Index v5 출시
Artificial Analysis의 평가 구조
| 평가 대상 | 확인할 질문 | 대표 지표 |
|---|---|---|
| 모형의 능력 | 얼마나 어려운 문제와 업무를 해결하는가? | Intelligence Index와 개별 벤치마크 |
| 사용 효율 | 결과를 얻는 데 비용과 시간이 얼마나 드는가? | 과업당 비용·시간, 출력 속도, 첫 토큰 지연 |
| 분야·실행 환경 | 특정 업무와 도구 구성에서도 잘하는가? | Coding Agent Index, 분야별 Capability Index, Search Index |
- 외부 벤치마크의 독립 실행과 자체 평가 개발을 병행
- 외부 평가: HLE-Diamond, Terminal-Bench, CritPt 등
- 자체 평가: AA-Briefcase, AA-Omniscience 등
Intelligence Index v5의 구성과 결과
- 지식 업무, 코딩, 과학, 일반 능력에 각각 25% 배정
- 총 9개 평가로 구성. 비공개 시험 또는 비공개 정답을 사용하는 평가가 가중치의 60%
max,xhigh,high: 모형별 추론 강도 설정
| 평가 / 가중치 | 측정하는 능력 | 주요 결과 |
|---|---|---|
| AA-Briefcase v1.1 / 15% | 여러 자료를 읽고 문서·슬라이드·스프레드시트 등 업무 산출물 작성. 요구사항 충족, 분석 품질, 표현 품질을 결합 | Claude Sonnet 5.5 max 1812 Elo, Opus 5.5 max 1800 Elo |
| AutomationBench-AA / 5% | 여러 업무용 앱의 API를 사용해 업무 절차 수행. 목표 달성과 가드레일 위반을 평가 | Gemini 4 Argon 약 78% |
| GDP.pdf / 5% | 긴 전문 PDF를 읽고 세부 요구사항을 모두 만족하는 답변 작성 | Muse Wonder Full max 32.6%, GPT-6 Astra xhigh 32.2%, GPT-6.1 Sol high 32.0%. 모든 조건을 통과한 비율 |
| FrontierCode 2.0 / 15% | 실제 오픈소스 저장소를 수정하고 관리자가 병합할 수준인지 테스트와 평가 기준으로 채점 | Claude Opus 5.5 max 46.4%, GPT-6 Astra max 42.4%. 평균 평가 점수 |
| Terminal-Bench 4.0 / 10% | 터미널에서 개발·운영·데이터 처리 등 복잡한 과업 완료 | Kimi K3.1 Pro 67.2%, Claude Sonnet 5.5 max 63.6%, Opus 5.5 max 59.6% |
| Terminal-Bench-Science 0.1 / 15% | 생명·물리·지구·수학·공학 분야의 연구 작업을 터미널에서 수행 | GPT-6 Astra max 63.3%, Claude Opus 5.5 xhigh 61.9% |
| CritPt v2 Hard Subset / 10% | 연구 수준 물리 문제를 코드 실행 도구와 함께 해결 | GPT-6 Astra high 약 72%, GPT-6.1 Sol max 약 69%, Claude Opus 5.5 max 약 61% |
| AA-Omniscience v1.1 / 15% | 사실 지식과 모르는 것을 인정하는 능력. 정답률에 10%, 비환각률에 5% 배정 | 결합 지수는 Claude Opus 5.5 max 48. 정답률 선두는 Fable 5.1 max 68%, 환각률 최저는 Gemini 4 Argon high 4% |
| HLE-Diamond / 10% | 고난도 학술 지식·추론. 지식 500문항과 추론 500문항을 도구 없이 평가 | Claude Opus 5.5 max 67.9%, GPT-6 Astra max 63.8% |
점수 단위의 차이
- Elo: 제출물이나 응답의 상대적 우위를 나타내는 점수
- 전체 조건 통과율(All-pass): 과업에 주어진 모든 채점 조건을 통과한 시도의 비율
pass@1: 한 번의 독립 실행에서 성공할 비율- Terminal-Bench는 과업마다 세 번 독립 실행한 결과의 평균을 보고
- 세 번 중 한 번이라도 성공하면 통과시키는
pass@3와 구분
- 부분집합: 같은 평가도 전체 문제와 어려운 문제만 모은 결과를 구분
- CritPt v2 전체 70문항에서 Astra high는 83.7%
- 종합 지수에는 어려운 40문항의 성적을 반영하므로 위 표의 약 72%와 차이
종합 성적과 과업당 비용
v5 발표 자료의 주요 모형 성적과 과업당 평균 비용.
| 모형·설정 | Intelligence Index v5 | 지수 과업당 평균 비용 |
|---|---|---|
| Claude Opus 5.5 max | 58 | 10.04달러 |
| GPT-6 Astra max | 57 | 6.24달러 |
| GPT-6.1 Sol max | 55 | 1.27달러 |
| GPT-6.1 Terra max | 51 | 0.96달러 |
| Gemini 4 Argon high | 50 | — |
| Kimi K3.1 Pro | 46 | — |
| DeepSeek V4.1 Flash 1017 max | 32 | — |
| GLM-5.3 max | 32 | — |
- 비용: 벤치마크별 토큰 사용량·가격을 가중 평균한 값
- Opus 5.5와 Sol: 지수는 3점 차이지만 위 과업 구성의 평균 비용은 약 8배 차이
- Kimi K3.1 Pro: 조사 시점에 가중치 공개 예정
- 분야별 선두: 터미널 과업은 Kimi, 전문 PDF는 Muse
다른 주요 리더보드와의 비교
| 평가 | 측정 대상 | 확인된 결과와 해석 |
|---|---|---|
| Arena | 이름을 가린 두 응답 중 사용자가 선호하는 답변 | 10월 22일 표에서 Gemini 4 Argon high 1517±7, Opus 5.5 high 1509±7, Muse Wonder max 1509±8 |
| SWE-bench Verified | 실제 GitHub 이슈의 코드 수정과 테스트 통과 | 사람이 검증한 500개 과업. Bash Only는 동일 mini-SWE-agent로 모형을 비교 |
| SWE-Bench Pro V2 | 장기 실행 소프트웨어 수정 과업 | Full 표에서 Opus 5 + Claude Code xhigh 99.40±0.40, Gemini 4 Argon + mini-swe-agent high 99.22±0.45 |
| ARC-AGI-3 | 처음 보는 상호작용 환경의 규칙 발견과 적응 | Astra의 최고 관측 성적은 Standard 환경 62.7%, Provider Adapter 환경 99.9%. 상태 보존 등 실행 환경이 성적에 큰 영향 |
- SWE-Bench Pro V2: 오류 과업 수정, 네트워크 접근 제한, 깨끗한 환경에서의 재채점 등을 도입
- ARC-AGI-3 실행 설정: Standard 최고는 max, Provider Adapter 최고는 high
기존 시험의 현재 역할
| 평가 | 측정 대상 | AA에서 확인되는 성적과 상태 |
|---|---|---|
| GPQA Diamond | 대학원 수준 물리·화학·생물 객관식 추론 | Astra xhigh 96.3%. 포화 판단으로 종합 지수에서 제외 |
| MMLU-Pro | 14개 분야의 폭넓은 지식·추론, 10지선다 | AA 보존 성적: Gemini 3 Pro Preview high 89.8% |
| LiveCodeBench | 새 알고리즘 대회 문제의 코드 생성·수정 | AA 보존 성적: Gemini 3 Pro Preview high 91.7% |
| IFBench | 형식·문구·개수 등 낯선 출력 제약 준수 | Grok 4.3 medium 83.3%. 종합 지수 밖에서 별도 보고 |
| MMMU-Pro | 그림·도표와 텍스트를 함께 이해하는 학술 추론 | Opus 5.5 max 88%, Astra max 87% |
| Global-MMLU-Lite | 여러 언어에서의 지식·추론 | AA 보존 성적: Gemini 3.1 Pro Preview 93.2%. 한국어별 결과 제공 |
- AIME 2025: 수학 경시 문제를 통한 추론 평가. AA의 현재 활성 보고에서는 제외
- SciCode, AA-LCR, GDPval-AA: v5 종합 지수에서 제외
전문 분야와 생성 품질의 평가
- 의료 대화: HealthBench와 HealthBench Professional
- 일반 사용자·의료 종사자 대화와 임상의 대화를 구분하고 의사가 작성한 평가 기준으로 채점
- 10월 19일 분석에서 Professional의 길이 보정 점수는 Astra max 66.0%, Sol max 65.1%
- Opus 5.5는 원점수 **71.4%**로 가장 높지만 긴 답변 보정 후 59.9%
- 답변 길이를 채점에 반영하는 방식에 따라 순위가 달라지는 사례
- 코드 기반 영상 제작: Code2Video-AA
- 114개 제품·브랜드 영상 기획을 HTML로 구현하고 결과물을 비교
- 10월 26일 분석에서 Opus 5.5 max 1536 Elo, Sonnet 5.5 max 1443, Astra max 1427
- Sonnet과 Astra는 비슷한 성적
- 이미지 생성: AA-Image-T2I v2.1
- 검증된 평가자가 이름을 가린 이미지 쌍을 비교
- GPT Image 2.5 Sunburst max 1222 Elo, Flare max 1207, GPT Image 2 high 1186
- 코딩 제품: Coding Agent Index
- 모형과 에이전트 실행 설정의 조합을 비교
- v2.0은 FrontierCode v1.1, Terminal-Bench 4.0, SWE-Atlas-QnA-AA를 결합
- 검색 도구: Search Index
- 같은 답변 모형에 검색 API를 붙여 검색 품질의 기여와 비용·지연을 비교
- 사이버 방어: Cyber Index
- 실제 저장소에서 취약점을 발견하고 재현·검증한 뒤 기존 기능을 깨뜨리지 않고 수정하는 능력
성능 변화와 모형 선택
- Intelligence Index: 현재 모형의 능력을 비교하며 과업과 가중치를 주기적으로 갱신
- Progress Index: 문항반응이론으로 모형 능력과 과업 난도를 함께 추정해 장기 발전을 추적
- 비교 조건: 지수 버전, 추론 강도, 도구, 에이전트 실행 틀, 시간·비용 제한
- 실제 업무 평가: 정답률, 환각률, 답변 유보, 과업당 비용과 완료 시간을 함께 확인
실제 선택에서는 종합 지수로 후보를 좁힌 뒤 업무별 평가와 비용을 비교하고 자체 자료로 검증하는 순서가 적절.
| 사용 목적 | 우선 확인할 평가 |
|---|---|
| 연구 보조 | HLE-Diamond, CritPt, Terminal-Bench-Science |
| 문서·분석 업무 | AA-Briefcase, GDP.pdf, 분야별 평가 |
| 소프트웨어 개발 | FrontierCode, Terminal-Bench, 실제 사용하는 코딩 에이전트의 결과 |
| 사용자 대화 | Arena의 선호도, IFBench의 제약 준수, 사실성 평가 |
| 한국어 교육·업무 | 한국어별 평가와 실제 수업·업무 자료의 자체 평가 |
참고 자료
- Artificial Analysis Intelligence Index v5 발표: 개편 내용, 종합 성적, 비용과 분야별 선두
- Artificial Analysis 평가 방법론: 개별 벤치마크의 구성·가중치·채점 방식
- Artificial Analysis 평가 목록: 전문 분야·생성 품질을 포함한 개별 평가와 결과
- Arena 텍스트 순위: 사용자 선호도 비교
- Scale Labs SWE-Bench Pro V2: 소프트웨어 개발 평가와 실행 조건
- ARC Prize의 GPT-6 Astra 평가: 추론 강도·실행 환경별 성적
- Stanford AI Index 2025: 벤치마크 성능 변화 그림의 출처
퀴즈
LLM 벤치마크의 주된 목적은?
퀴즈를 풀려면 대화형 기능을 불러와야 합니다.