
트랜스포머
순환신경망의 한계
- 순환신경망(RNN)은 이전 단계의 은닉 상태를 다음 단계로 전달하며 문장을 순서대로 처리
- 멀리 떨어진 두 토큰의 정보를 연결하려면 여러 처리 단계를 거쳐야 하므로 장기 의존성 학습이 어려움
- 순차 계산 때문에 긴 문장을 학습할 때 병렬 처리에도 제약
- 트랜스포머(Transformer)는 주의 메커니즘으로 각 위치가 다른 위치의 정보를 직접 참조
- 멀리 떨어진 토큰 사이의 관계도 짧은 경로로 연결
- 학습할 때 여러 토큰 위치를 병렬 처리
인코더와 디코더
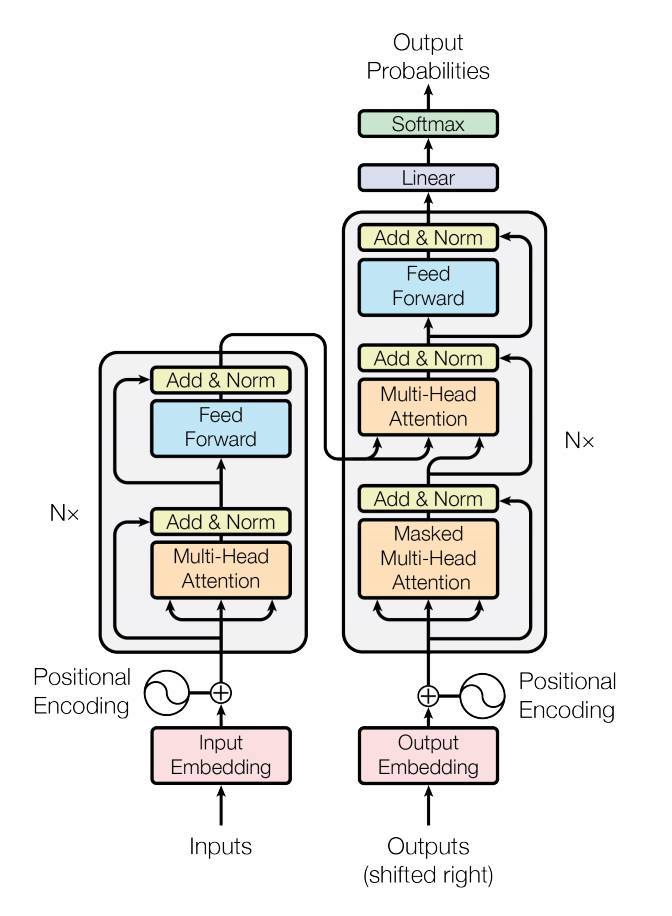
- 인코더(encoder): 입력 토큰 사이의 관계를 읽어 문맥이 반영된 표현 생성 → BERT
- 디코더(decoder): 앞에서 생성한 토큰과 인코더의 표현을 이용해 다음 토큰 생성
- GPT: 인코더가 없는 디코더형 구조. 인코더의 표현을 사용하지 않고 같은 문장 안에서 앞에 놓인 토큰만으로 다음 토큰 생성
토큰 임베딩
- 토큰: 언어 모형이 텍스트를 처리하는 단위
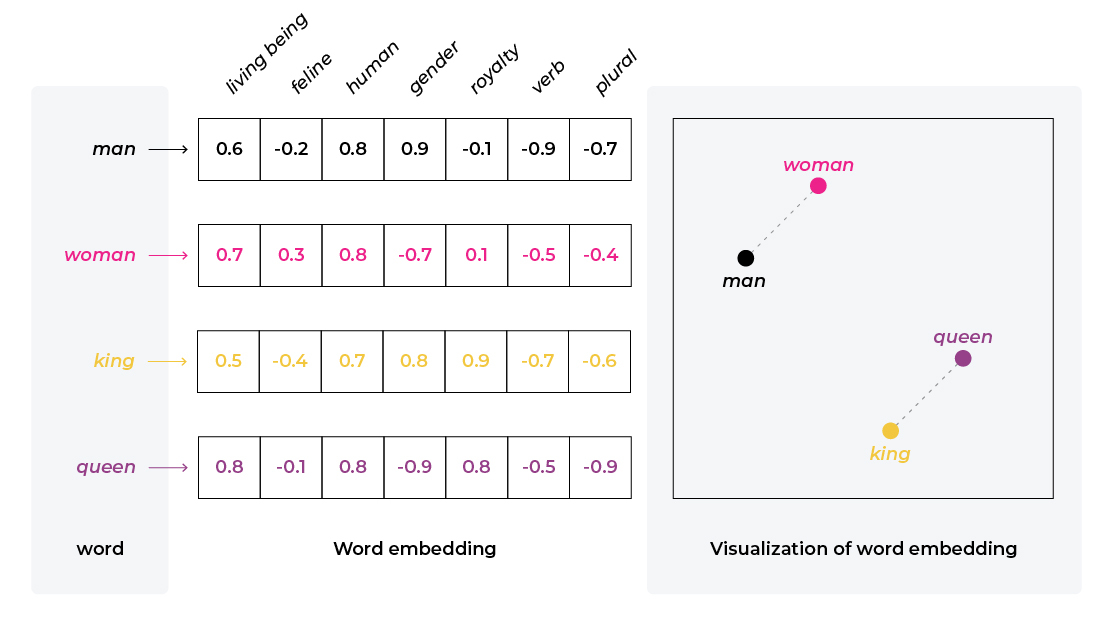
- 임베딩(embedding): 토큰 ID를 학습 가능한 벡터로 변환한 것
- 비슷한 맥락에서 쓰이는 토큰은 임베딩 공간에서 가까운 표현을 갖는 경향
- 같은 토큰도 주의 계층을 통과하면서 주변 문맥에 따라 서로 다른 표현으로 갱신
위치 인코딩
- 자기 주의만으로는 첫 번째 토큰과 세 번째 토큰의 위치를 구분할 기준이 없음.
- 토큰 임베딩에 위치 인코딩(positional encoding)을 더해 순서 정보를 제공.
- 위치 인코딩은 사인·코사인 함수로 만들거나 학습 가능한 벡터로 둘 수 있음.
주의 메커니즘
번역 I am a student → 나는 학생입니다를 생각하면, 나는을 만들 때는 I의 정보가 중요하고 학생을 만들 때는 student의 정보가 중요. 주의 메커니즘은 현재 처리에 필요한 정보를 입력 전체에서 선택적으로 모음.
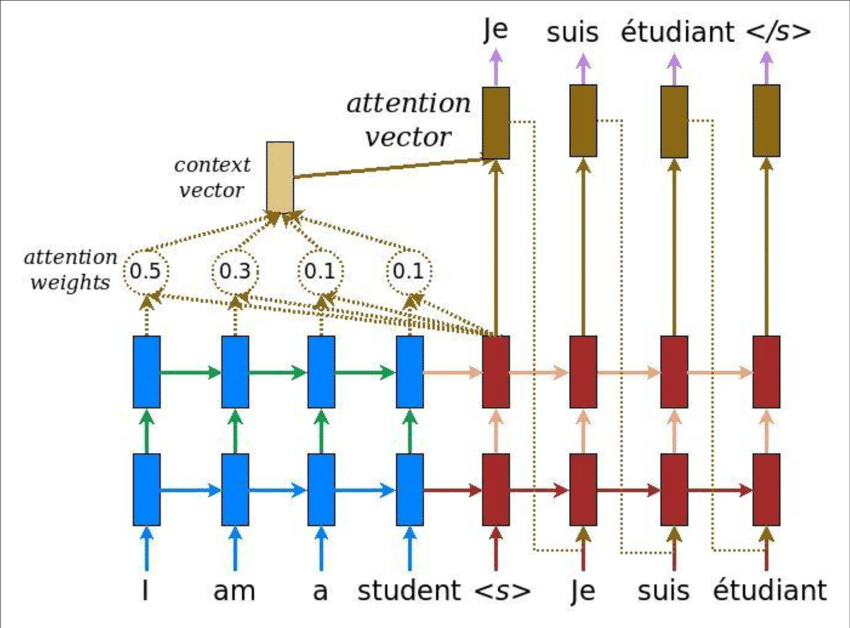
각 입력 표현을 서로 다른 선형 변환에 통과시켜 세 벡터를 만듦.
- 질의(Query, ): 현재 위치가 찾는 정보
- 키(Key, ): 각 위치가 어떤 정보를 가졌는지 비교하기 위한 표지
- 값(Value, ): 주의 가중치에 따라 실제로 가져올 정보
여기서 "비슷하다"는 단순히 두 토큰의 사전적 의미가 같다는 뜻이 아님. 학습된 Query와 Key가 현재 문맥과 과업에서 얼마나 관련 있는지를 나타냄.
KV 캐시
GPT 같은 인과적 언어 모형은 이전 토큰을 바탕으로 다음 토큰을 하나씩 생성. 새 토큰을 생성할 때 과거 토큰의 Key와 Value는 이미 계산이 끝난 값이며 다시 바뀌지 않음. 매 단계마다 전체 문맥의 Key와 Value를 처음부터 계산하면 같은 연산을 반복하게 됨.
키-값 캐시(KV cache)는 각 트랜스포머 계층에서 과거 토큰의 Key와 Value를 저장해 다음 생성 단계에서 재사용하는 추론용 메모리.
- 프리필(prefill): 입력 프롬프트의 모든 토큰을 병렬 처리해 각 계층의 Key와 Value를 캐시에 저장
- 디코딩(decode): 새 토큰 하나의 Query, Key, Value만 계산
- 새 Key와 Value를 기존 캐시 뒤에 추가
- 새 Query를 캐시에 있는 모든 Key와 비교하고, 주의 가중치로 캐시의 Value를 결합
현재 출력에는 현재 토큰의 Query만 필요하므로 과거 Query는 보통 저장하지 않음. 과거 Query는 해당 위치의 출력을 만들 때 이미 사용되었기 때문.
- 장점: 과거 토큰의 Key와 Value 투영을 반복하지 않아 토큰 생성 속도 향상
- 비용: 문맥 길이, 계층 수, 배치 크기가 커질수록 캐시가 차지하는 GPU 메모리 증가
- 한계: 캐시를 사용해도 새 Query는 지금까지의 모든 Key와 비교해야 하므로 긴 문맥의 주의 계산 자체가 사라지는 것은 아님