
귀납 편향
귀납 편향
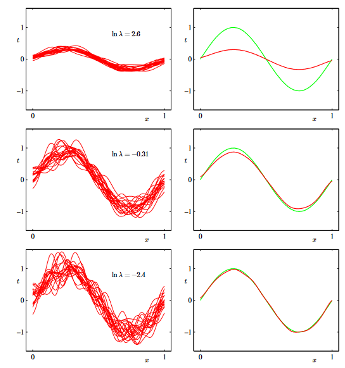
귀납 편향(inductive bias)은 관찰한 훈련 데이터에서 관찰하지 않은 데이터로 일반화하기 위해 모형이 사용하는 구조적 가정. 데이터만으로는 가능한 규칙이 여러 개이므로 어떤 패턴을 먼저 찾을지 정하는 기준이 필요.
- 강한 귀납 편향: 모형이 선택할 수 있는 패턴의 범위를 크게 제한
- 가정이 실제 데이터 구조와 잘 맞으면 적은 데이터로도 안정적인 학습이 가능
- 가정과 다른 패턴은 놓치기 쉬움
- 데이터셋이 달라져도 결과가 적게 변함(작은 분산)
- 약한 귀납 편향: 더 다양한 패턴을 표현
- 충분한 데이터와 계산이 있으면 복잡한 관계를 학습할 수 있음
- 작은 데이터에서는 학습 결과가 표본에 따라 크게 달라지거나 불필요한 패턴까지 학습할 가능성 증가(큰 분산)
- 편향-분산 교환(bias-variance trade-off): 편향이 강하면 분산이 작아지고, 편향이 약하면 분산이 커짐
구조별 관계 가정
- 선형 모형: 입력과 출력의 관계가 직선에 가깝다는 가정
- 합성곱 신경망(CNN): 가까운 위치가 관련되고 같은 특징이 여러 위치에서 반복된다는 가정
- 국소성, 위치 이동에 대한 등변성
- 순환신경망(RNN): 입력을 순서대로 처리하며 이전 상태가 다음 상태에 영향을 준다는 가정
- 순차성, 가까운 단계의 강한 연결
- 트랜스포머: 내용에 따라 모든 위치 사이의 관계를 학습한다는 가정
트랜스포머가 잘 작동하는 이유
- 먼 관계를 직접 연결: CNN은 여러 층을 거쳐 수용 영역을 넓히고, RNN은 여러 시간 단계를 거쳐 정보를 전달. 자기 주의는 문장 안의 두 위치를 한 번의 주의 계산으로 연결하므로 주어와 서술어처럼 멀리 떨어진 관계를 다루기 쉬움.
- 관계의 종류를 데이터에서 학습: 주의 가중치는 고정된 거리 규칙이 아니라 Query와 Key의 내용으로 결정. 멀리 있는 핵심 토큰에 큰 가중치를 주거나 가까운 토큰을 덜 반영하는 관계를 학습 가능. 멀티헤드 주의는 여러 관계를 서로 다른 표현 공간에서 동시에 학습.
- 대규모 병렬 학습: RNN처럼 토큰을 하나씩 순차 처리하지 않으므로 학습 단계에서 여러 위치의 주의를 행렬 연산으로 함께 계산. GPU에서 대규모 데이터와 큰 모형을 효율적으로 학습하기 좋은 구조.
항상 가장 좋은 구조는 아님
- 표준 자기 주의는 토큰 수가 늘면 위치 쌍의 수가 제곱으로 증가
- 데이터가 작거나 국소성처럼 명확한 구조가 있는 문제에서는 강한 귀납 편향을 가진 모형이 더 효율적일 수 있음
- 위치 인코딩, 마스크, 학습 데이터가 부적절하면 필요한 순서와 관계를 충분히 학습하지 못할 수 있음