
결정론적 디코딩
완전 탐색, 탐욕 탐색, 빔 탐색, 다양한 빔 탐색, 대조 탐색을 비교한다.
결정론적 디코딩
- 디코딩(decoding): 언어 모형이 계산한 점수로 다음 토큰을 선택해 문장을 만드는 과정
- 결정론적 디코딩(deterministic decoding): 확률에 따른 무작위 추출 없이 정해진 규칙으로 토큰을 선택
- 입력, 모형, 설정, 실행 환경이 같으면 같은 결과를 재현
- 난수 시드가 필요하지 않음
- 높은 확률: 자연스러운 문장의 중요한 기준이지만 사람이 보기에 좋은 답변을 항상 보장하지는 않음
결정론적이라고 항상 완전히 같지는 않음
- GPU의 부동소수점 계산, 라이브러리 버전, 병렬 연산 방식이 달라지면 드물게 결과가 달라질 수 있음
- 수업에서는 같은 Colab 런타임과 라이브러리 버전을 사용해 비교
문장 전체의 확률
- 자기회귀 언어 모형: 앞에서 선택한 토큰을 조건으로 다음 토큰의 확률을 계산
- 문장 전체의 확률: 각 단계에서 선택한 토큰의 조건부 확률을 모두 곱한 값
- : 입력 문장, : 번째로 생성한 토큰, : 그 앞에서 생성한 토큰들
- 실제 계산: 작은 확률을 계속 곱하면 값이 0에 가까워져 정확히 다루기 어려우므로 로그 확률의 합을 사용
- 핵심 문제: 문장 전체의 확률을 최대화하려면 어떤 토큰들을 골라야 하나?
완전 탐색
- 완전 탐색(exhaustive search): 가능한 문장을 모두 만든 뒤 전체 확률이 가장 높은 문장을 선택
- 장점: 정해진 길이 안에서 전체 확률이 가장 높은 문장을 확실히 찾음
- 한계: 어휘 수가 , 생성 길이가 이면 후보 수가 으로 증가
- 실제 언어 모형의 어휘는 수만 개 이상이므로 긴 문장 생성에 적용하기 어려움
- 가상 언어 모형: 두 단계만 생성하는 작은 어휘와 확률을 사용
시작
├─ 나는 (0.6)
│  ├─ 걷는다 (× 0.55 = 0.33)
│  └─ 쉰다   (× 0.45 = 0.27)
└─ 오늘 (0.4)
   ├─ 걷는다 (× 0.9 = 0.36)
   └─ 쉰다   (× 0.1 = 0.04)
- 완전 탐색의 선택: 전체 확률이 가장 높은
오늘 걷는다
탐욕 탐색
- 탐욕 탐색(greedy search): 매 단계에서 현재 확률이 가장 높은 토큰 하나를 즉시 선택
- 장점: 단계마다 후보 하나만 남기므로 빠르고 메모리 사용량이 적음
- 한계: 한 번 버린 후보를 다시 검토하지 않아 문장 전체의 최적해를 놓칠 수 있음
시작
├─ 나는 (0.6)
│  ├─ 걷는다 (× 0.55 = 0.33)
│  └─ 쉰다   (× 0.45 = 0.27)
└─ 오늘 (0.4)
- 예시:
- 첫 단계:
나는의 확률 0.6가오늘의 0.4보다 높아나는을 선택 - 최종 결과:
나는 걷는다의 전체 확률은 0.33 - 완전 탐색과의 차이:
오늘 걷는다의 0.36보다 낮지만 첫 단계에서오늘을 이미 제외
- 첫 단계:
실습 준비
(앞 장과 같음)
!pip install -q "transformers==4.55.4" accelerate jinja2
import torch
from transformers import AutoModelForCausalLM, AutoTokenizer

model_name = "LGAI-EXAONE/EXAONE-4.0-1.2B"  # 허브 저장소 식별자
tokenizer = AutoTokenizer.from_pretrained(model_name)  # 토크나이저 로드
model = AutoModelForCausalLM.from_pretrained(
    model_name,
    torch_dtype=torch.float16,  # T4 GPU용 16비트 자료형
    device_map="auto",         # 사용 가능한 GPU에 자동 배치
)
같은 입력으로 비교
- 비교 원칙: 디코딩 방법만 바꾸고 모형, 입력, 최대 생성 길이는 고정
- 입력 문장: 설명문의 뒷부분을 이어 쓰는 일반 문자열
prompt = "인공지능은 데이터를 학습하여 패턴을 찾는다. 이를 활용하면"  # 공통 입력
inputs = tokenizer(
    prompt,
    return_tensors="pt",  # 토큰 ID를 PyTorch 텐서로 반환
).to(model.device)         # 입력을 모형과 같은 장치로 이동

input_length = inputs["input_ids"].shape[1]  # 입력 토큰 수
inputs["input_ids"].shape  # 배치 크기와 입력 토큰 수
실행 결과
torch.Size([1, 16])
-
입력 변환 결과: 일반 문자열이 16개 토큰으로 변환
-
decode_new_tokens(): 입력 이후에 새로 생성한 부분만 문자열로 복원
def decode_new_tokens(output_ids):
    return tokenizer.batch_decode(
        output_ids[:, input_length:],  # 입력을 제외한 생성 토큰만 선택
        skip_special_tokens=True,      # 제어용 특수 토큰은 문자열에서 제외
    )
언어 모형의 탐욕 탐색
do_sample=False: 확률에 따른 무작위 추출을 사용하지 않음num_beams=1: 매 단계에서 후보 하나만 유지
with torch.inference_mode():  # 기울기 계산을 꺼 메모리와 연산 절약
    greedy_ids = model.generate(
        **inputs,           # input_ids와 attention_mask 전달
        max_new_tokens=48,  # 입력 뒤에 최대 48개 토큰 생성
        do_sample=False,    # 확률에 따른 무작위 추출을 끔
        num_beams=1,        # 후보 하나만 유지하는 탐욕 탐색
        use_cache=True,     # 이전 토큰의 Key·Value를 KV 캐시에 저장해 재사용
    )

greedy_text = decode_new_tokens(greedy_ids)[0]  # 첫 번째 생성 문장
greedy_text  # 탐욕 탐색 결과
실행 결과
' 더 이상의 시간이 있는 것으로 알 수 있다.'
- 생성 결과: 짧은 한 문장을 생성했지만 입력 의미와의 연결은 약함
- 결과의 의미: 매 단계에서 가장 높은 확률의 토큰을 선택했지만 문장 전체의 최적해라는 보장은 없음
빔 탐색
- 빔 탐색(beam search): 매 단계에서 확률이 높은 문장 후보를 여러 개 유지
- 빔 크기(beam size): 유지할 후보 수
num_beams=4: 후보 네 개를 유지하며 확장
num_return_sequences=3: 최종 후보 중 세 개를 반환- 탐욕 탐색과의 관계:
num_beams=1인 빔 탐색은 탐욕 탐색과 같음 - 가상 언어 모형에 빔 크기 2를 적용:
- 첫 단계:
나는(0.6)과오늘(0.4)을 모두 유지 - 둘째 단계: 네 후보 중 전체 확률이 높은
오늘 걷는다(0.36)와나는 걷는다(0.33)를 유지 - 최종 선택: 탐욕 탐색이 놓친
오늘 걷는다
- 첫 단계:
- 한계: 빔 크기를 넘는 후보는 버리므로 전체 확률이 가장 높은 문장을 항상 찾지는 못함
with torch.inference_mode():  # 기울기 계산을 끔
    beam_ids = model.generate(
        **inputs,                 # 토큰화한 입력 전달
        max_new_tokens=48,        # 새 토큰을 최대 48개 생성
        do_sample=False,          # 무작위 추출을 사용하지 않음
        num_beams=4,              # 매 단계에서 후보 네 개 유지
        num_return_sequences=3,   # 최종 후보 세 개 반환
        early_stopping=True,      # 완성된 후보가 충분하면 탐색 종료
        use_cache=True,           # 이전 토큰의 Key·Value를 KV 캐시에 저장해 재사용
    )

beam_texts = decode_new_tokens(beam_ids)
for text in beam_texts:  # 반환된 후보를 차례로 출력
    print(text)
실행 결과
 원하는 가치를 선택할 수 있다. 원하는 가치를 선택하는 것은 다른 사람들과 비교하는 것과 같다. 다른 사람들과 비교하는 것도 가능하다. 다른 사람들과 비교
 원하는 가치를 선택할 수 있다. 원하는 가치를 선택하는 것은 다른 사람들과 비교하는 것과 같다. 다른 사람들과 비교하는 것도 가능하다. 다른 사람들과의
 원하는 가치를 선택할 수 있다. 원하는 가치를 선택하는 것은 다른 사람들과 비교하는 것과 같다. 다른 사람들과 비교하는 것은 다른 사람들과 같은 정도로
- 탐욕 탐색과의 차이: 첫 토큰부터 다른 문장을 생성
- 가상 언어 모형의 예처럼 첫 단계에서 확률이 가장 높지 않은 토큰으로 시작한 문장이 전체 점수는 더 높았음
- 후보 사이의 차이: 세 후보가 거의 같은 문장 구조와 표현을 사용
- 최대 생성 길이: 세 후보 모두 문장을 끝내지 못한 채 생성이 종료
- 주의: 빔 수를 늘려도 사람이 보기에 더 좋은 문장이 반드시 생성되는 것은 아님
다양한 빔 탐색
- 일반 빔 탐색의 문제: 점수가 높은 후보들이 같은 시작과 문장 구조에 몰리기 쉬움
- 다양한 빔 탐색(Diverse Beam Search): 빔을 여러 그룹으로 나누고 비슷한 선택에 벌점을 적용
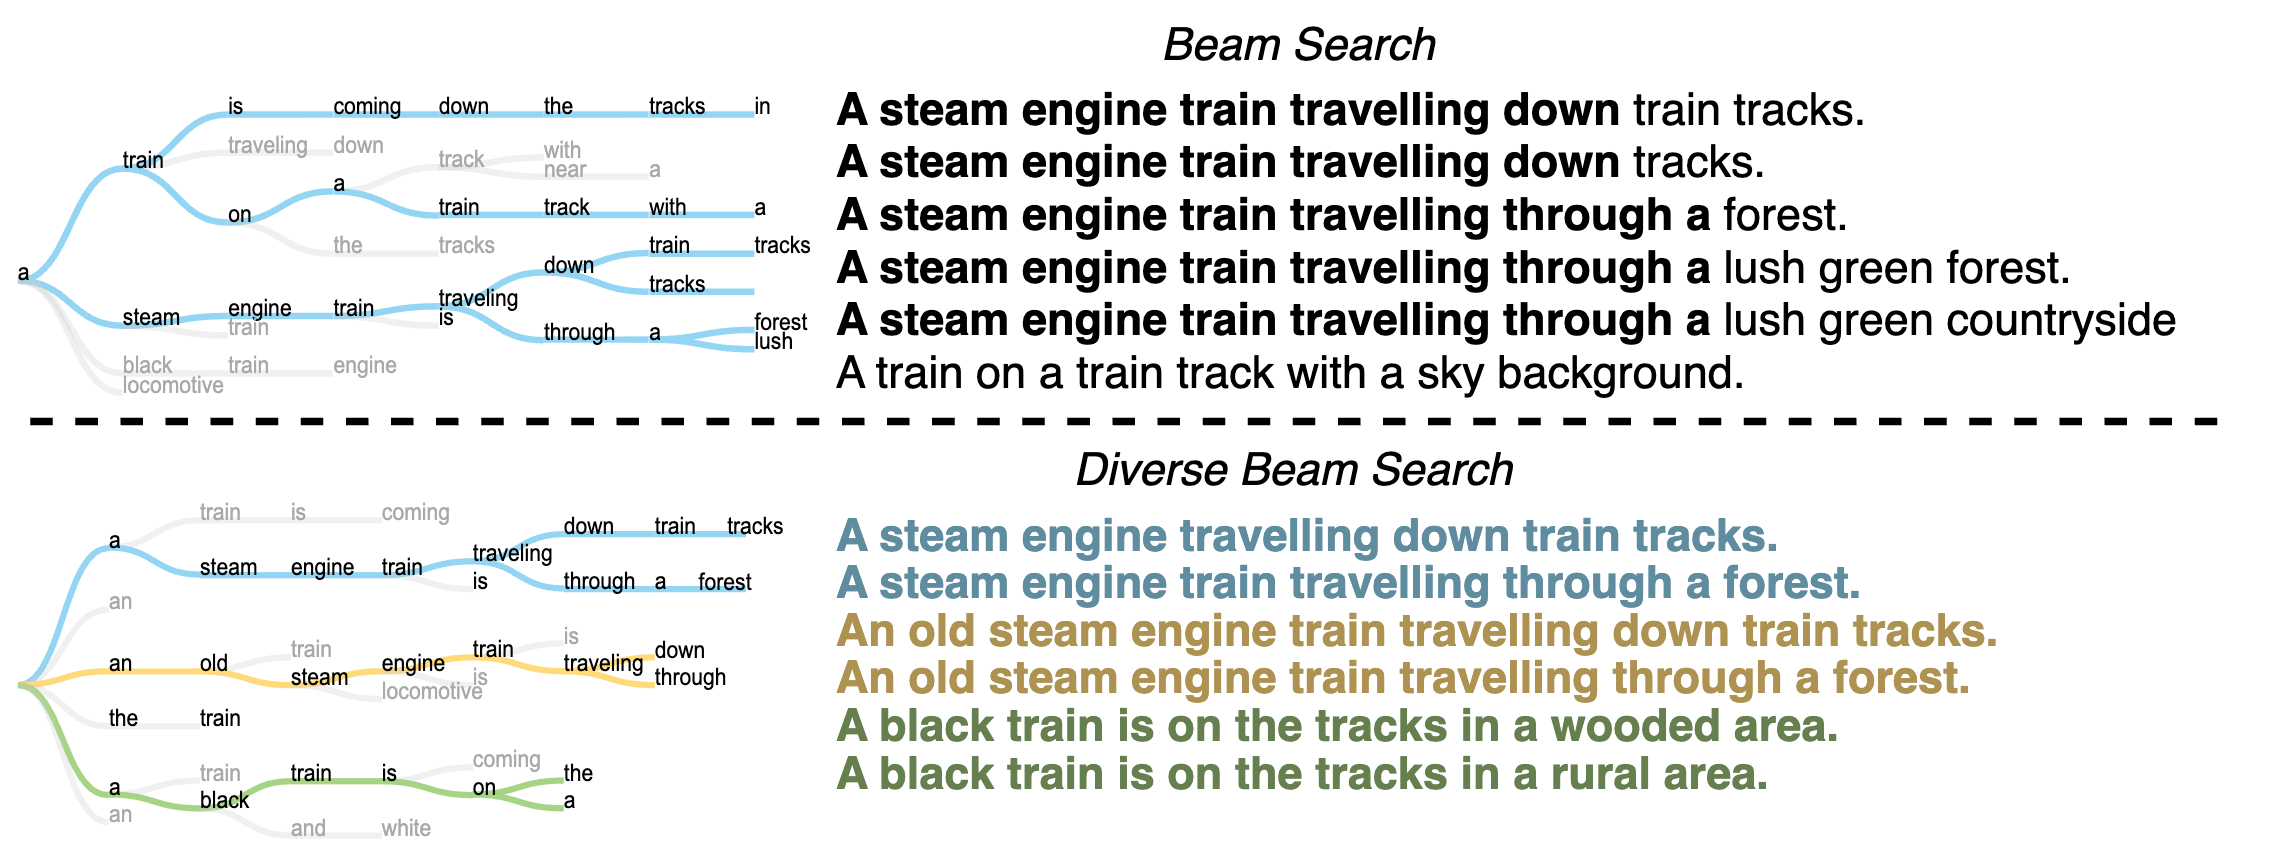
- 위 그림: 기차 사진의 설명문을 생성한 예
- 일반 빔 탐색(위): 여섯 후보 중 다섯이
A steam engine train travelling으로 시작 - 다양한 빔 탐색(아래): 세 그룹이
A steam engine,An old steam engine,A black train으로 서로 다르게 시작
- 일반 빔 탐색(위): 여섯 후보 중 다섯이
- 그룹별 탐색:
- 첫 번째 그룹: 일반 빔 탐색처럼 점수가 높은 후보를 선택
- 다음 그룹: 같은 생성 단계에서 앞선 그룹이 선택한 토큰의 점수를 낮춘 뒤 후보를 선택
- 각 그룹: 선택한 후보를 다음 단계까지 따로 유지해 서로 다른 문장 경로를 탐색
with torch.inference_mode():  # 기울기 계산을 끔
    diverse_beam_ids = model.generate(
        **inputs,                 # 토큰화한 입력 전달
        max_new_tokens=48,        # 새 토큰을 최대 48개 생성
        do_sample=False,          # 무작위 추출을 사용하지 않음
        num_beams=6,              # 전체 후보 여섯 개 유지
        num_beam_groups=3,        # 후보를 세 그룹으로 분할
        diversity_penalty=2.0,    # 앞선 그룹과 같은 선택에 벌점 적용
        num_return_sequences=3,   # 최종 후보 세 개 반환
        use_cache=True,           # 이전 토큰의 Key·Value를 KV 캐시에 저장해 재사용
    )

diverse_beam_texts = decode_new_tokens(diverse_beam_ids)
for text in diverse_beam_texts:  # 반환된 후보를 차례로 출력
    print(text)
실행 결과
 원하는 가치를 선택할 수 있다. 원하는 가치를 선택하는 것은 다른 사람들과 비교하는 것과 같다. 다른 사람들과 비교하는 것도 가능하다. 다른 사람들과 비교
 원하는 가치를 선택할 수 있다. 원하는 가치를 선택하는 것은 다른 사람들과 비교하는 것과 같다. 다른 사람들과 비교하는 것도 가능하다. 다른 사람들과의
 추가 비용이 발생할 수 있다. 필요하며, 필요하며.
- 일반 빔 탐색과의 공통점: 앞의 두 후보는 같은 결과
- 다양한 빔 탐색의 차이: 세 번째 후보가 다른 시작과 내용을 사용
- 한계: 후보 사이의 차이를 강제로 키우면 문맥 적합성이나 문장 품질이 낮아질 수 있음
대조 탐색
- 대조 탐색(contrastive search): 확률이 높은 후보 중에서 이전 표현과 지나치게 비슷하지 않은 토큰을 선택
- 후보: 현재 단계에서 확률이 높은 상위 개 토큰
- 후보 점수: 두 기준을 하나로 합쳐 점수가 가장 높은 후보를 선택
- 확률: 현재 문맥 다음에 그 토큰이 올 확률
- 모형이 자연스럽다고 보는 토큰에 높은 점수
- 최대 유사도: 후보 토큰의 표현을 앞에서 생성한 토큰들의 표현과 비교했을 때 가장 비슷한 정도
- 이미 나온 표현과 비슷할수록 큰 값을 빼므로 반복이 억제됨
- : 두 기준의 비중을 정하는 0과 1 사이의 값
- : 확률만 비교하므로 탐욕 탐색과 같음
- 가 커질수록 반복에 더 강한 벌점 적용
with torch.inference_mode():  # 기울기 계산을 끔
    contrastive_ids = model.generate(
        **inputs,            # 토큰화한 입력 전달
        max_new_tokens=48,   # 새 토큰을 최대 48개 생성
        do_sample=False,     # 무작위 추출을 사용하지 않음
        penalty_alpha=0.6,   # 반복 억제와 모형 확률의 균형 조절
        top_k=4,             # 확률이 높은 토큰 네 개를 비교
        use_cache=True,      # 이전 토큰의 Key·Value를 KV 캐시에 저장해 재사용
    )

contrastive_text = decode_new_tokens(contrastive_ids)[0]  # 첫 번째 생성 문장
contrastive_text  # 대조 탐색 결과
실행 결과
' 원하는 가치를 쉽게 구할 수 있다.'
- 생성 결과: 빔 탐색보다 짧고 반복이 적은 문장을 생성
- 해석: 확률뿐 아니라 앞선 토큰 표현과의 유사성도 선택 기준에 포함해 다른 결과를 생성
- 주의: 한 예의 결과만으로 특정 방법이 항상 더 좋다고 판단할 수 없음
방법 비교
| 방법 | 단계마다 유지하는 후보 | 특징 | 주요 한계 |
|---|---|---|---|
| 완전 탐색 | 모든 후보 | 전체 후보 중 최고 점수 확인 | 후보 수가 지수적으로 증가 |
| 탐욕 탐색 | 1개 | 가장 빠르고 단순 | 초기에 버린 후보를 복구할 수 없음 |
| 빔 탐색 | 여러 개 | 문장 후보를 병렬로 비교 | 후보가 서로 비슷해지기 쉬움 |
| 다양한 빔 탐색 | 여러 그룹 | 후보 사이의 차이를 유도 | 다양성과 품질 사이의 조절 필요 |
| 대조 탐색 | 1개 (상위 개 토큰을 비교해 선택) | 확률과 반복 억제를 함께 고려 | 추가 계산과 매개변수 설정 필요 |
- 공통점: 확률에 따른 무작위 추출을 사용하지 않음
- 차이점: 탐색 범위와 후보를 평가하는 기준
- 실무 선택: 정답이 하나가 아니라면 최고 확률만 추구하기보다 과업의 목적과 생성 품질을 함께 평가
Transformers 5 버전에서 변경 사항
- 다양한 빔 탐색과 대조 탐색: 핵심 라이브러리의 복잡성을 줄이기 위해 기본
generate()에서 제외 - 대신 허브 저장소(
transformers-community/group-beam-search,transformers-community/contrastive-search)의 구현을custom_generate인자로 불러와 사용 가능 - 실습 환경을 Transformers 4.55.4로 고정한 이유