
튜링 테스트
튜링 테스트(Turing test)
- 튜링 테스트: 평가자가 문자 대화 상대를 사람 또는 기계로 판정하는 실험
- 1950년 앨런 튜링의 모방 게임에서 출발
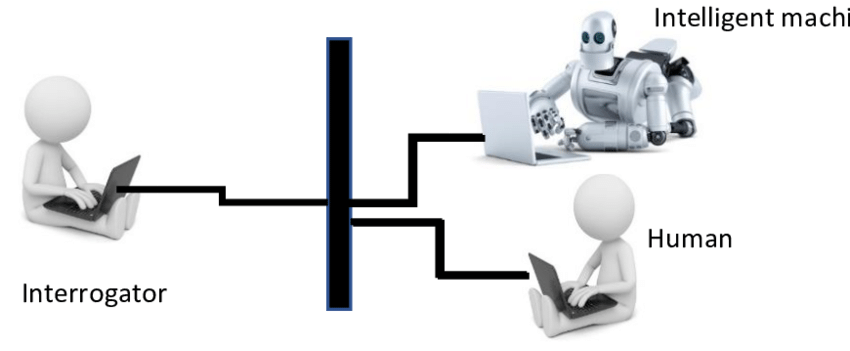
- 평가자는 상대의 정체를 모른 채 사람 또는 기계와 대화
- 대화 결과만으로 상대가 사람인지 기계인지 판정
- 기계를 사람과 안정적으로 구분하지 못한다면 인간과 비슷한 언어 생성 능력을 보인 것으로 해석
튜링 테스트의 한계
- 언어 표현과 사고 능력을 동일하게 취급하기 어려움
- 생각하지만 말하지 못하는 경우
- 자연스럽게 말하지만 실제 추론은 부족한 경우
- 짧은 대화에서는 평가자를 속이기 쉬움
- 인간의 편향과 기대를 이용하는 응답이 높은 평가를 받을 수 있음
- 사람처럼 보이는 능력은 사실성, 안전성, 과업 성공과 다른 평가 목표
- ELIZA: 1966년 규칙 기반 챗봇이지만 짧은 대화에서는 사람과 대화한다는 인상을 제공
- 적절한 해석: 일반 지능의 완전한 검증보다 대화의 인간 유사성 평가
GPT-4.5 튜링 테스트 사례
- 실험: 2025년 사전 등록된 3자 튜링 테스트
- 참가자가 5분 동안 사람과 AI를 동시에 대화한 뒤 사람을 선택
- 결과: 인간과 비슷한 페르소나를 사용한 GPT-4.5가 사람으로 선택된 비율 73%
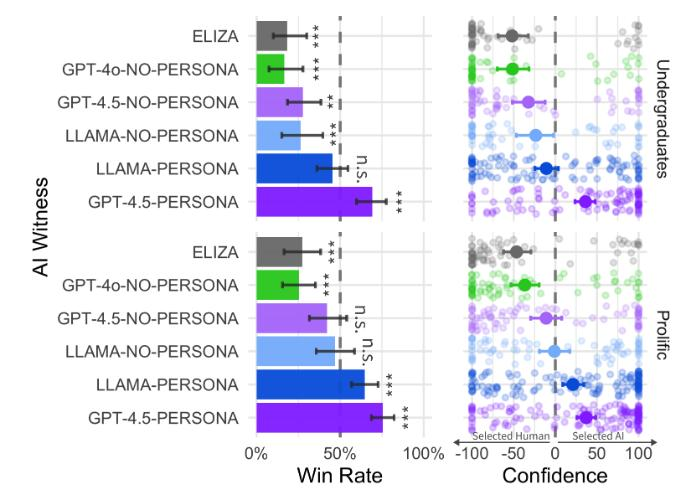
- 해석: 특정 모형이 특정한 3자 튜링 테스트를 통과했다는 증거
- 한계: 모든 형태의 지능이나 실제 과업 능력에 대한 검증은 아님
출처: Large Language Models Pass the Turing Test
Arena.ai
- Arena.ai: 인간 선호 평가 플랫폼
- 이전 이름: Chatbot Arena, LMArena
- 배틀 모드에서 익명의 모형 두 개가 같은 프롬프트에 답변
- 사용자가 더 적합한 답변에 투표한 뒤 모형 이름 공개
- 누적된 선호 투표를 공개 리더보드에 반영
- 텍스트뿐 아니라 에이전트, 웹 개발, 이미지, 영상, 문서, 검색 등으로 평가 범위 확장
- 순위의 의미: 표준 시험 점수보다 실제 사용자의 상대적 선호
- 별도 확인 항목: 사실 정확성, 비용, 응답 속도
인간 평가의 한계
- 속기 쉬움
- 짧은 대화만으로 품질을 정확히 판단하기 어려움
- 길고 구체적인 답변을 더 좋은 답변으로 평가하는 경향
- 평가자 간 차이
- 전문 지식, 문화, 선호, 평가 기준에 따라 판단이 달라짐
- 시간과 비용
- 미묘한 성능 차이를 확인하려면 많은 평가자와 반복 평가 필요
- 다양성 평가의 어려움
- 한 번에 확인할 수 있는 생성문 수가 제한됨
- 일부 좋은 사례만 보고 모형 전체의 다양성을 판단하기 어려움
- 보상 해킹 위험: 실제 목표보다 평가자의 취향이나 보상 모형의 허점을 공략할 가능성
참고: Language Models Learn to Mislead Humans via RLHF
HUSE
- HUSE(Human Unified with Statistical Evaluation): 인간 평가와 통계 평가를 결합한 생성 품질·다양성 평가
- 사람이 생성한 문장 와 모형이 생성한 문장 를 수집
- 사람이 각 문장의 품질 점수 를 평가
- 언어 모형으로 각 문장의 혼란도 를 계산
- 를 이용해 문장이 인지 인지 분류
- 두 종류를 구분하기 어려울수록 사람의 문장 분포와 비슷한 생성 모형으로 평가
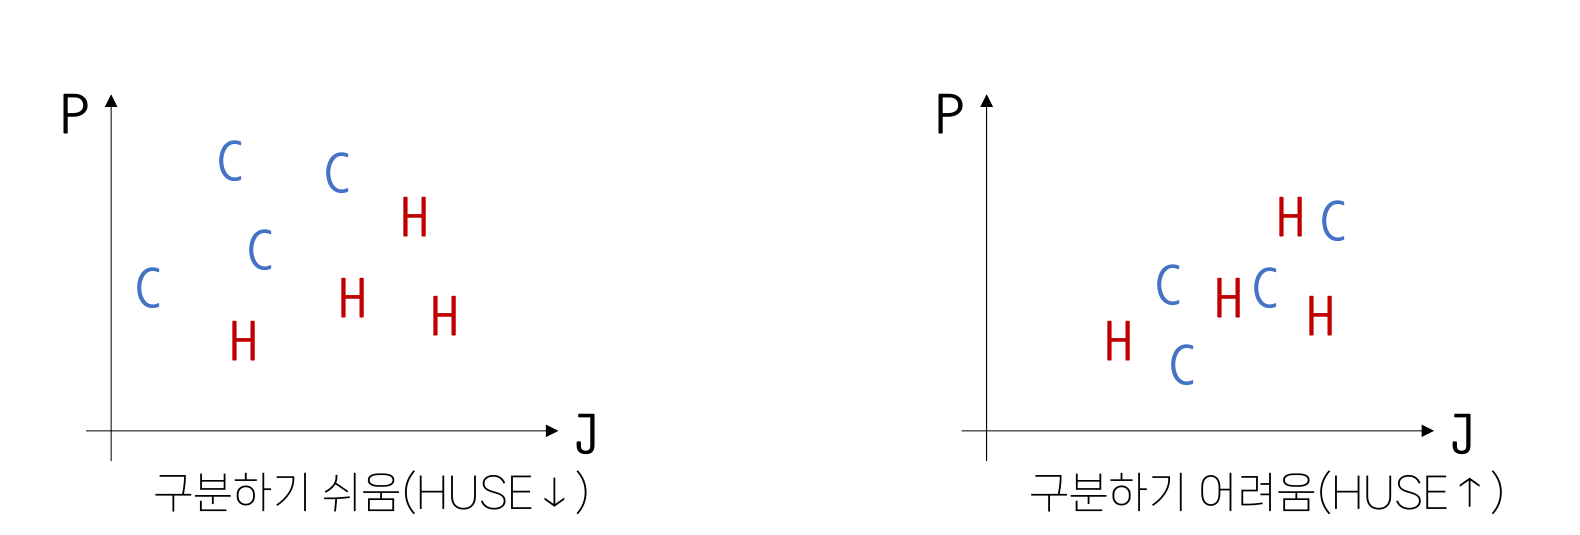
- : 분류기의 오답률에 2를 곱한 점수
- 오답률이 25%이면
- : 최적 분류기가 도달할 수 있는 오답률의 하한을 이용한 점수
- 이면 오답률이 50%여서 사람과 모형의 문장을 구분할 수 없는 상태
- 실제 는 알 수 없으므로 k-최근접 이웃 등의 분류기로 근사값 계산
출처: Unifying Human and Statistical Evaluation for Natural Language Generation