
Hugging Face Transformers
Hugging Face에서 한국어 언어 모형과 토크나이저를 내려받는다.
Hugging Face와 Transformers
- Hugging Face: 인공지능 모형과 데이터셋을 공유하는 플랫폼
- 모형 허브(Model Hub)의 저장소에 모형 설정, 토크나이저, 학습된 파라미터 등을 게시
- Transformers: 허브의 모형을 내려받아 실행하는 파이썬 라이브러리
- 저장소 식별자로 모형에 맞는 구성 요소를 자동으로 불러옴
| 구성 요소 | 역할 |
|---|---|
| 토크나이저(tokenizer) | 텍스트를 토큰 ID로 바꾸고 다시 텍스트로 복원 |
| 언어 모형(language model) | 입력 토큰을 바탕으로 다음 토큰의 점수를 계산 |
| 채팅 템플릿(chat template) | 사용자와 모형의 메시지를 학습 때 사용한 형식으로 변환 |
실습 준비
- Colab: 런타임 → 런타임 유형 변경 → T4 GPU 선택
- EXAONE 4.0: Transformers 4.54.0 이상에서 지원
- 실습 환경: 고급 디코딩 실습과 호환되는 Transformers 4.55.4
!pip install -q "transformers==4.55.4" accelerate jinja2
import torch
from transformers import AutoModelForCausalLM, AutoTokenizer
GPU 확인
- 언어 모형: 많은 행렬 계산을 수행하므로 CPU보다 GPU에서 훨씬 빠르게 실행
- 첫 확인 사항: Colab의 GPU 연결 여부
torch.cuda.is_available() # GPU 사용 가능 여부
실행 결과
True
- GPU 이름: Colab이 배정한 장치에 따라 달라질 수 있음
torch.cuda.get_device_name() # GPU 이름
실행 결과
'Tesla T4'
False가 나온다면
- 런타임 유형을 GPU로 변경한 뒤 처음부터 다시 실행
- CPU에서도 실행 가능하지만 모형을 불러오고 생성하는 데 오랜 시간 필요
모형 저장소 선택
- 저장소 식별자: 보통
제작자/모형이름형식 - 실습 모형: EXAONE 4.0 1.2B
- LG AI연구원이 공개한 소형 언어 모형
- 한국어·영어·스페인어와 일반 응답·추론 모드를 지원
- 기기 내 실행을 위해 설계된 크기로 Colab 실습에 적합
model_name = "LGAI-EXAONE/EXAONE-4.0-1.2B"
model_name
실행 결과
'LGAI-EXAONE/EXAONE-4.0-1.2B'
토크나이저 내려받기
AutoTokenizer: 저장소의 설정을 읽고 해당 모형에 맞는 토크나이저를 선택from_pretrained(): 처음 실행할 때 필요한 파일을 다운로드- 다음 실행부터 캐시에 저장된 파일을 재사용
tokenizer = AutoTokenizer.from_pretrained(model_name)
tokenizer.vocab_size  # 어휘 집합의 크기
실행 결과
102400
- 어휘 집합의 크기: 102,400개 토큰
- 모형의 입력: 문자열이 아니라 어휘 집합에 등록된 토큰의 정수 ID
텍스트를 토큰 ID로 변환
tokenizer(문자열): 텍스트를 토큰 ID로 변환한 결과를 사전 형태로 반환input_ids: 토큰 ID 목록
text = "안녕하세요. 토큰화를 연습합니다."
token_ids = tokenizer(text)["input_ids"]
token_ids
실행 결과
[3801, 1130, 5847, 375, 57457, 1255, 4605, 7748, 14010, 375]
- 토큰 조각 확인: ID 하나씩 문자열로 복원해 토큰 경계를 확인
[tokenizer.decode([token_id]) for token_id in token_ids] # 토큰 조각
실행 결과
['안녕', '하', '세요', '.', ' 토큰', '화', '를', ' 연습', '합니다', '.']
- 토큰 경계:
안녕하세요는안녕,하,세요로 나뉘고, 앞 공백은' 토큰'처럼 다음 글자와 함께 묶임 - 토큰 실습의
o200k_base와 비교: 토큰 수는 10개로 같지만 경계는 다름- 토큰 수와 경계는 토크나이저마다 다르므로 모형에 맞는 토크나이저를 사용
decode(): 토큰 ID 목록을 원래 문자열로 복원
tokenizer.decode(token_ids)
실행 결과
'안녕하세요. 토큰화를 연습합니다.'
언어 모형 내려받기
AutoModelForCausalLM: 앞에 나온 토큰으로 다음 토큰을 예측하는 인과적 언어 모형을 로드- 원본 파라미터 자료형:
bfloat16 torch_dtype=torch.float16: 원본 파라미터를 T4 GPU가 지원하는float16으로 변환하여 로드device_map="auto": 사용 가능한 장치에 모형을 자동 배치
model = AutoModelForCausalLM.from_pretrained(
    model_name,
    torch_dtype=torch.float16,  # T4 GPU에서 사용하는 16비트 자료형
    device_map="auto",         # 사용 가능한 GPU에 자동 배치
)
- 첫 실행: 모형 파일을 내려받기 때문에 시간이 걸릴 수 있음
- 다음 실습: 실제 파라미터 수 확인
model.num_parameters() # 전체 파라미터 수
실행 결과
1279391488
1.2B: 약 12억 개 규모라는 뜻- 실제 파라미터 수: 약 12억 8천만 개
model.dtype # 파라미터 자료형
실행 결과
torch.float16
bfloat16과 float16
- 부동소수점 수: 부호(sign), 지수(exponent), 가수(fraction)로 구성
- 지수 비트: 표현 가능한 값의 범위를 결정
- 가수 비트: 수를 얼마나 정밀하게 표현하는지 결정
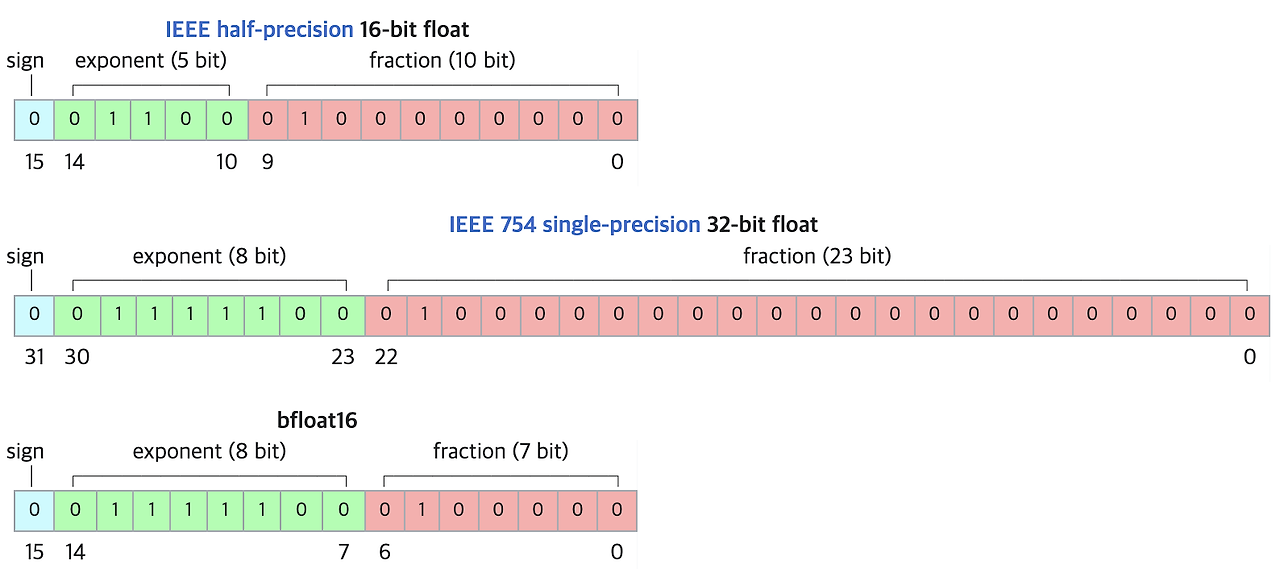
float16: 지수 5비트, 가수 10비트- 표현 범위가 좁지만 같은 범위 안에서
bfloat16보다 정밀 - 매우 큰 값이나 작은 값은 범위를 벗어날 가능성이 높음
- 표현 범위가 좁지만 같은 범위 안에서
bfloat16: 지수 8비트, 가수 7비트float32와 같은 크기의 지수부를 사용해 표현 범위가 넓음- 표현 범위가 넓은 대신
float16보다 정밀도가 낮음
- 공통점: 파라미터당 2바이트로
float32의 절반만 사용 - 실습 환경: EXAONE의 원본 파라미터는
bfloat16이지만 T4 GPU에서는float16으로 변환하여 사용