
스케일링 법칙
모델·데이터·학습 계산량에 따른 예측 손실의 변화
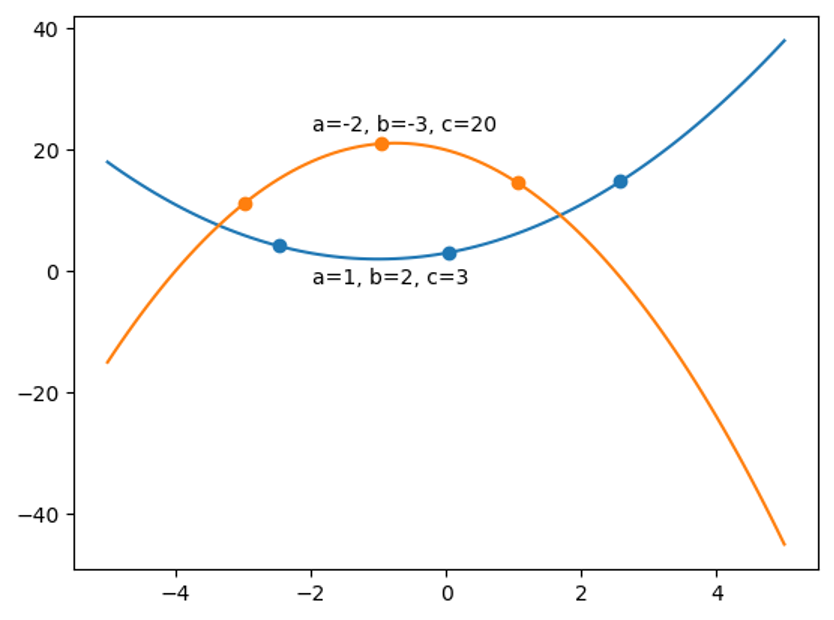
모형과 파라미터
- 모형(model): 데이터의 패턴을 나타내는 수식이나 프로그램
- 예시: 2차 함수 y=ax2+bx+c
- 파라미터(parameter): 모형의 구체적 형태를 결정하는 수치
- 파라미터가 많을수록 더 복잡한 패턴을 나타낼 수 있음
근사(approximation)
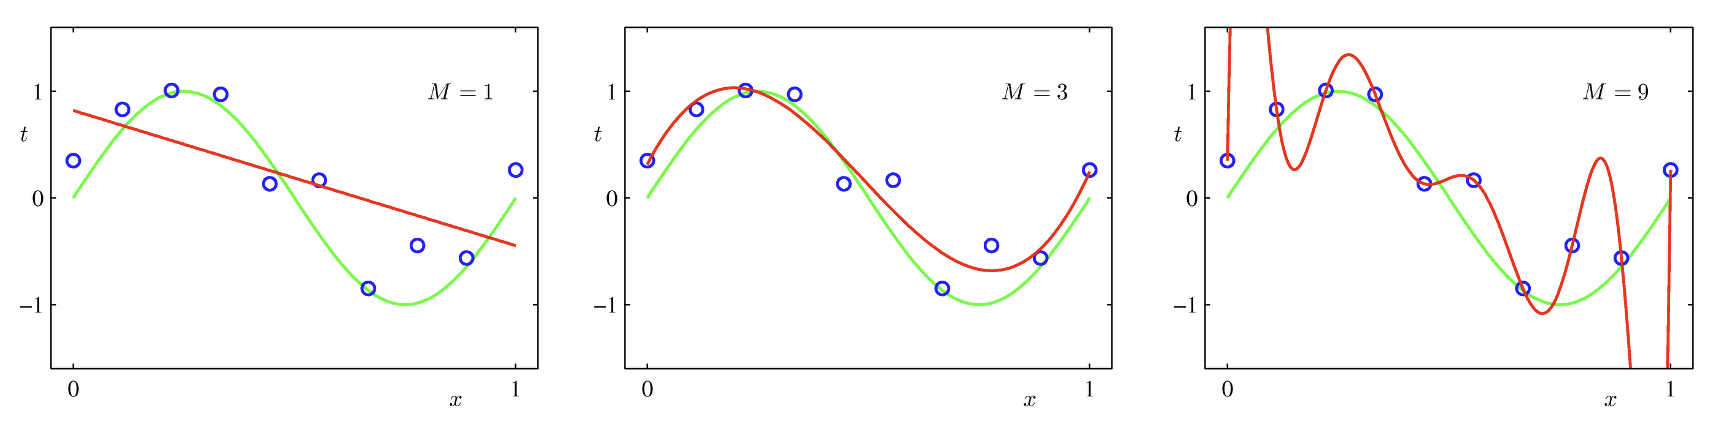
- 언어적 패턴을 구체적인 수식으로 만드는 것은 어려움
- 아이디어:
- 단순한 수식을 여러 번 겹쳐서(=deep learning)
- 적절한 조건에서 연속적인 관계를 원하는 정확도로 근사하는 표현 능력 확보
- 파라미터가 많을수록 더 복잡한 패턴을 비슷하게 만들 수 있음
- 언어 모델의 학습: 대량의 언어 데이터로부터 그 패턴을 비슷하게 만들 수 있는 파라미터를 추정하는 것
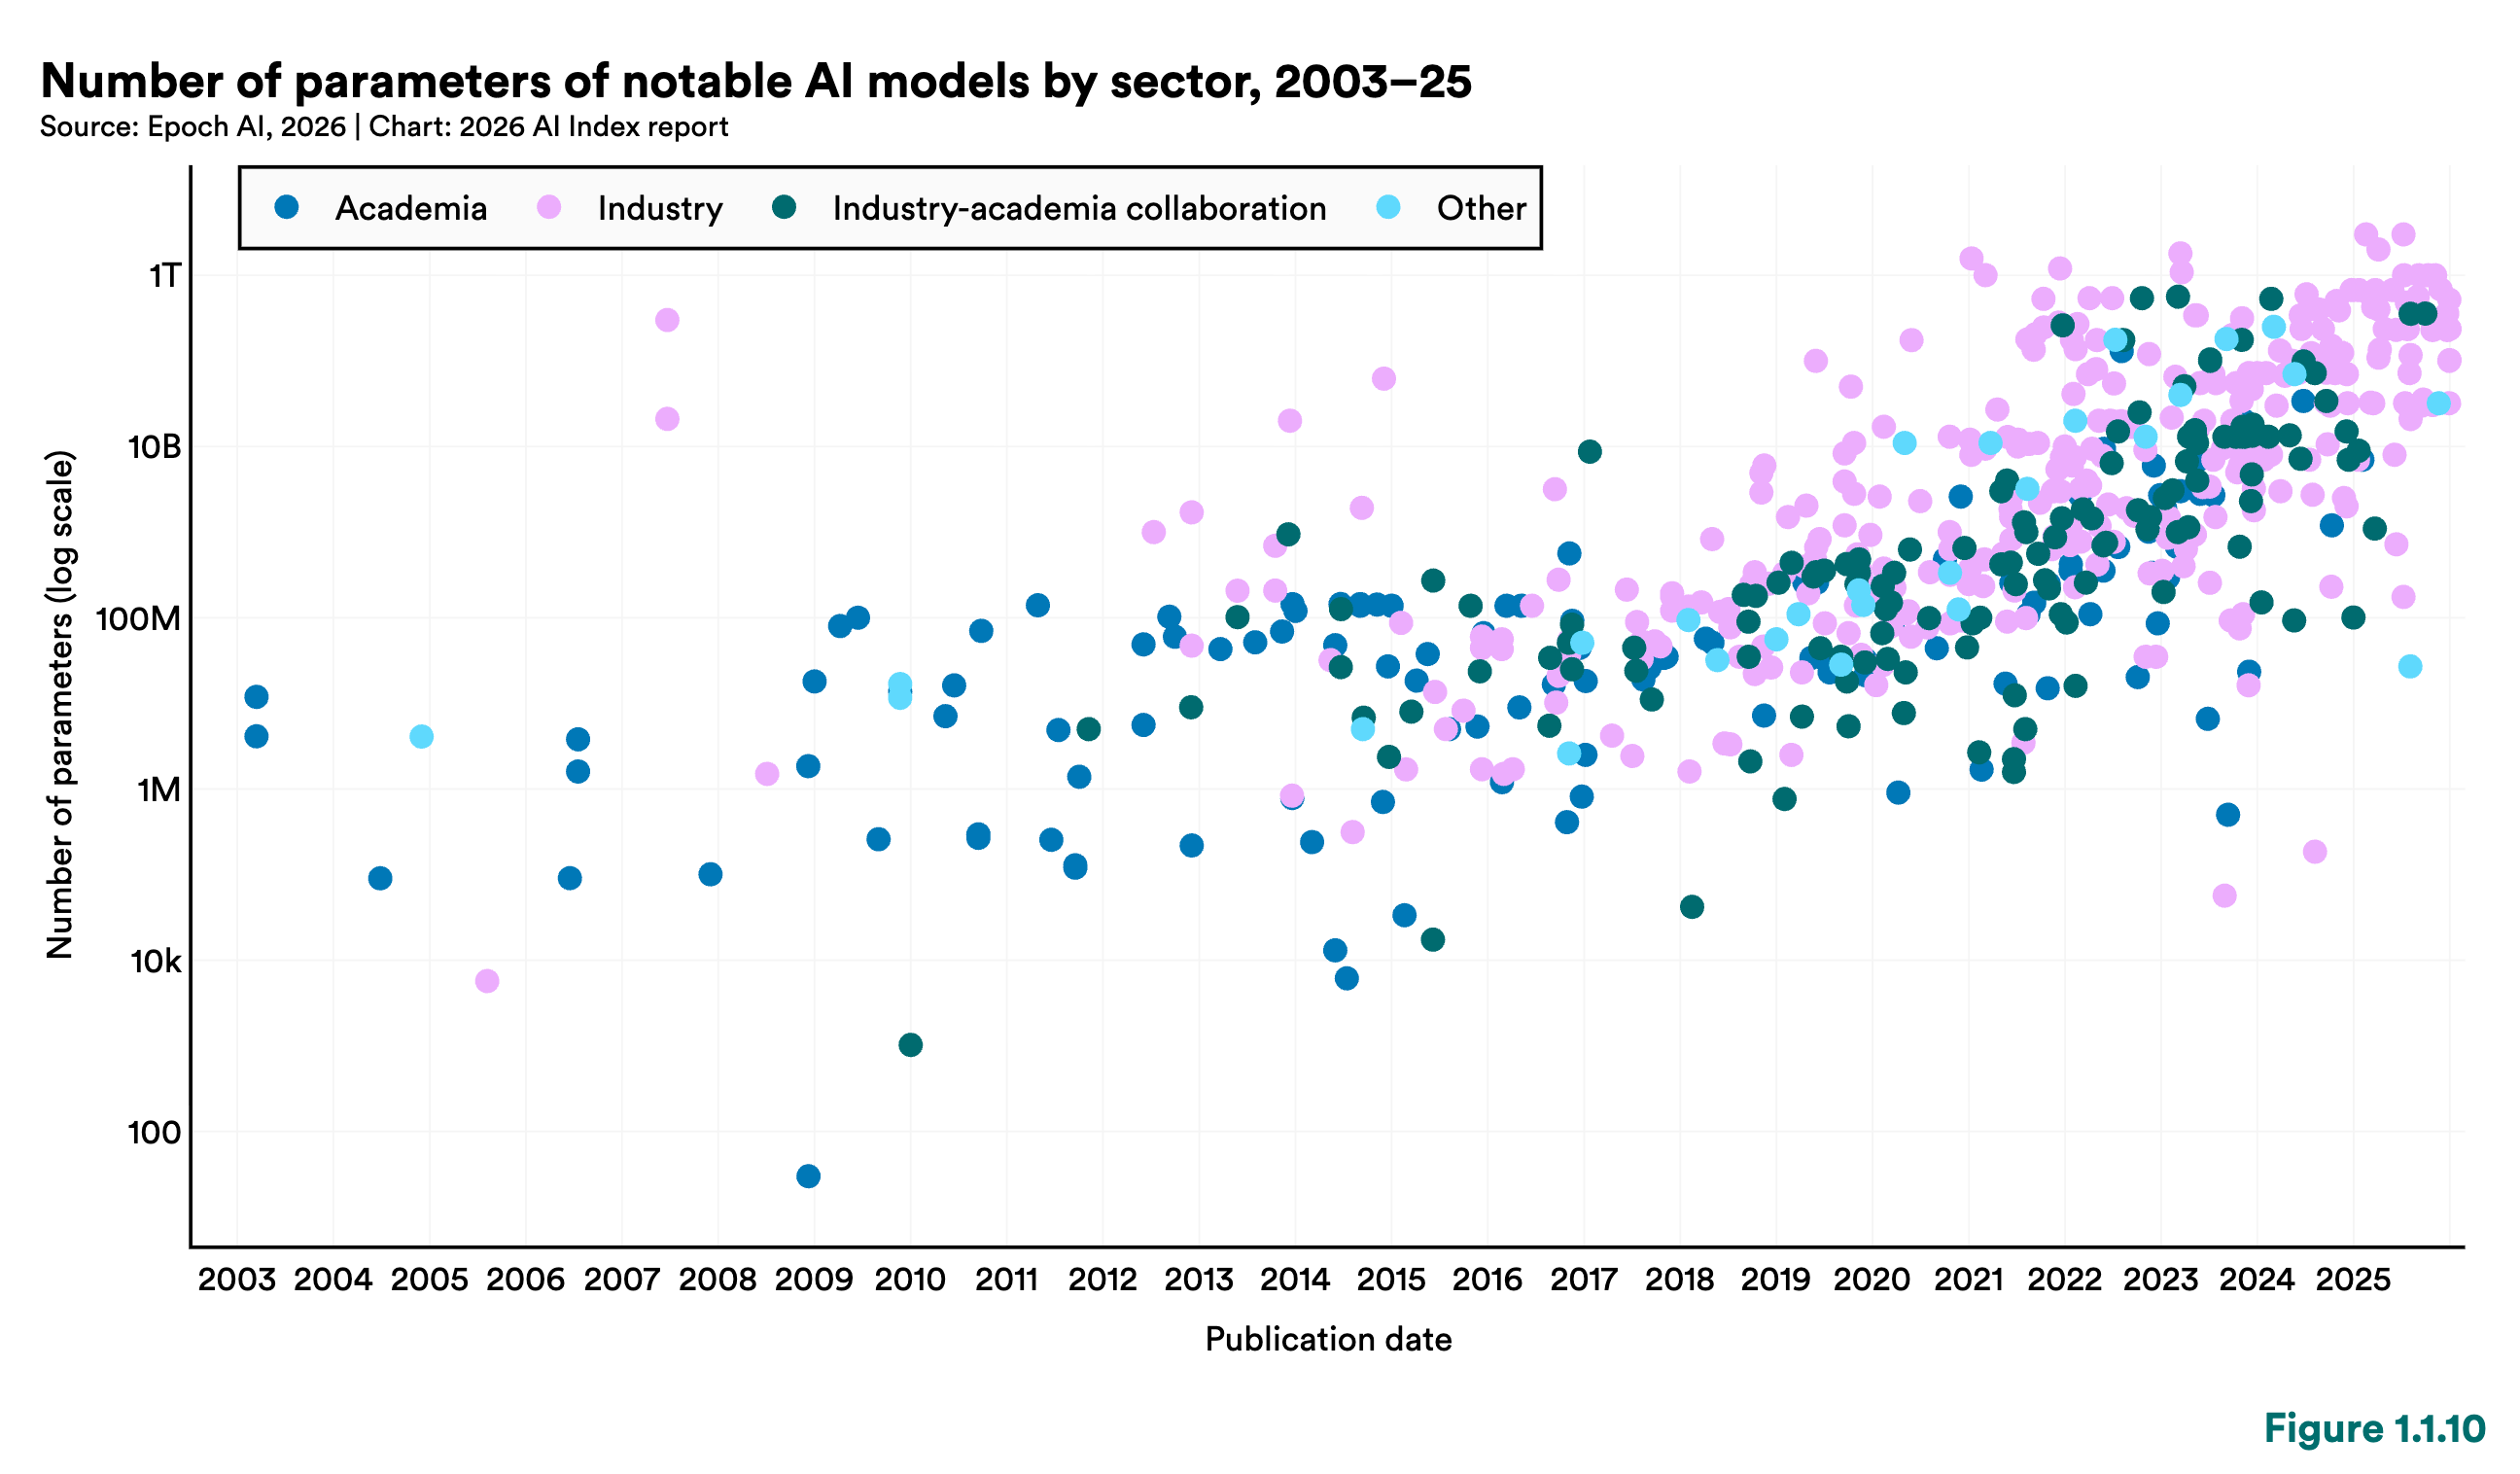
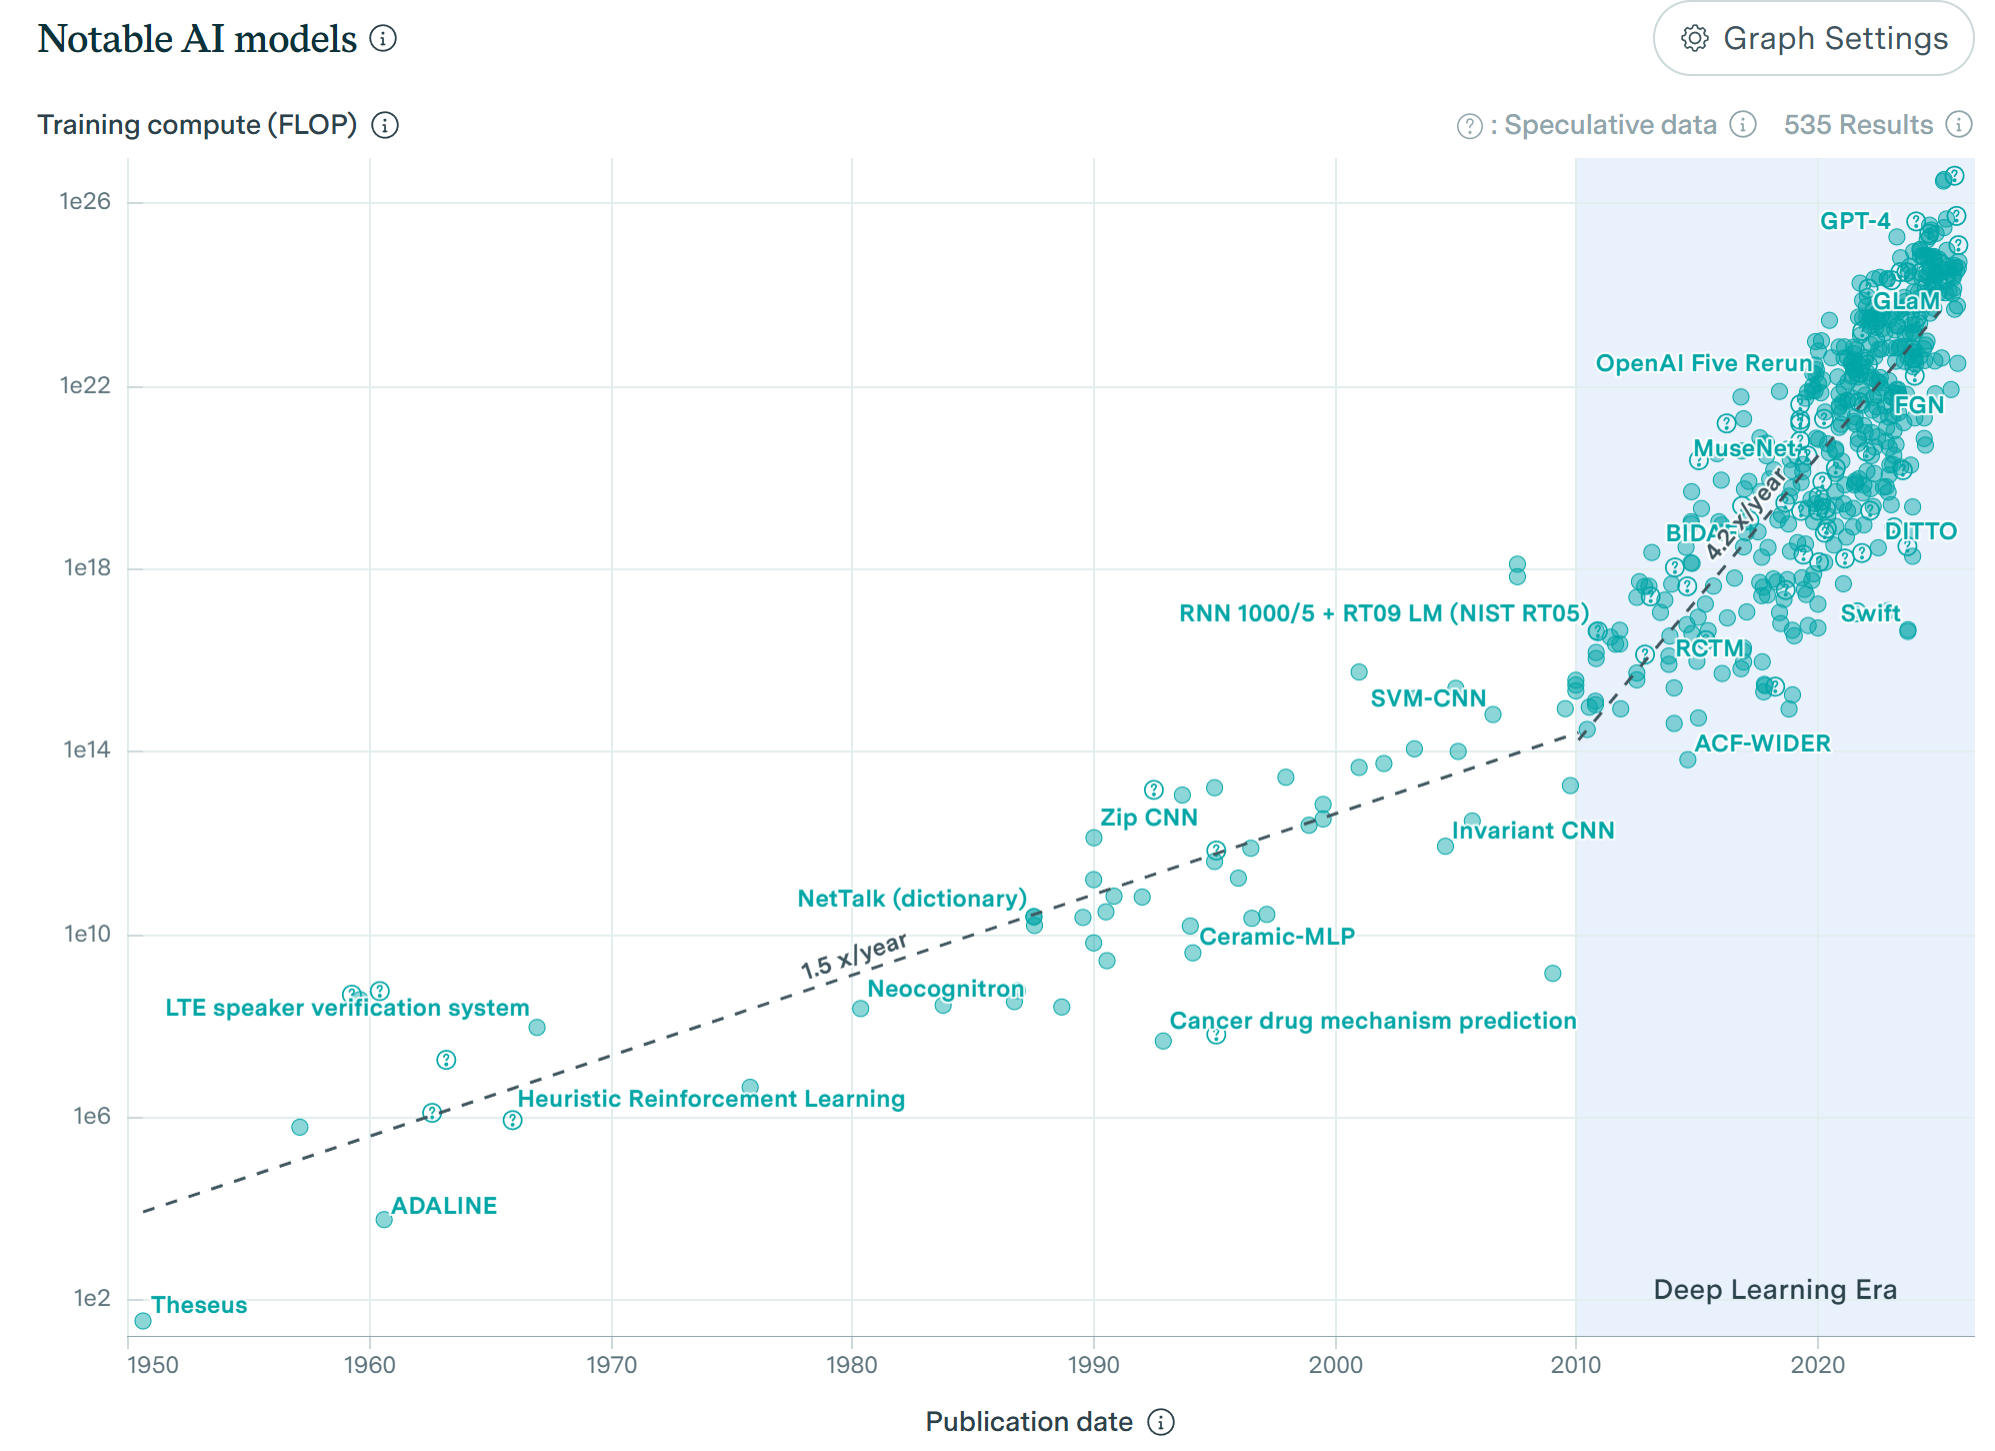
AI 모델의 파라미터
- 모델 파라미터 수 증가
- 데이터셋 크기 증가
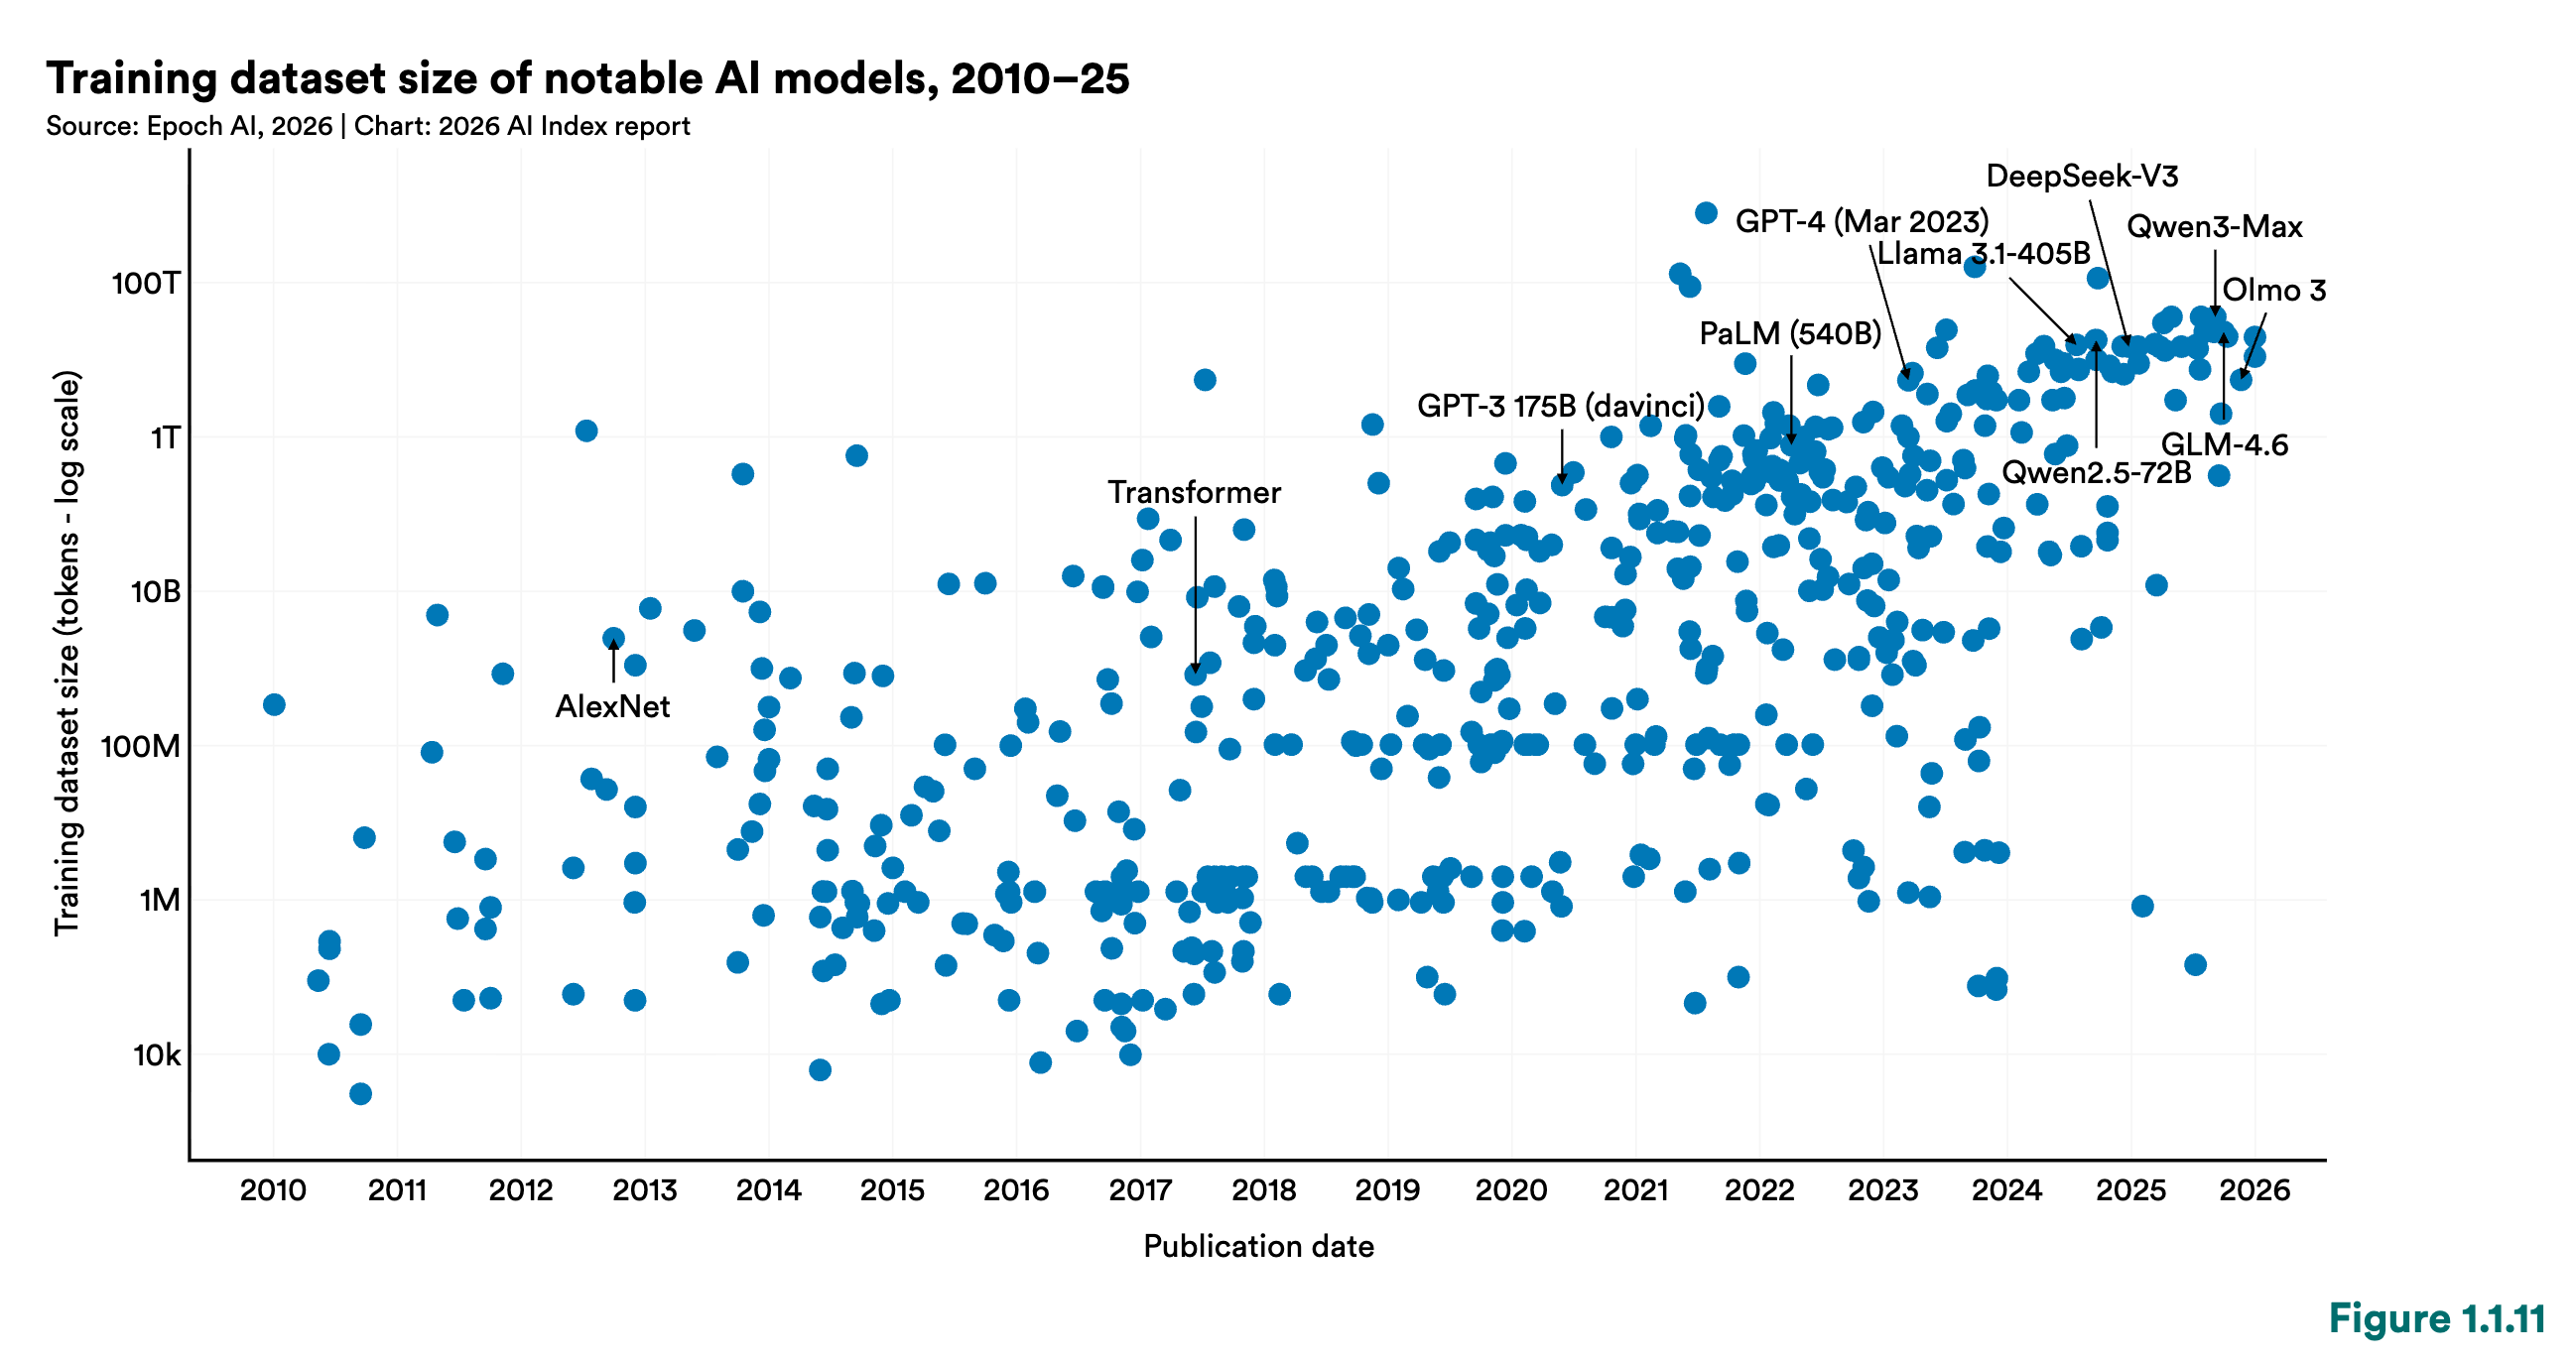
그림 출처: Artificial Intelligence Index Report 2026
- 학습 계산량 증가
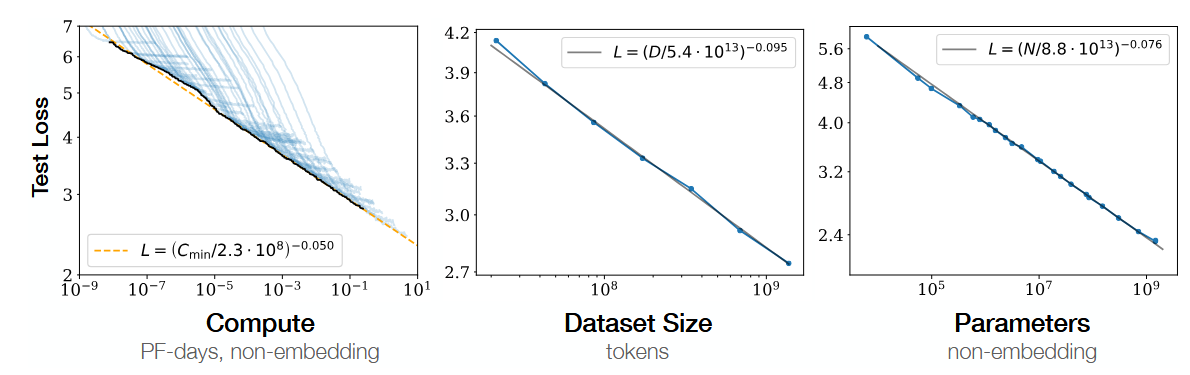
스케일링 법칙
- Scaling Laws for Neural Language Models (Kaplan 외, 2020)
- 스케일링 법칙(scaling law): 일정한 학습 조건에서 모델·데이터·계산 규모와 예측 손실 사이에 관찰되는 경험적 관계
- 대표적인 형태: 규모가 커질수록 손실이 멱법칙, 즉 거듭제곱 형태의 추세를 따라 감소
- 활용: 작은 실험으로 더 큰 학습의 손실과 필요한 계산량을 추정
- 적용 범위: 같은 계열의 모델과 비교 가능한 데이터·학습 조건에서 추정하고 검증
멱법칙과 수확체감
- 멱법칙(power law): 자원을 일정한 배수로 늘릴 때 손실의 감소 가능한 부분이 일정한 비율로 줄어드는 관계
- 다른 조건이 비교 가능한 범위에서 모델 크기, 데이터 양, 학습 계산량 등의 변화에 적용
- 손실의 하한을 포함한 대표적인 표현
- 기호의 의미
- x: 비교하는 자원의 규모
- L(x): 예측 손실, L0: 해당 조건에서 추정한 손실의 하한
- A: 감소 가능한 손실의 크기를 정하는 양의 상수
- α: 자원 증가에 따른 손실 감소 속도를 정하는 양의 지수
- 실제 지수의 크기: Kaplan 외(2020)가 추정한 α는 대략 0.05-0.1 수준
- 아래 GPT-3 그림의 계산량 지수도 약 0.048
- 예시: α=0.05라면 자원을 10배 늘릴 때마다 L(x)−L0가 약 11% 감소
| 자원의 상대적 규모 | 하한을 초과하는 손실 L(x)−L0 |
|---|---|
| 1 | 1 |
| 10 | 0.891 |
| 100 | 0.794 |
| 1,000 | 0.708 |
| 1,000,000 | 0.501 |
- 수확체감(diminishing returns): 자원을 더 투입해도 추가로 줄어드는 손실은 점점 작아지는 특성
- 예시에서 자원을 10배씩 늘릴 때 추가 자원은 9 → 90 → 900으로 커지지만, 줄어드는 손실은 0.109 → 0.097 → 0.086으로 작아짐
- 하한을 초과하는 손실을 절반으로 줄이려면 자원을 약 100만 배 늘려야 함
- 개선이 멈춘다는 뜻은 아니며, 같은 비율의 개선을 이어가는 데 점점 더 많은 자원이 필요
정해진 학습 연산량을 어디에 쓸까?
- 자원 배분의 문제: 같은 학습 연산량으로도 큰 모델을 적은 토큰으로 학습하거나 작은 모델을 많은 토큰으로 학습하는 선택 가능
- 초기 연구의 결과: Kaplan 외(2020)는 각 연산량 예산에서 손실이 낮은 조합을 추정
- 예산이 커질수록 학습 데이터보다 모델 크기를 더 빠른 비율로 늘리는 전략을 제안
- 큰 모델은 같은 수준의 손실에 더 적은 학습 예시로 도달하는 경향
- 주어진 예산에서는 작은 모델을 끝까지 학습하기보다 큰 모델을 수렴 전에 멈추는 편이 유리하다는 결과
출처: Scaling Laws for Neural Language Models (Kaplan 외, 2020), Training Compute-Optimal Large Language Models (Hoffmann 외, 2022)
GPT-3의 경우
- 가로축: 학습 계산량, 세로축: 검증 데이터의 예측 손실
- 색상: 모델의 파라미터 수
- 관찰: 각 계산량에서 얻은 가장 낮은 검증 손실이 계산량에 따른 추세를 형성
- 의미: 학습 계산량을 늘릴 때의 손실 개선을 예측하는 근거
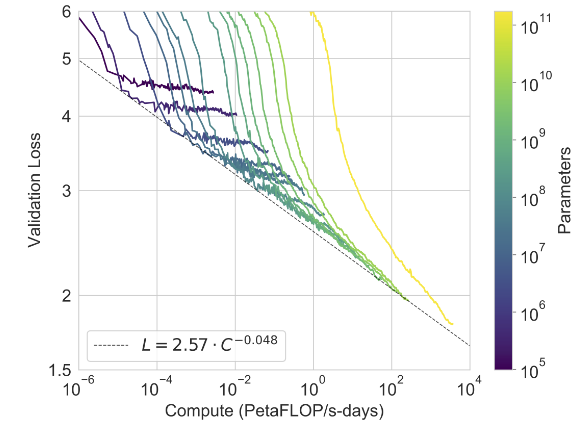
출처: Language Models are Few-Shot Learners https://arxiv.org/pdf/2005.14165
다른 종류의 모델도 스케일링 법칙을 따름
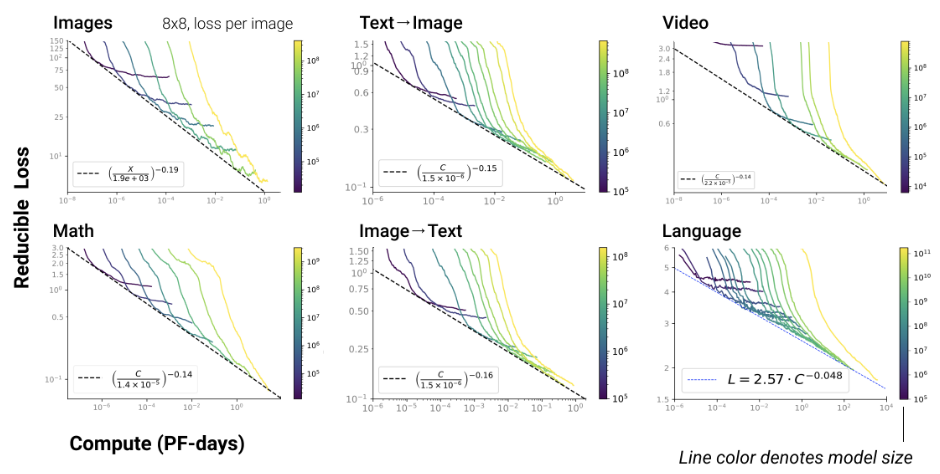
출처: Scaling Laws for Autoregressive Generative Modeling https://arxiv.org/pdf/2010.14701
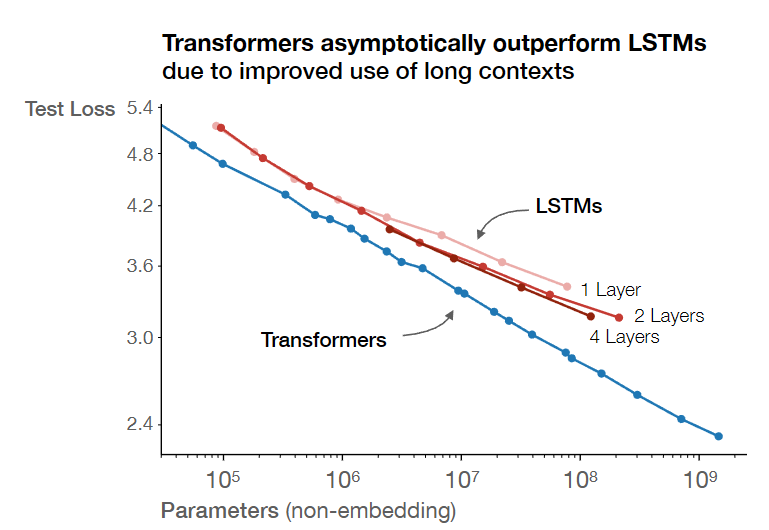
모델에 따라 특성이 다름
- 아래 실험에서는 같은 파라미터 수에서 트랜스포머가 LSTM보다 낮은 테스트 손실을 보임
- 의미: 파라미터 수가 같아도 구조와 학습 조건에 따라 결과가 달라질 수 있음
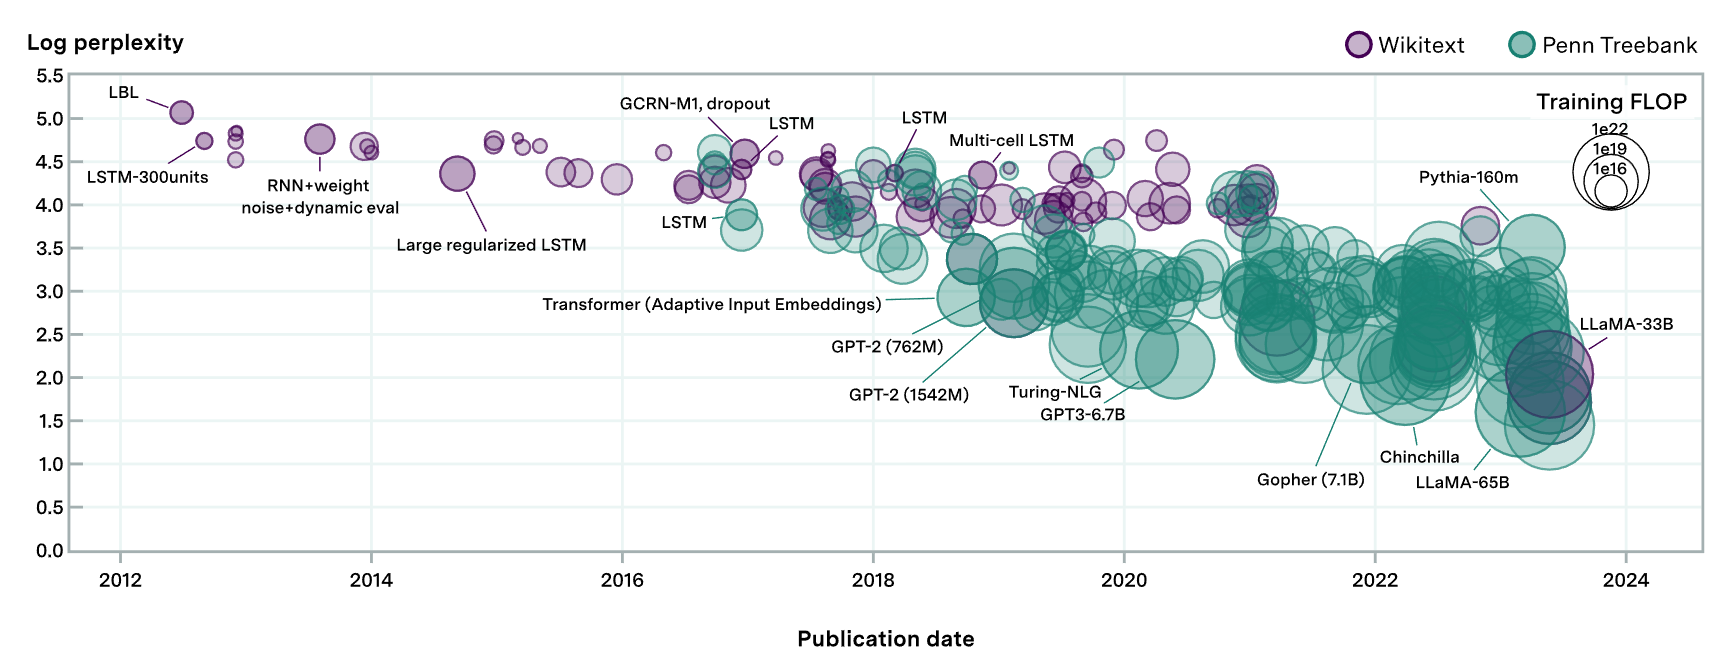
언어 모델 크기에 따른 성능 향상
- 가로축은 출판 연도, 원의 크기는 학습에 사용된 계산량
- 세로축은 로그 혼란도
- 낮을수록 좋음
- 더 많은 학습이 이뤄질수록 로그 혼란도가 감소하고 있음
퀴즈
스케일링 법칙을 설명한 것으로 가장 알맞은 것은?
퀴즈를 풀려면 대화형 기능을 불러와야 합니다.