추론 전략
문제 분해, 검증, 후보 탐색, 프로그램 실행을 활용하는 추론 전략을 살펴본다.
복잡한 문제를 해결하는 전략에는 하위 문제로 분해하기, 사실을 검증하기, 여러 풀이 후보를 비교하기, 중간 경로를 탐색하기, 계산을 프로그램에 맡기기 등이 있음.
문제 분해
- 문제 분해: 복잡한 문제를 답할 수 있는 작은 하위 문제로 나누고, 앞에서 구한 결과를 다음 문제에 활용하는 방법
- 나누는 기준: 최종 답을 구하려면 어떤 정보와 중간 결과가 필요한지 확인
- 수행 순서: 서로 의존하는 하위 문제의 순서를 정하고, 각 단계에서 확인할 결과를 명시
- 긴 작업도 분해하면 단계마다 중간 결과를 확인하고 다음 지시를 조정할 수 있음
- 쉬운 문제부터 풀기(least-to-most prompting): 문제를 더 쉬운 하위 문제로 분해한 뒤, 앞의 답을 활용해 차례로 해결하는 프롬프팅 전략
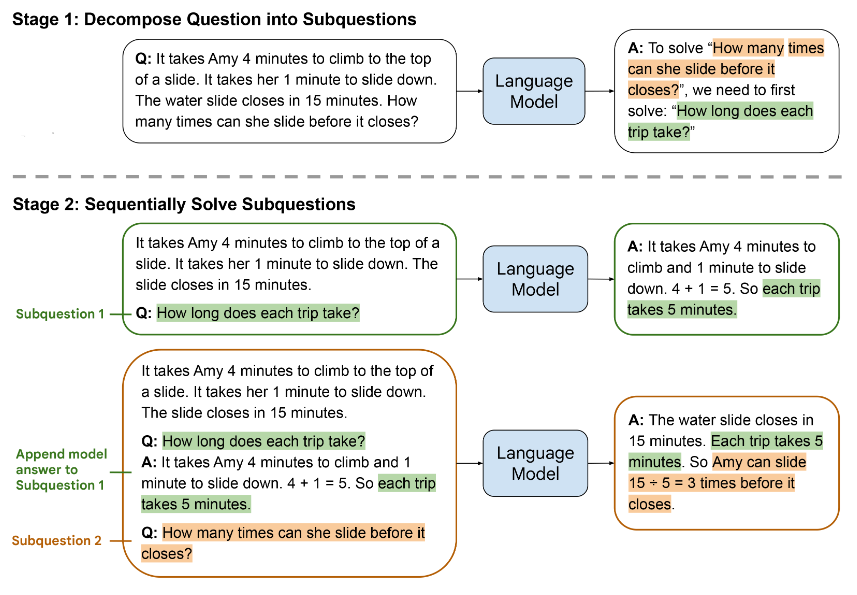
출처: Zhou 외, Least-to-Most Prompting Enables Complex Reasoning in Large Language Models, 그림 1.
- 위쪽 1단계: 미끄럼틀을 몇 번 탈 수 있는지 구하기 위해 ‘한 번 타는 데 걸리는 시간’을 하위 질문으로 분리
- 아래쪽 2단계: 올라가는 4분과 내려오는 1분을 합쳐 5분을 구하고, 이 답을 다음 입력에 포함해 15/5=3회로 계산
- 핵심: 하위 문제를 나열하는 데서 끝내지 않고, 앞에서 얻은 답을 다음 문제의 정보로 사용
계획 후 실행: Plan-and-Solve
- 계획 후 실행(Plan-and-Solve, PS): 문제를 풀 계획을 먼저 세우고, 그 계획에 따라 하위 작업을 수행하도록 지시하는 방법
- 계획: 답에 필요한 중간 결과와 수행 순서를 먼저 정리
- 실행: 정한 순서대로 중간 결과를 구하고 최종 답을 도출
- Wang 외(2023)는 제로샷 CoT에서 필요한 풀이 단계가 누락되는 문제를 줄이기 위해 제안
- 지시 예: “먼저 문제를 이해하고 해결 계획을 세워라. 그다음 계획에 따라 문제를 단계적으로 풀어라.”
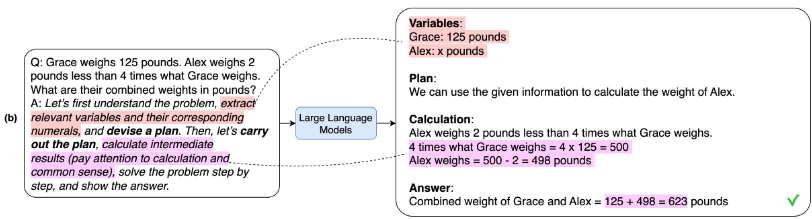
출처: Wang 외(2023), Plan-and-Solve Prompting: Improving Zero-Shot Chain-of-Thought Reasoning by Large Language Models, 그림 3(b). CC BY 4.0.
- 그림은 PS에 변수 추출과 중간 계산 지시를 추가한 PS+ 예시
- 조건: Grace의 몸무게는 125파운드, Alex는 Grace의 4배보다 2파운드 적음
- 계획: Alex의 몸무게를 구한 뒤 두 사람의 몸무게를 합산
- 실행: 125×4−2=498, 이어서 125+498=623파운드
- Least-to-Most는 쉬운 하위 질문의 답을 다음 질문에 전달하는 절차에 초점. PS는 전체 풀이의 계획을 먼저 드러내고 그 순서대로 수행하도록 지시
결과 검증
검증의 연쇄(chain-of-verification, CoVe)는 초안에 포함된 사실을 확인할 질문으로 바꾸고, 그 답을 이용해 초안을 수정하는 방법.
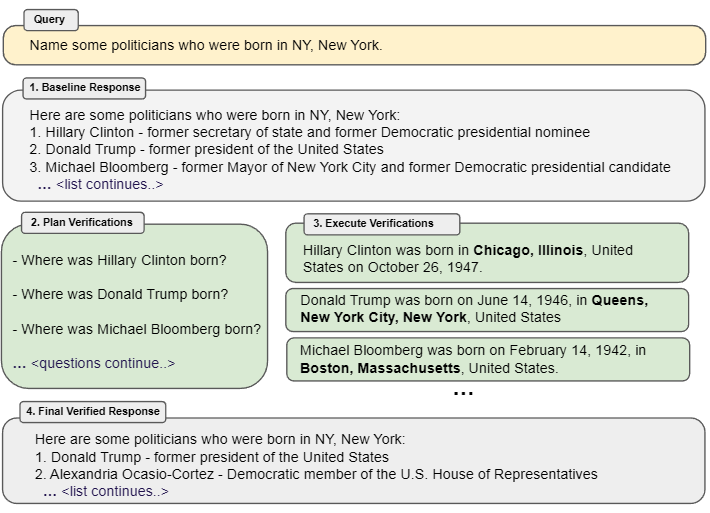
출처: Dhuliawala 외(2023), Chain-of-Verification Reduces Hallucination in Large Language Models, 그림 1.
- 초안 생성: 사용자의 요청에 대한 첫 답변 작성(예: 뉴욕에서 태어난 정치인으로 힐러리 클린턴·도널드 트럼프·마이클 블룸버그를 제시)
- 검증 질문 작성: 답변의 사실 주장을 따로 확인할 질문으로 분리(예: 힐러리 클린턴은 어디에서 태어났는가?)
- 질문별 답변: 초안을 보지 않고 각 질문에 따로 답한 뒤 초안의 주장과 대조(예: 힐러리 클린턴은 일리노이주 시카고에서 태어났다)
- 초안과 분리해 답해야 초안의 오류를 그대로 따라 하지 않음
- 최종 답변 수정: 확인 결과를 반영해 잘못된 항목을 제거하거나 수정(예: 클린턴·블룸버그를 제외하고 뉴욕 출생인 트럼프는 유지)
자기 일관성
자기 일관성(self-consistency): 서로 다른 풀이 후보를 생성한 뒤, 최종 답이 가장 많이 일치하는 값을 선택하는 방법. 한 번 생성한 풀이에만 의존하는 대신 여러 경로의 답을 모아 판단.
- 같은 문제에 대해 후보 풀이를 여러 번 생성
- 샘플링을 통해 서로 다른 풀이 경로를 확보
- 각 후보에서 최종 답을 추출
- 풀이의 문장이 달라도 최종 답이 같으면 같은 답으로 집계
- 가장 많이 나온 최종 답을 선택
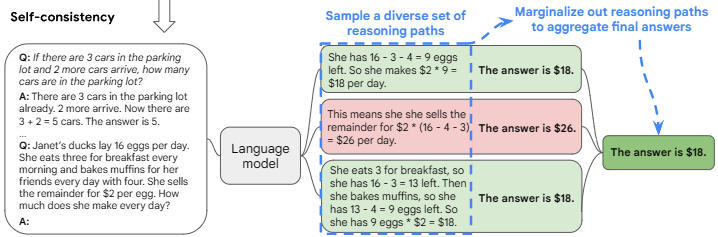
출처: Wang 외, Self-Consistency Improves Chain of Thought Reasoning in Language Models, 그림 1. CC BY 4.0.
- 그림 설명:
- 왼쪽: 시범 풀이와 새로 풀 문제를 모델에 전달
- 오른쪽: 새 문제에 대한 후보 풀이 세 개가 각각 18·26·18달러에 도달. 서로 다른 두 경로가 같은 18달러에 도달하므로 최종 답으로 선택
- 가장 긴 풀이를 고르거나, 같은 풀이를 여러 번 복사하는 방식과 구분
- 후보를 더 생성할수록 호출·토큰 비용 증가. 후보들이 같은 조건을 놓칠 수도 있으므로, 선택한 답이 원래 문제의 조건에 맞는지 확인
생각의 트리: Tree of Thoughts
- 생각의 트리(Tree of Thoughts, ToT): 풀이의 중간 단계마다 여러 후보를 만들고, 평가 결과에 따라 다음 경로를 탐색하는 방법. Yao 외(2023)가 제안
- 트리의 노드: 하나의 중간 풀이 상태. 예를 들어 수식의 중간 계산 결과, 글의 개요, 낱말 퍼즐의 부분 답안
- 가지: 현재 상태에서 이어 갈 수 있는 다음 단계의 후보
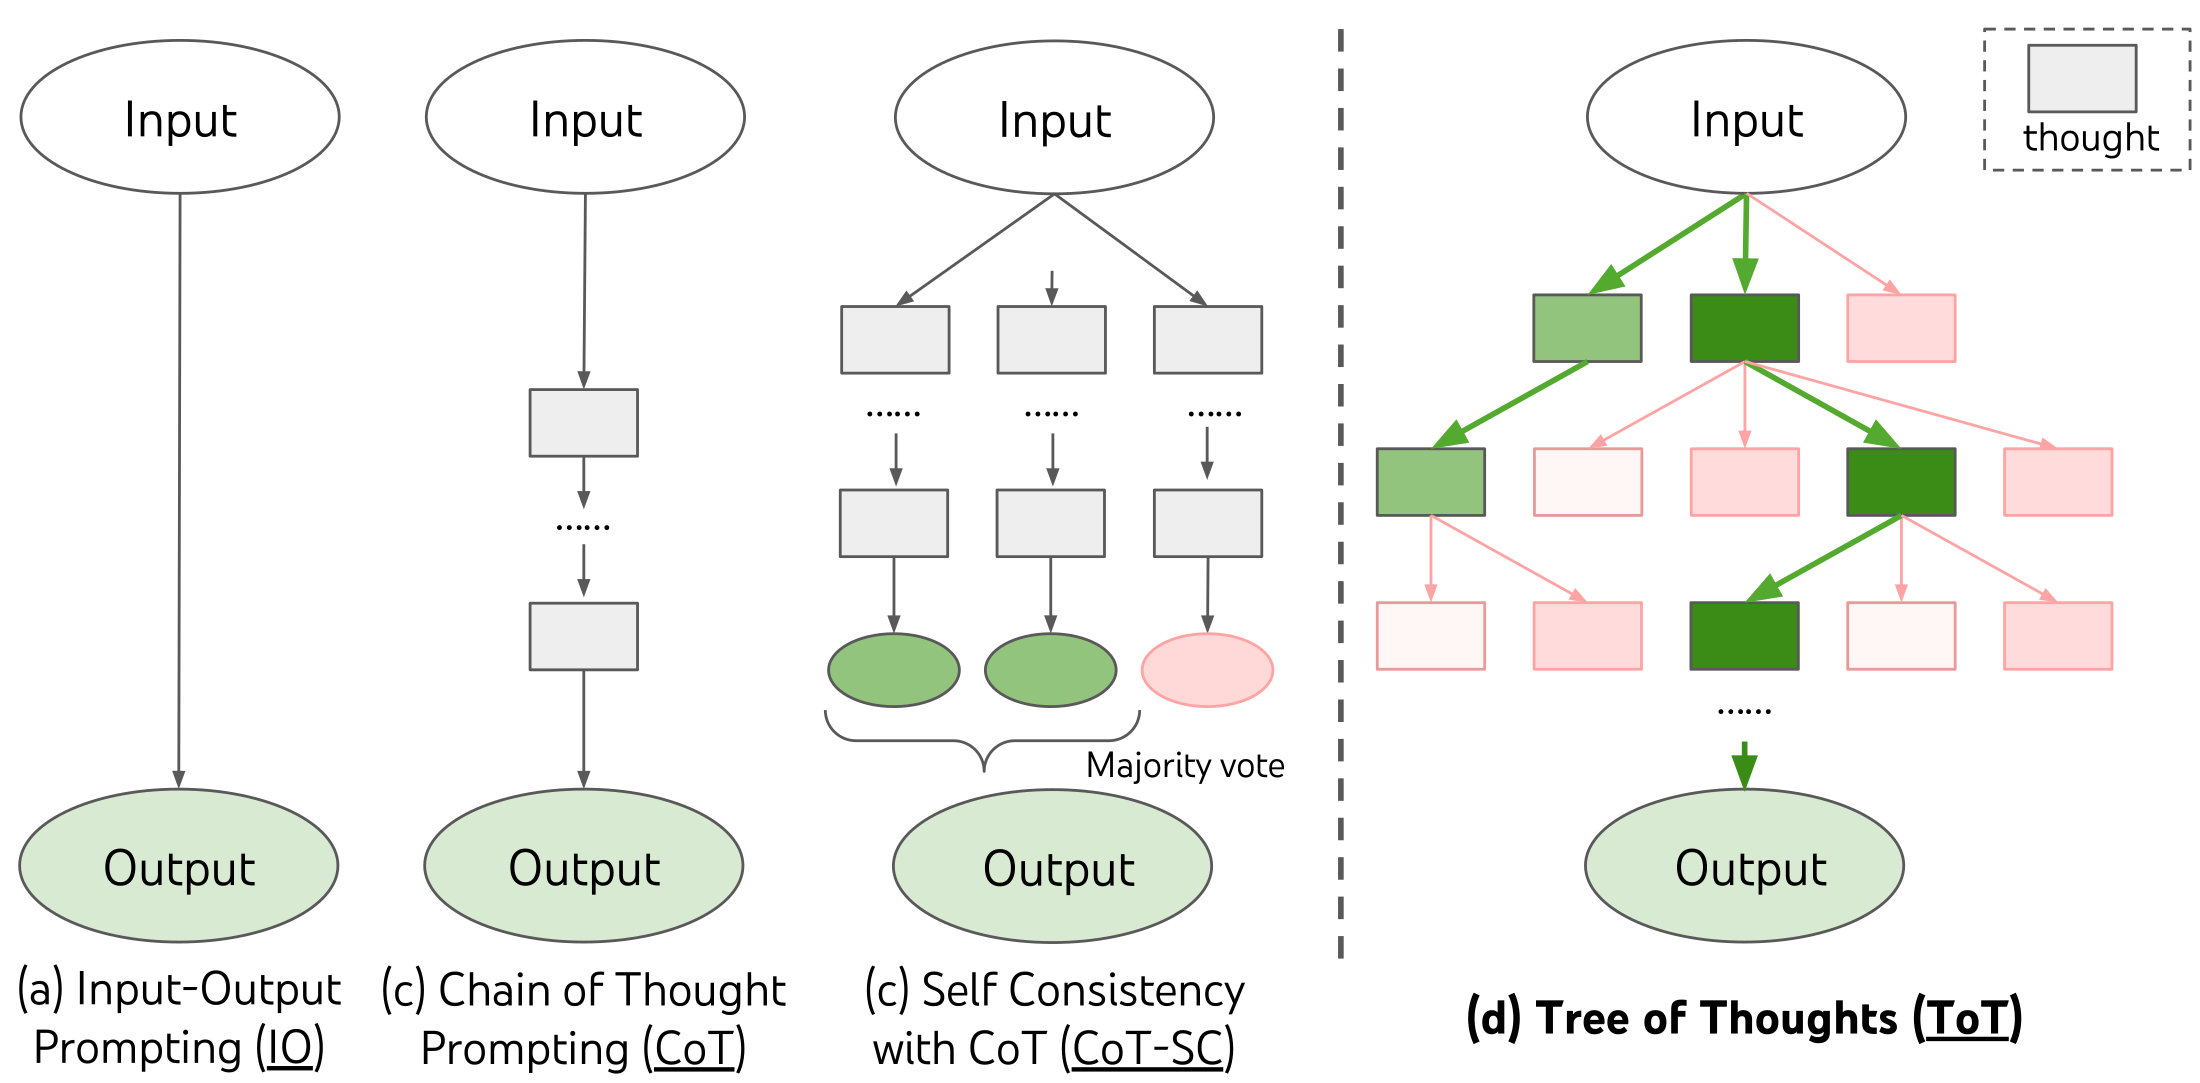
출처: Yao 외(2023), Tree of Thoughts: Deliberate Problem Solving with Large Language Models, 그림 1. CC BY 4.0.
- 후보 생성: 현재 상태에서 가능한 다음 풀이 단계를 여러 개 생성
- 후보 평가: 각 후보가 문제의 조건을 만족하고 정답에 도달할 가능성이 있는지 모델로 평가
- 탐색: 유망한 후보를 확장하고, 막힌 경로에서는 이전 상태로 돌아가 다른 후보를 선택
- 그림:
- 왼쪽: 직접 답하기, 한 경로로 풀기, 여러 경로를 끝까지 푼 뒤 최종 답을 집계하는 자기 일관성
- 오른쪽: 중간 단계의 후보를 평가해 계속 탐색할 가지를 선택. 초록색은 이어 가는 경로, 붉은색은 탈락한 경로
- 구현: 모델의 후보 생성·평가 호출과 너비 우선 탐색(BFS)·깊이 우선 탐색(DFS) 같은 탐색 알고리즘을 결합. 프로그램이 후보 상태와 평가 결과를 저장하고 다음 호출을 결정
- 활용: 초반 선택이 이후 풀이를 크게 바꾸는 퍼즐, 제약 조건이 있는 계획 수립 등. 후보 수와 탐색 깊이를 늘리면 모델 호출과 계산 비용도 증가
프로그램으로 풀기: Program of Thoughts
- 프로그램으로 풀기(Program of Thoughts, PoT): 언어 모델이 문제를 프로그램으로 표현하고, 외부 실행기가 계산을 수행하는 방법. Chen 외(2022)가 제안
- 언어 모델: 문제의 조건을 해석하고 변수·수식·반복문 등을 작성
- 실행기: 생성된 프로그램을 실행해 계산 결과를 반환
- 최종 답: 실행 결과를 사용해 질문에 답변
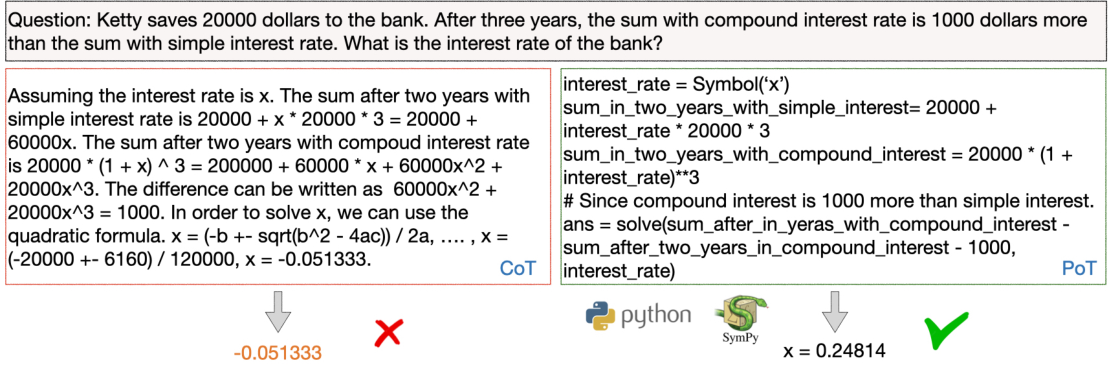
출처: Chen 외(2022), Program of Thoughts Prompting: Disentangling Computation from Reasoning for Numerical Reasoning Tasks, 그림 1의 아래 부분.
- 문제: 20,000달러를 3년간 예치했을 때 복리 금액이 단리 금액보다 1,000달러 많다면 연 이자율은?
- 왼쪽 CoT: 삼차항이 있는 식을 이차방정식처럼 풀어 잘못된 답을 생성
- 오른쪽 PoT: Python으로 계산
- 역할 분담: 어떤 식을 풀지 결정하는 일은 모델이, 그 식을 계산하는 일은 실행기가 담당. 조건을 잘못 식으로 옮겼다면 코드가 실행되어도 잘못된 문제의 답을 구하게 되므로, 변수와 수식이 원래 조건을 반영하는지 확인
- 활용: 반복 계산, 표의 수치 집계, 방정식 풀이 등. 생성된 코드의 실제 실행 결과를 답에 반영하는 것이 핵심
퀴즈
문제를 쉬운 하위 문제로 나누고, 앞에서 구한 답을 다음 문제에 활용해 차례로 푸는 방법은?
퀴즈를 풀려면 대화형 기능을 불러와야 합니다.