생각의 연쇄
퓨샷·제로샷 CoT의 작동 방식과 내장 추론 기능에서의 변화를 살펴본다.
생각의 연쇄와 퓨샷 CoT
- 생각의 연쇄(chain-of-thought, CoT): 문제에서 답에 이르는 중간 풀이 단계
- CoT 프롬프팅: 중간 풀이를 생성하도록 예시나 지시를 제공하는 방법
- Wei 등의 2022년 연구: 입력·정답만 보여주던 퓨샷 예시에 중간 풀이를 추가해 계산·상식·기호 추론 과제의 성능 개선 관찰
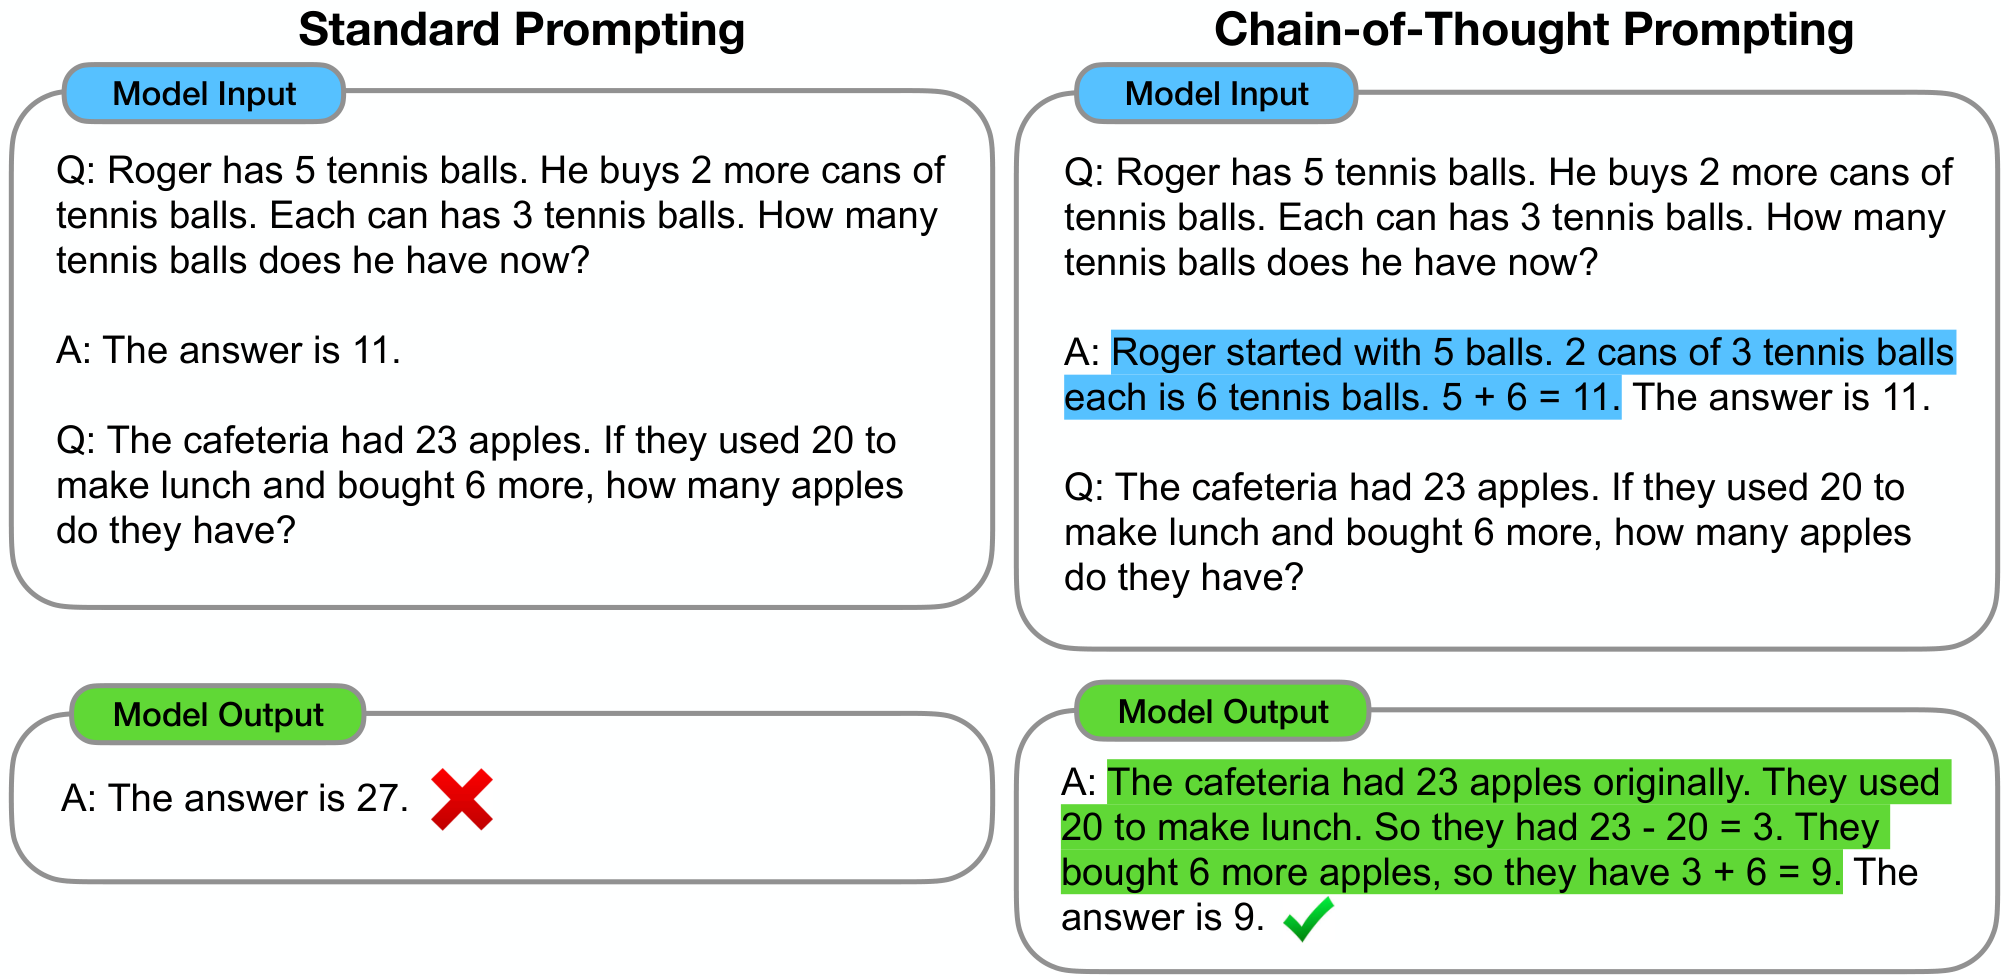
출처: Wei 외(2022), Chain-of-Thought Prompting Elicits Reasoning in Large Language Models, 그림 1. CC BY 4.0.
- 위쪽
Model Input: 테니스공 문제를 시범으로 제시한 뒤, 사과 문제의 답을 요청- 일반 퓨샷: 테니스공 문제와 정답 11만 제시
- 퓨샷 CoT: 원래 5개, 새로 산 공 2×3=6개, 합계 11개라는 풀이까지 제시
- 아래쪽
Model Output: 새 사과 문제에 대한 모델의 답변- 왼쪽: 27이라는 오답
- 오른쪽: 사과 23개에서 20개를 쓰고 6개를 샀으므로 23−20+6=9라는 풀이와 정답
예시에서 전달하는 것은 답의 형식뿐 아니라 조건을 계산 단계로 옮기는 방식. 새 문제에서도 중간 단계를 거쳐 답을 생성하도록 유도.
제로샷 CoT: Let’s think step by step
Kojima 등의 2022년 연구는 풀이 예시를 제공하는 대신, 답변의 시작에 **“Let’s think step by step”**을 넣어 추론을 유도.
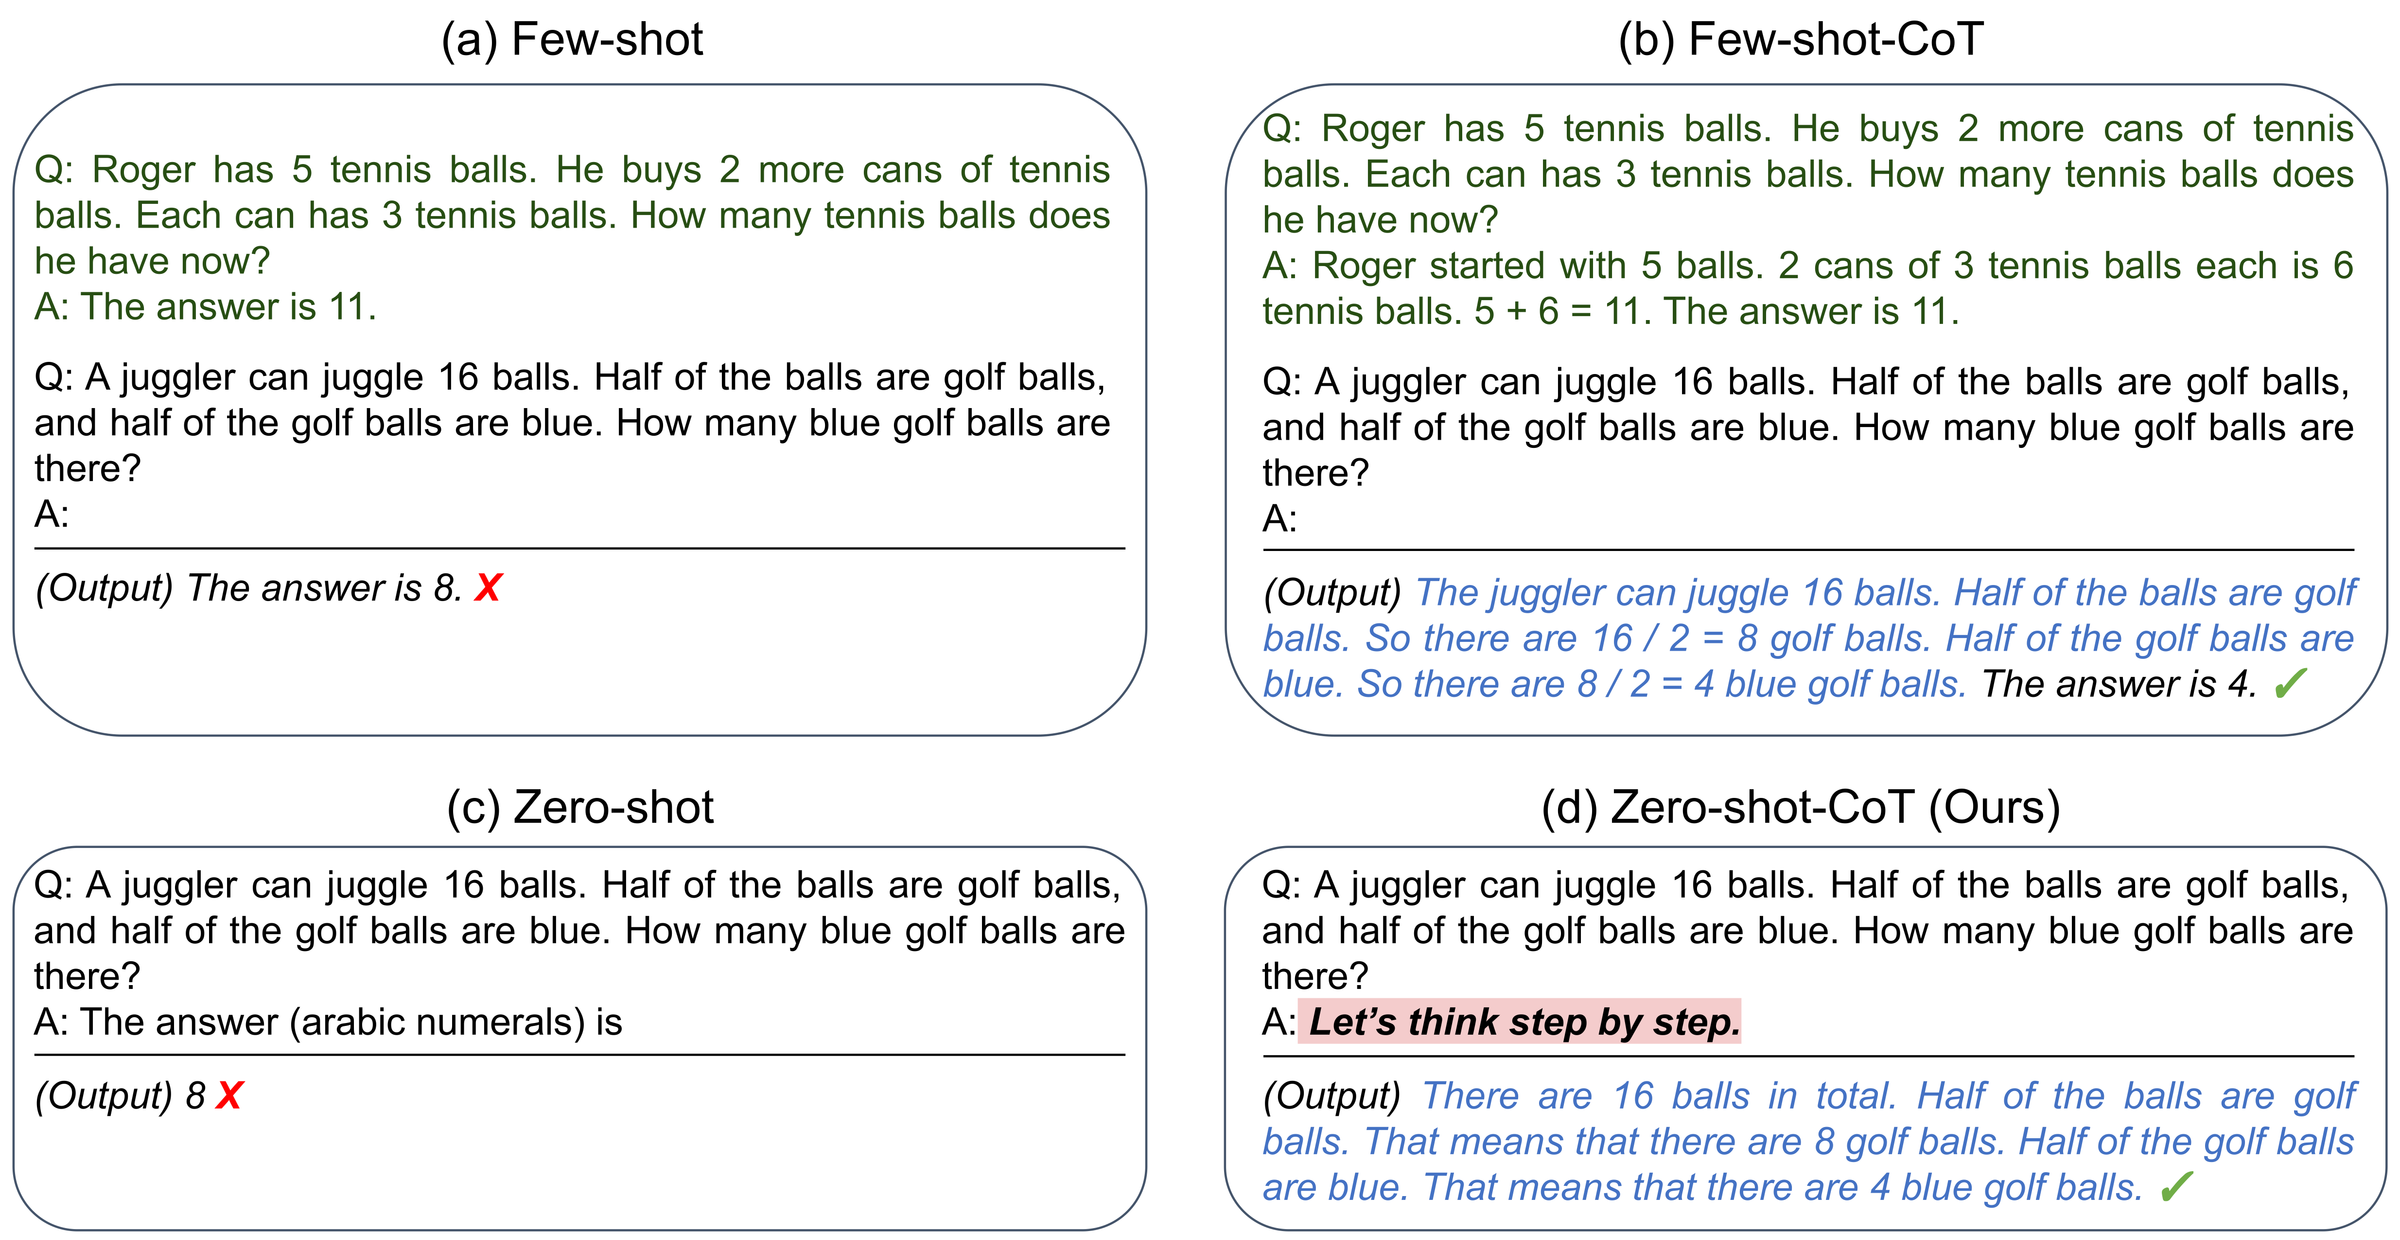
출처: Kojima 외(2022), Large Language Models are Zero-Shot Reasoners, 그림 1. 원본 SVG를 PNG로 변환.
- 공 16개 중 절반이 골프공이고, 그 골프공의 절반이 파란색인 문제
- 아래 왼쪽의 일반 제로샷: 정답만 요청해 8이라는 오답 생성
- 아래 오른쪽의 제로샷 CoT: 단계별 접근을 유도해 16/2=8, 8/2=4로 계산
- 원논문의 실험 절차: 먼저 풀이를 생성하고, 이어서 그 풀이에서 최종 답을 추출
- 당시
text-davinci-002의 MultiArith 정답률은 17.7%에서 78.7%로 상승
| 방법 | 모델에 제공하는 것 |
|---|---|
| 일반 퓨샷 | 질문과 최종 답의 예시 |
| 퓨샷 CoT | 질문·중간 풀이·최종 답의 예시 |
| 제로샷 CoT | 풀이 예시 없이 단계별 접근을 유도하는 지시 |
추론 기능이 내장된 모델
최근 추론 모델은 답변 전에 추론을 수행하도록 학습되고, 추론에 사용할 계산량도 조절할 수 있도록 제공됨. 제품에서 ‘생각하기’·‘Thinking’으로 표시되는 기능이 이 과정에 해당.
| 구분 | 추론을 유도하는 방식 | 사용자가 지정할 내용 |
|---|---|---|
| CoT 프롬프팅 | 프롬프트에 풀이 예시나 단계별 지시 추가 | 시범 풀이 또는 추론 유도 문구 |
| 내장 추론 기능 | 모델이 답변 전에 추론 수행 | 추론 모델·모드 선택, 추론 강도 설정 |
추론 기능이 작동하는 모델에는 별도의 CoT 프롬프팅을 기본으로 추가할 필요가 없음. 문제와 자료, 충족해야 할 조건을 명확하게 전달하는 데 집중.
- OpenAI 추론 모델: 내부적으로 추론하므로 “think step by step” 같은 지시가 불필요하다고 안내
- Claude: thinking이 켜진 상태에서는 내장 기능을 활용. thinking이 꺼진 상태에서는 수동 CoT 지시를 대안으로 사용 가능
- Gemini: thinking 모델이 답변 전에 내부적으로 추론. 모델에 따라 기본 활성화 여부와 추론 강도 설정이 다름
출처: OpenAI 추론 모델 지침, Claude thinking 지침, Gemini thinking.
사용자에게 보여줄 설명은 필요한 형태로 별도 요청. 예를 들어 “결론과 핵심 근거를 세 항목으로 정리해라”는 결과의 설명 형식을 정하는 지시.
ReasonLab: 내장 추론에 CoT 지시를 더했을 때
Preet 등의 ReasonLab: A Controlled and Auditable Evaluation of Prompting Techniques for Multiple-Choice QA(2026)는 객관식 문항에서 프롬프팅 기법 8개를 비교한 연구.
- 실험 구성: 데이터셋 10개, 모델 구성 27개, 총 480,927회 평가
- 비교 기법: 직접 질문, 단계별 풀이 요청, 전문가 역할을 더한 풀이 요청, 계획 후 풀이, 질문 반복, 관련 예시·배경의 자체 생성 등
- 비교 방법: 같은 모델·문항에 각 기법을 적용하고 정답 추출 방법을 통일
- Group A — 그림 위쪽 (a, b): 내장 추론 기능을 사용하지 않는 모델 구성 8개. 프롬프트로 추론을 유도했을 때의 효과 비교
- Group B — 그림 아래쪽 (c, d): 내장 추론 기능을 사용하는 GPT-OSS·Qwen3의 모델 구성 4개. 이미 추론하는 모델에 CoT 지시를 추가했을 때의 효과 비교
각 그룹 안에서 프롬프팅 기법을 비교한 실험. 두 그룹은 서로 다른 모델로 구성되어 있으므로, 그룹 간 평균 정답률 차이는 추론 기능만의 효과를 나타내지 않음.
주요 결과는 모델이 이미 추론하는지에 따라 추가 지시의 효과가 달라진다는 것.
- 추론 기능을 사용하지 않는 구성: 단계별 풀이·귀납적 풀이·전문가 역할·계획 후 풀이·관련 예시 자체 생성 기법이 직접 질문보다 약 3.9~4.7%p 높은 정답률. 이 기법들 사이의 차이는 통계적으로 유의하지 않음
- 질문 반복과 배경 문서 자체 생성은 직접 질문보다 오히려 낮은 정답률
- 추론 기능을 사용하는 구성: 직접 질문의 평균 정답률은 70.84%. 단계별 풀이 요청은 70.69%, 계획 후 풀이는 70.32%로, 추가 지시의 유의한 개선 효과가 관찰되지 않음
- 배경 문서를 모델이 먼저 생성한 뒤 답하게 하는 기법은 추론 기능을 사용하는 구성에서 정답률이 2.95%p 하락
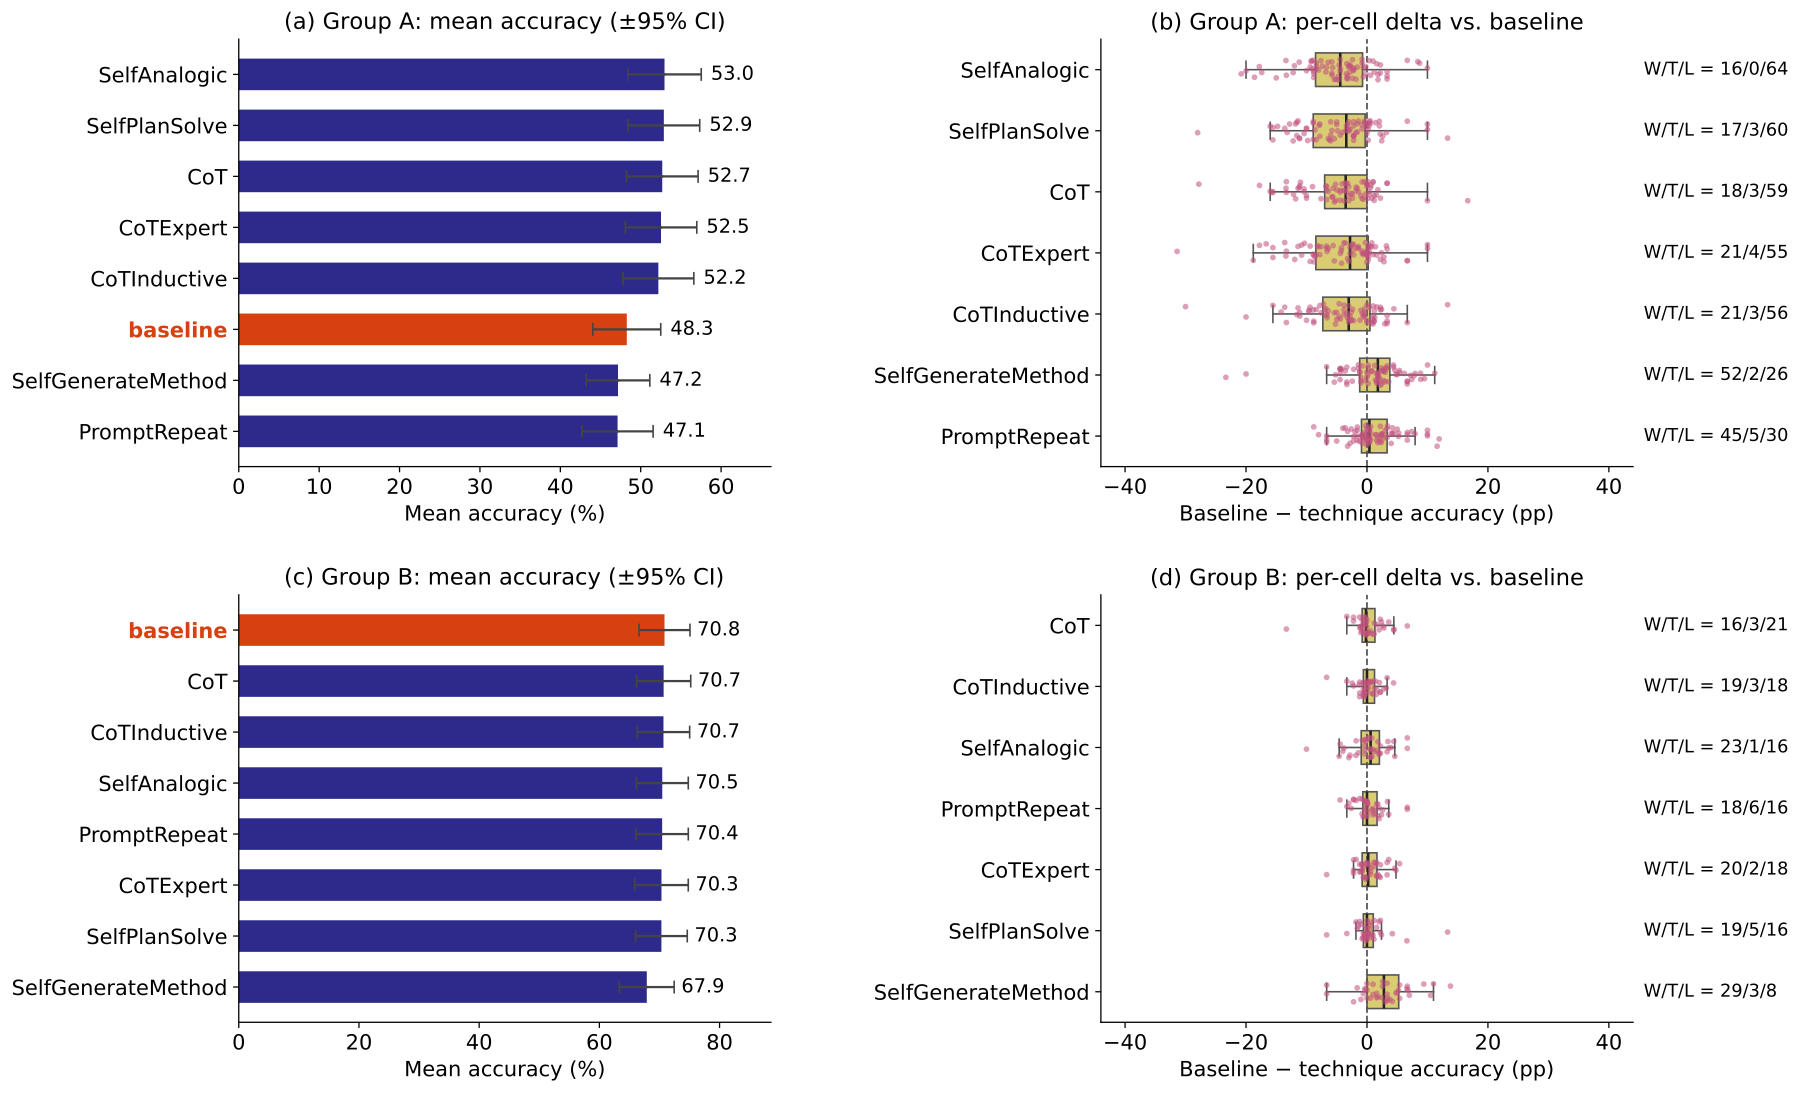
출처: Preet 외, ReasonLab, 그림 3. CC BY 4.0, 원본 SVG를 PNG로 변환.
- 왼쪽 패널: 기법별 평균 정답률과 95% 신뢰구간. 주황색은 직접 질문인
baseline - 오른쪽 패널: ‘직접 질문 정답률 − 해당 기법 정답률’의 분포. 0보다 왼쪽이면 해당 기법이 유리
- 아래쪽 패널에서는 대부분의 차이가 0 근처에 모임. 이미 추론하는 모델에 풀이 방식이나 역할을 더 지정하는 효과가 작았다는 결과
퀴즈
퓨샷 CoT가 일반 퓨샷 예시에 추가하는 것은?
퀴즈를 풀려면 대화형 기능을 불러와야 합니다.