합성 데이터와 모형 붕괴
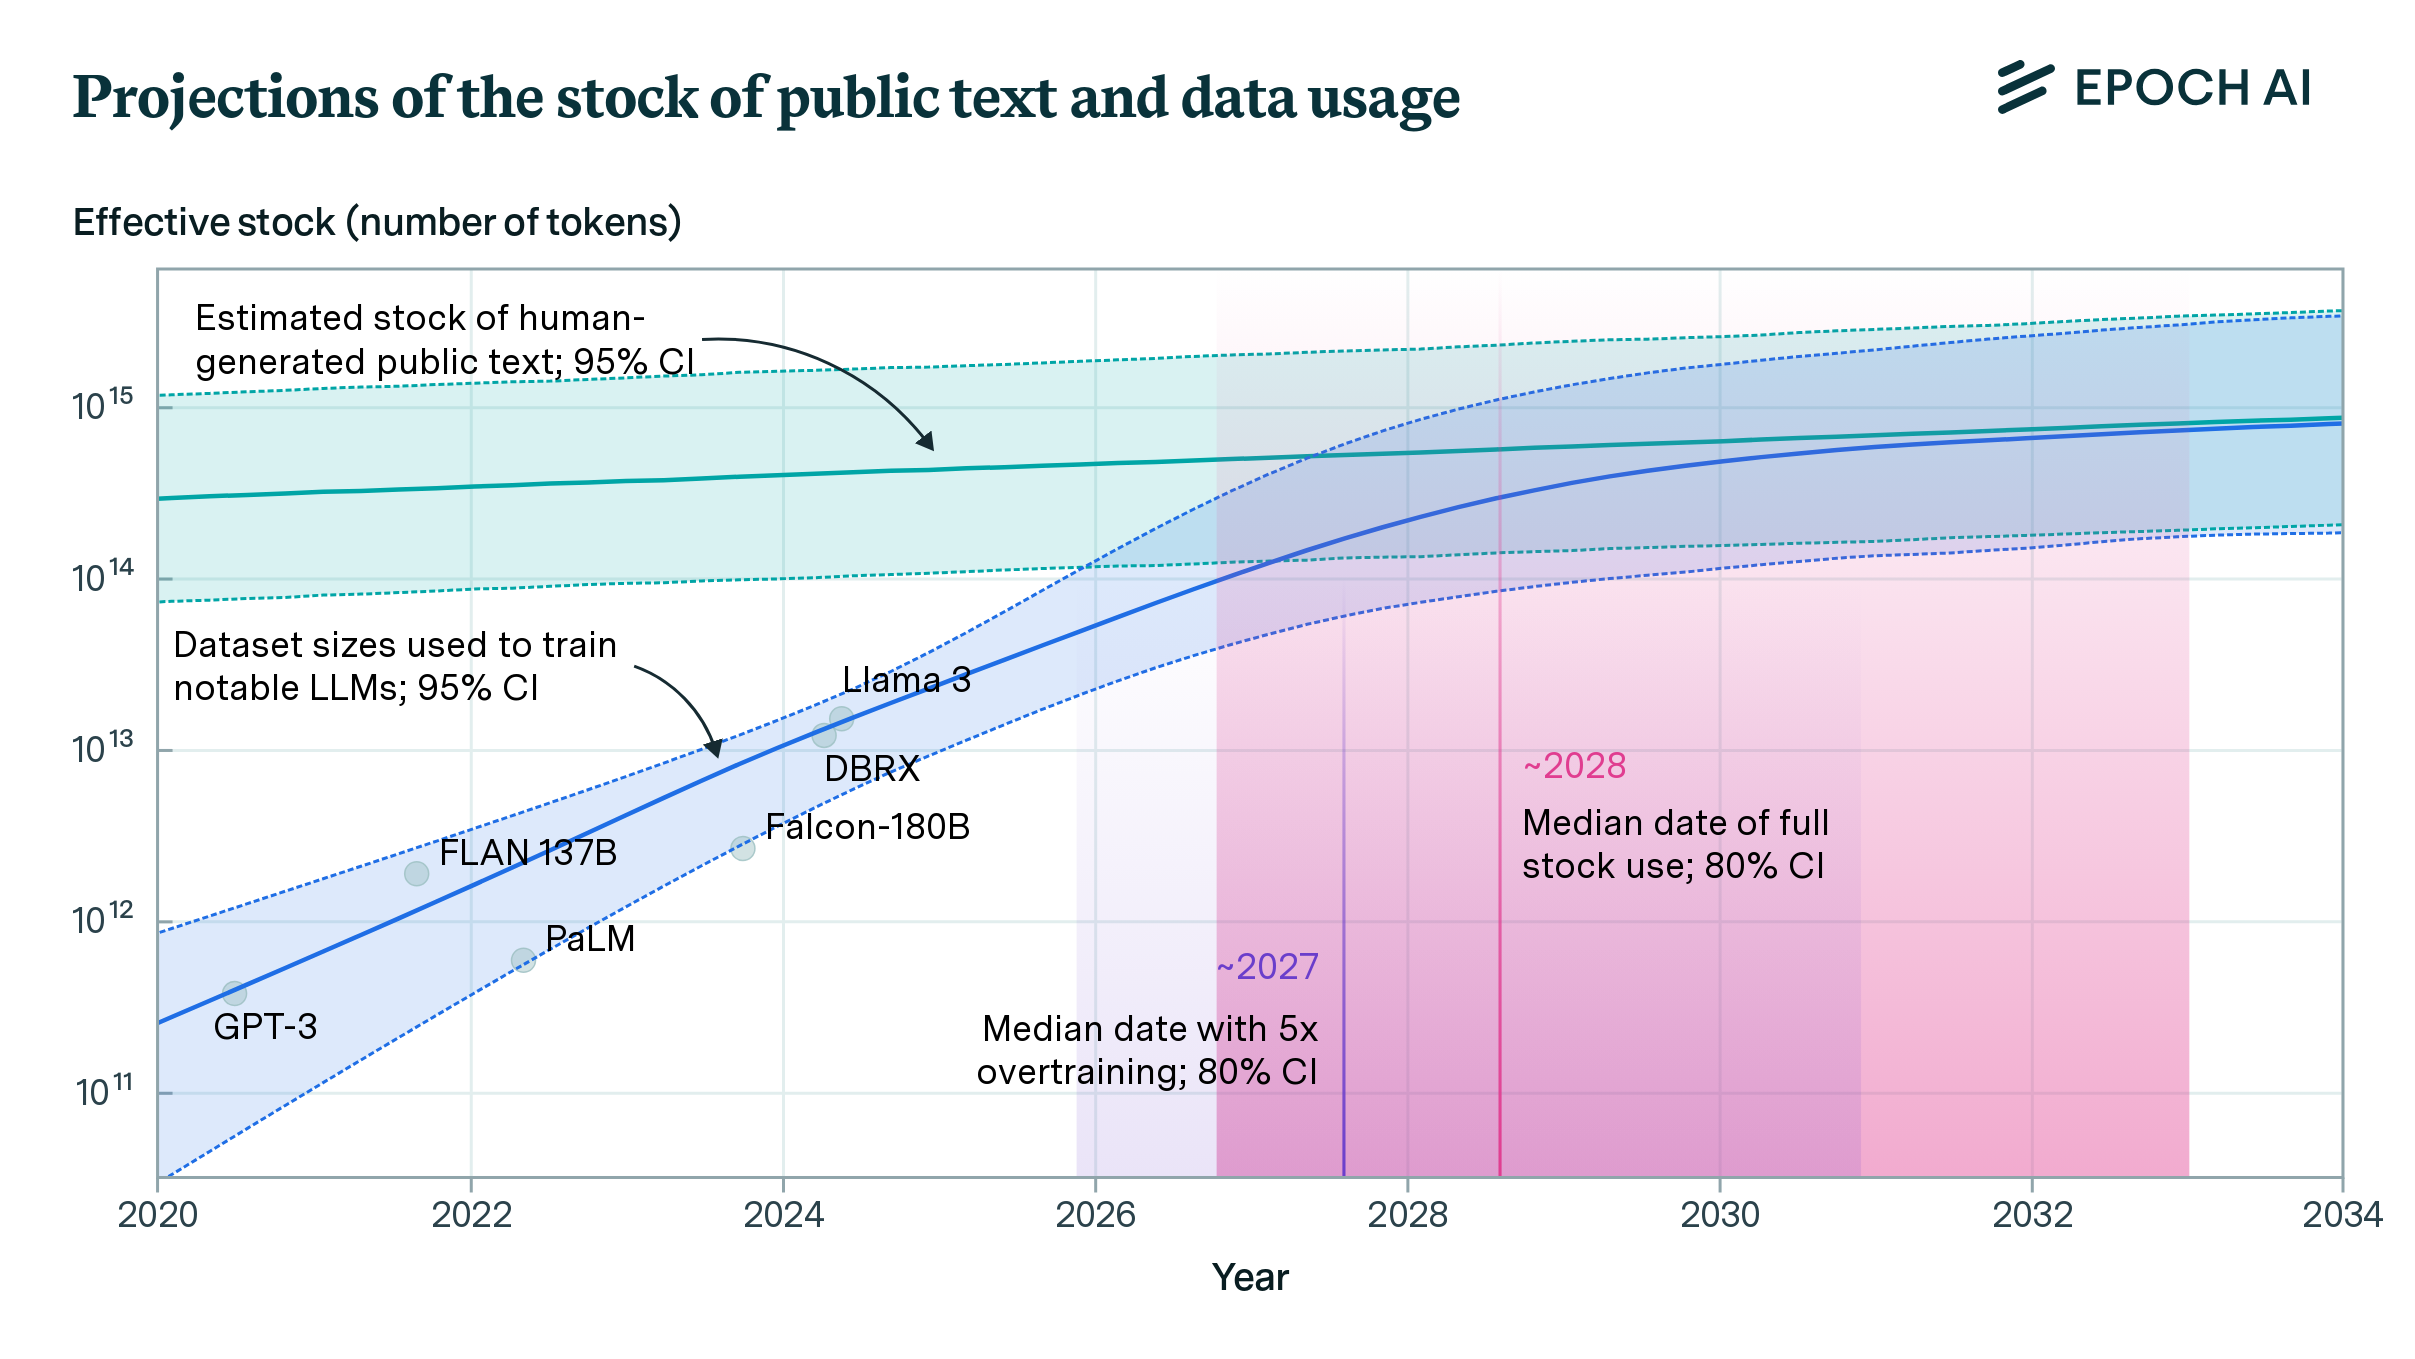
공개 데이터의 고갈
합성 데이터
-
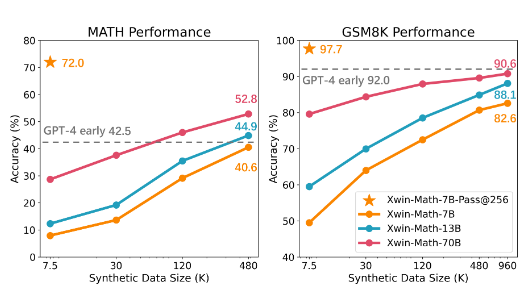
LLM은 수학 등 논리적 추리에 약점 → 양질의 데이터가 부족
-
GPT-4를 이용해 생성한 데이터를 더 작은 모형에 학습 → GPT-4와 비슷한 성능을 냄
-
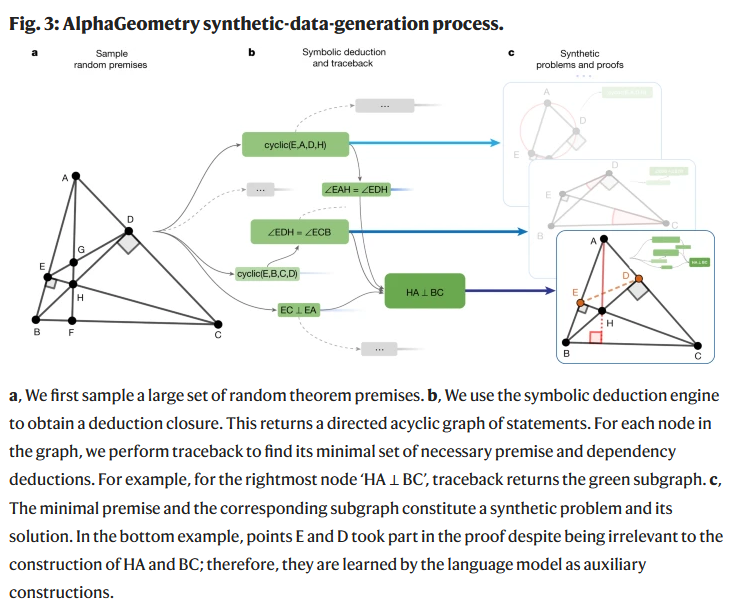
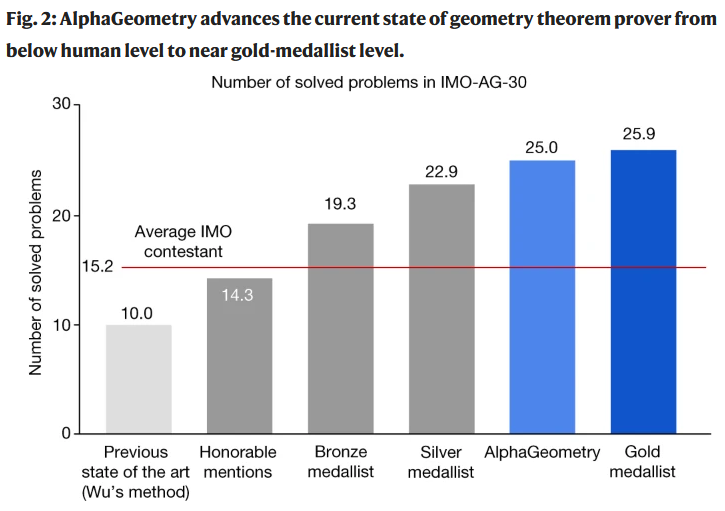
딥마인드의 알파지오메트리: 기존 수학 문제를 변형하는 방법을 사용, 올림피아드 금메달 수준 달성
모형 붕괴
- AI models collapse when trained on recursively generated data
- 모형에서 생성한 데이터를 다시 모형에 입력
- 원래 데이터의 분포와 다른 분포로 수렴
- 분산의 감소
- 원인:
- 생성된 데이터의 크기가 유한하여 확률이 낮은 사례가 누락
- 모형이 표현하지 못하는 정보가 상실
- 학습 과정에서 오류
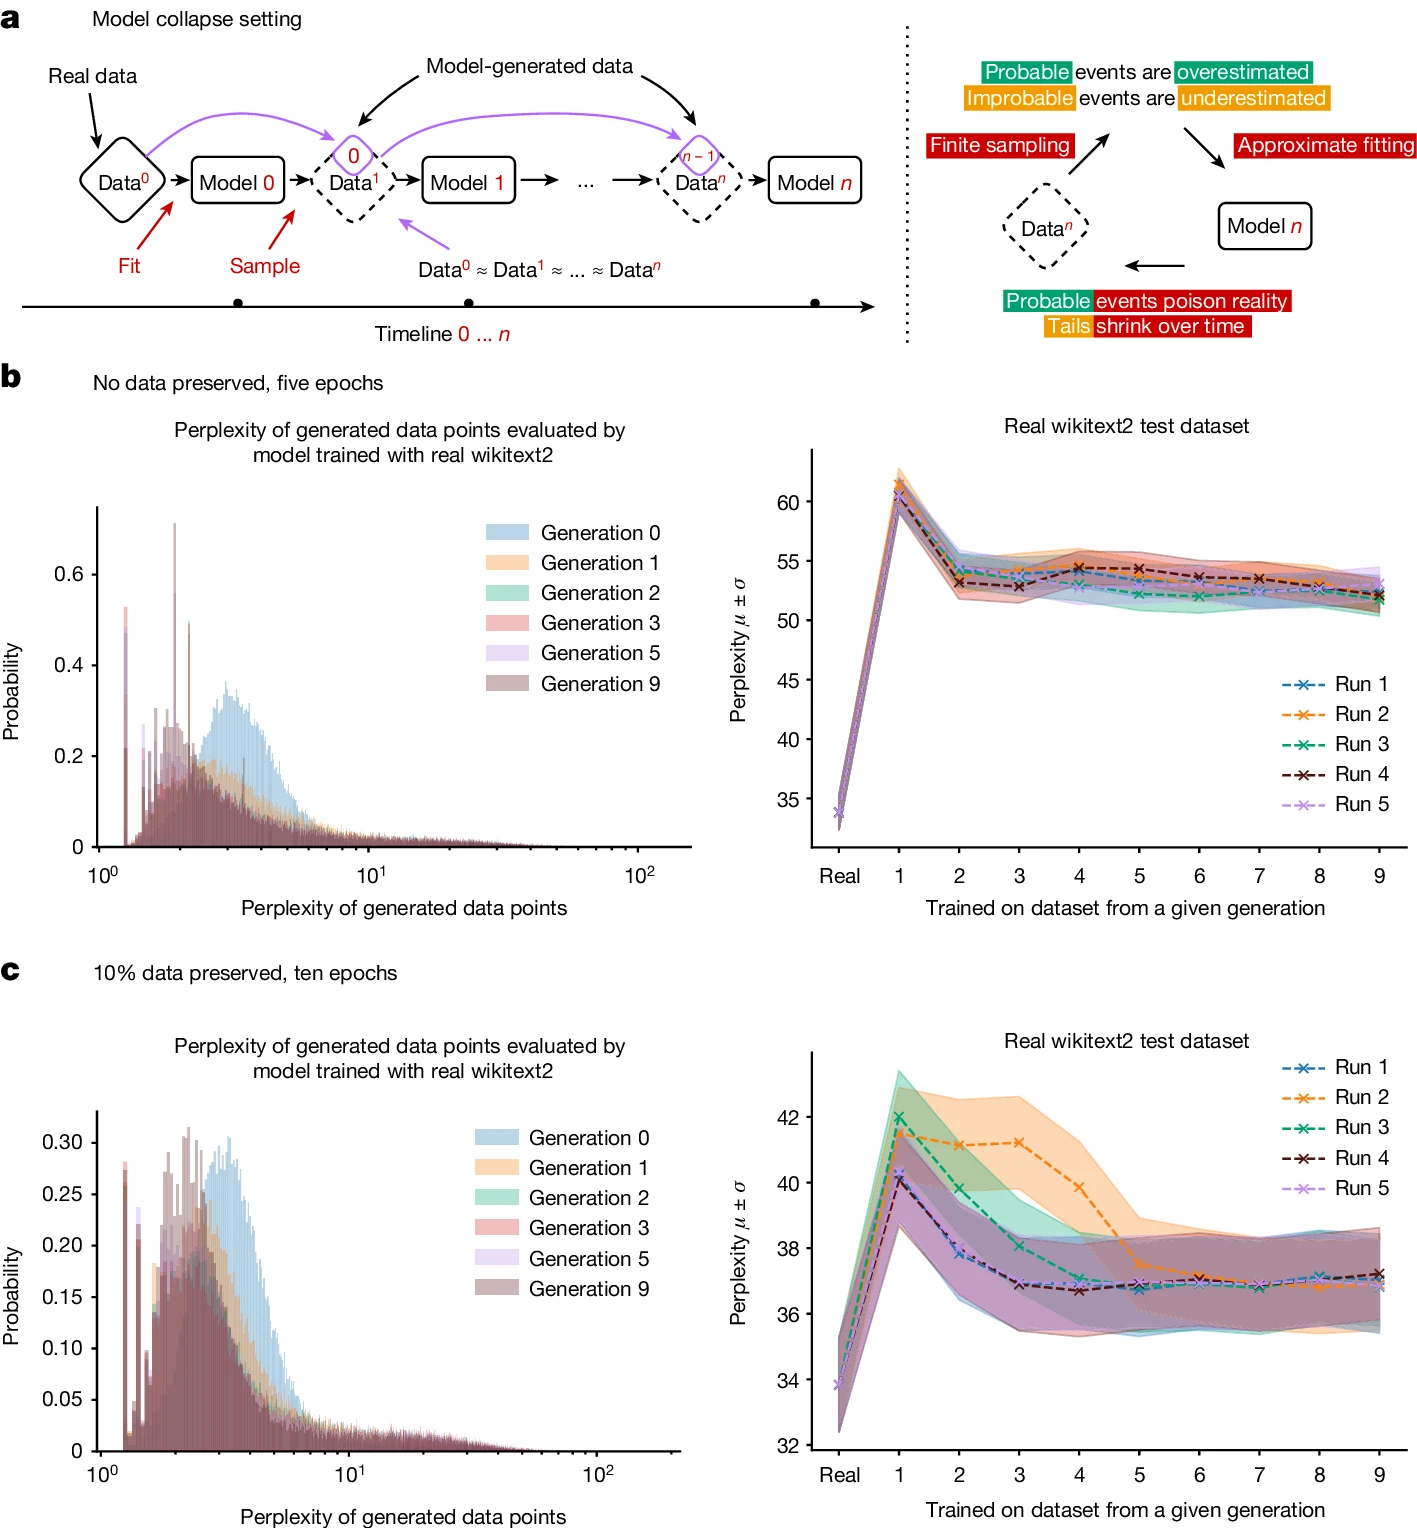
그림 설명:
- [b좌] 세대가 거듭할수록 생성되는 데이터의 혼란도(perplexity)가 낮아짐
- 뻔한 문장만 생성
- [b우] 모형을 기준으로 실제 데이터의 혼란도가 높아짐
- 실제 문장을 낯설게 봄
- [c] 실제 데이터를 10% 정도 섞으면 모형 붕괴 현상이 완화
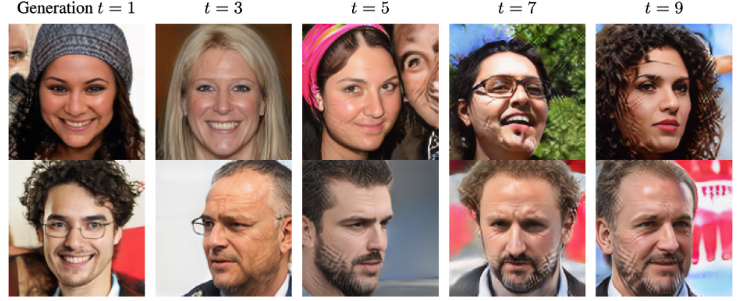
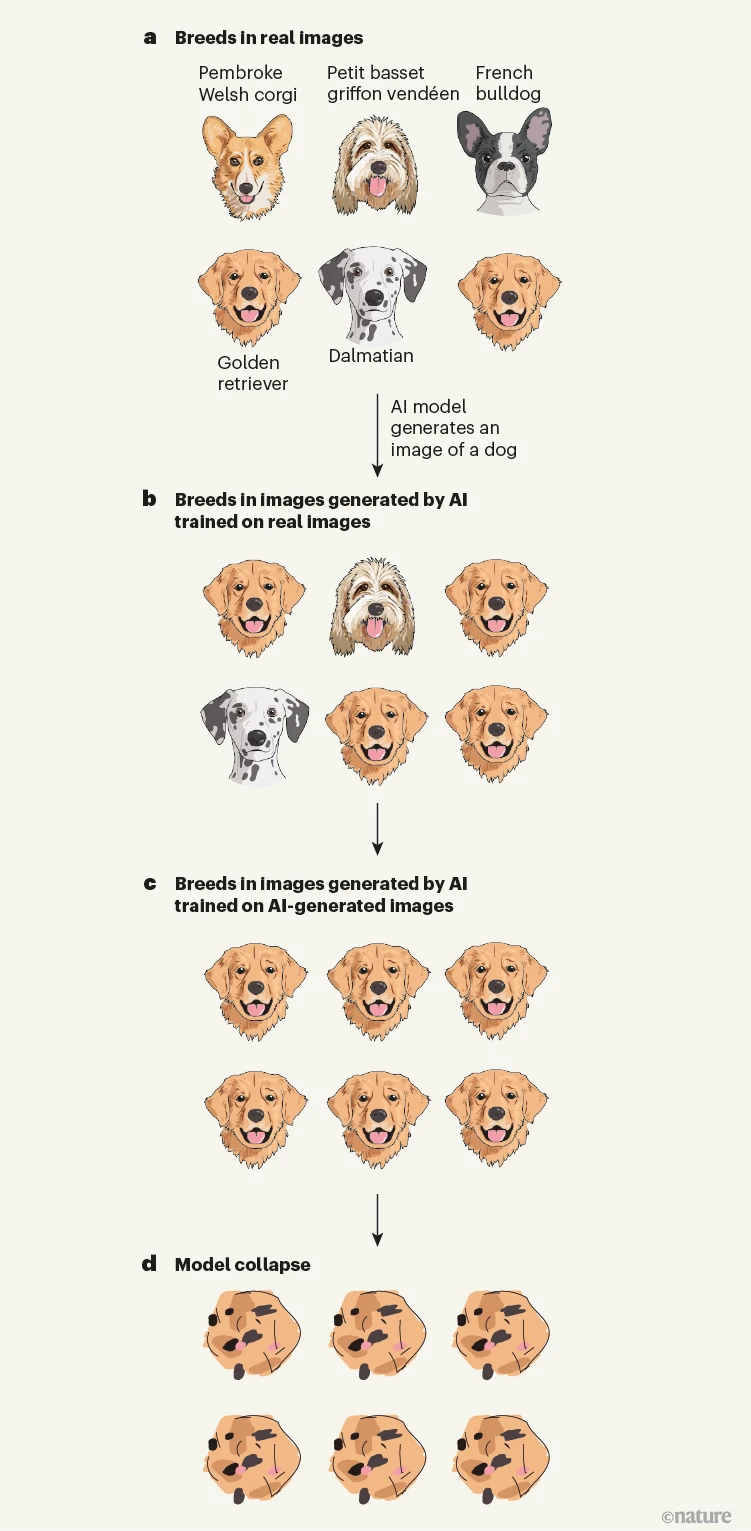
모형 붕괴 예시
모형 붕괴는 피할 수 없는가?
대체 vs. 누적
- 기존 데이터를 합성 데이터로 대체하는 경우
- 세대가 진행될수록 성능이 나빠짐
- 손실이 증가
- 기존 데이터에 합성 데이터를 누적하는 경우
- 성능이 안정되거나 개선
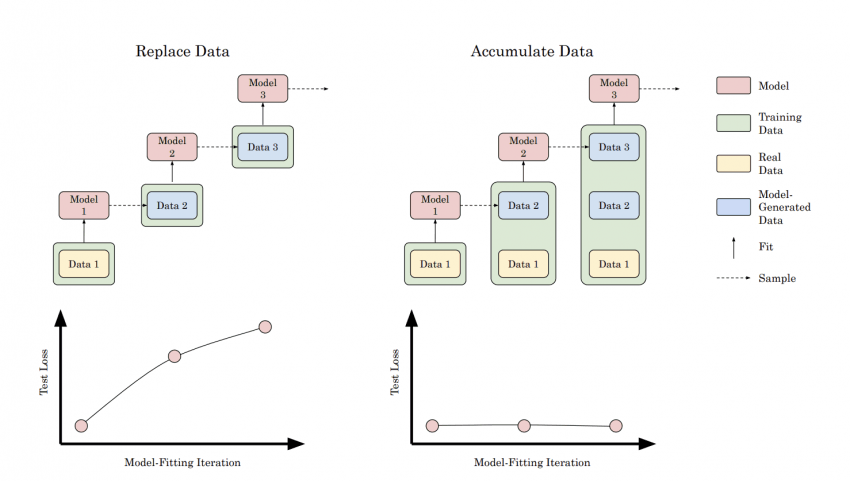
출처: Is model collapse inevitable? (https://arxiv.org/pdf/2404.01413)
퀴즈
합성 데이터를 활용하는 이유로 가장 가까운 것은?
퀴즈를 풀려면 대화형 기능을 불러와야 합니다.