창발적 능력
규모가 커질 때 갑자기 나타나는 것처럼 보이는 능력과 평가 방식의 영향
창발적 능력이란?
- 창발적 능력(emergent ability): 작은 모델에서는 관찰되지 않던 능력이 더 큰 모델에서 나타나는 현상
- 관찰의 특징: 일부 평가에서 규모가 일정 수준을 넘으면 성능이 갑자기 높아지는 것처럼 보임
- 작은 모델들의 점수만으로 더 큰 모델의 성능을 예상하기 어려운 사례
- 의미: 규모 확대가 기존 능력의 점진적 개선을 넘어 수행 가능한 과제의 범위를 넓힐 가능성
출처: Emergent Abilities of Large Language Models (Wei 외, 2022)
규모와 평가 점수의 관계
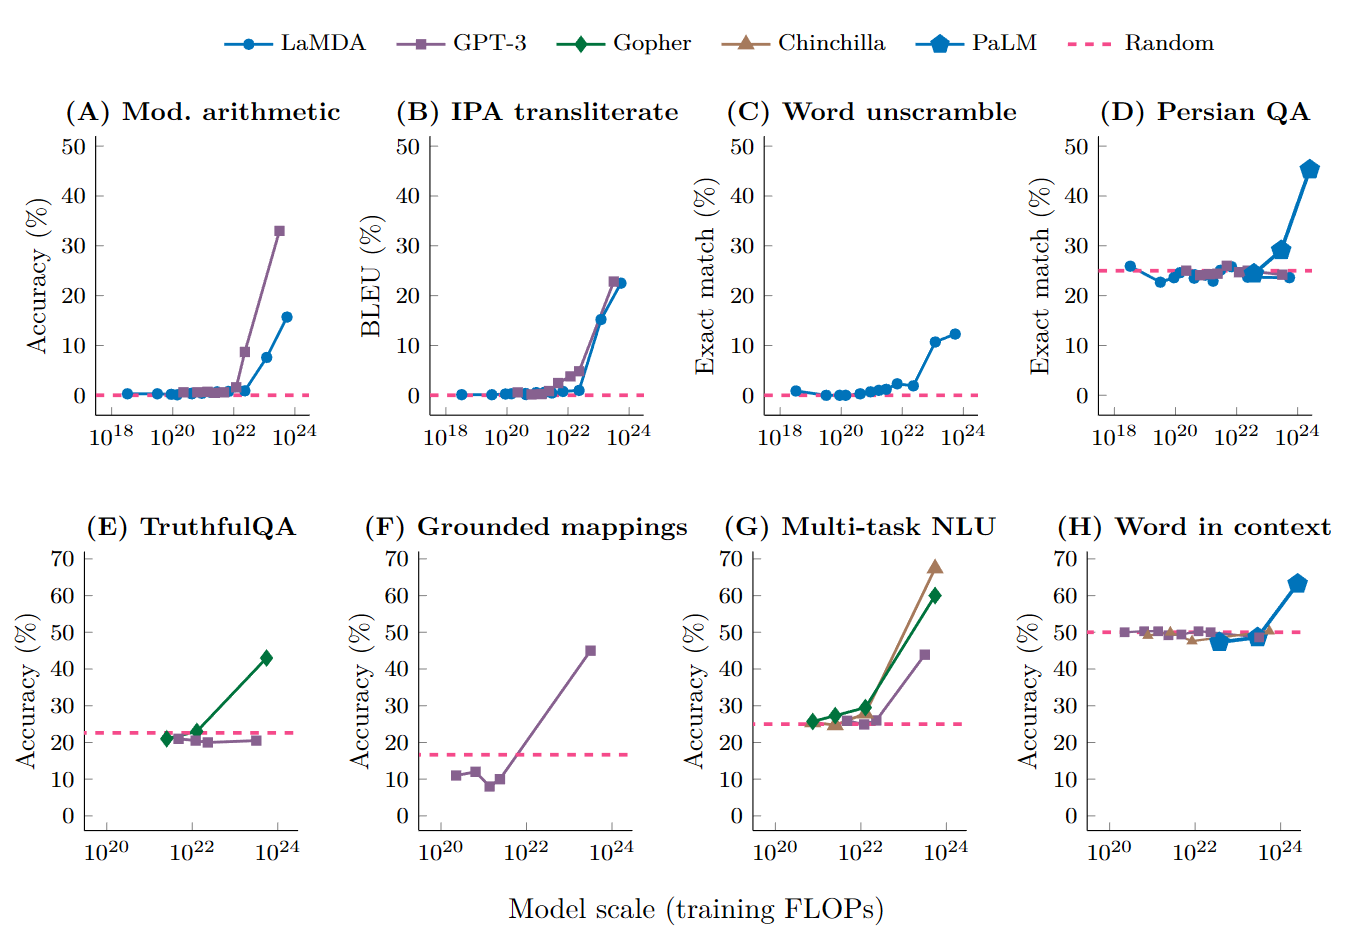
- 가로축: 모델 학습에 사용한 계산량이며 로그 눈금으로 표시
- 세로축: 과제별 정답률, 완전 일치율, BLEU 등 평가 점수
- 분홍색 점선: 무작위로 답했을 때의 기준 점수
- 그림의 과제: 창발적 능력의 사례로 선별한 8개 과제
- 관찰: 작은 규모에서는 점수가 무작위 기준 근처에 머물다가 일정 규모를 넘으면 상승
- 해석 범위: 특정 과제·모델 계열·평가 방식에서 얻은 결과
- 모든 능력이 같은 규모에서 나타나거나 모든 모델에서 같은 변화가 생긴다는 뜻은 아님
- 예: (E) TruthfulQA에서는 Gopher의 점수가 오르지만 GPT-3는 비슷한 계산량 범위에서도 기준 근처에 머묾
그림 출처: Wei 외 (2022)
매끄러운 손실과 갑작스러운 과제 점수
- 규모의 법칙: 규모가 커질수록 예측 손실이 비교적 매끄러운 추세로 감소
- 창발적 능력: 같은 규모 변화에서 특정 과제의 점수는 급격히 오르는 것처럼 보임
- 질문: 모델 내부의 능력이 실제로 갑자기 생긴 것인가, 아니면 측정 방식이 변화를 갑작스럽게 보이게 하는 것인가?
채점 방식이 갑작스러운 변화를 만들 수도 있다
- 완전 일치 채점: 답 전체가 맞아야 정답으로 인정
- 부분적으로 더 잘 답해도 전체 답이 틀리면 점수에 반영되지 않음
- 부분적인 개선을 반영하는 채점: 같은 출력에서도 더 점진적인 변화를 관찰할 수 있음
- 2023년 연구: 평가 지표의 선택이 창발적으로 보이는 성능 곡선을 만들 수 있음을 제시
문제 하나에서 본 차이
- 설명용 가상 예시: 정답이
128인 문제에서 같은 위치의 숫자를 비교
| 모델 출력 | 맞힌 숫자 수 | 완전 일치 채점 |
|---|---|---|
156 |
1개 | 오답 |
126 |
2개 | 오답 |
128 |
3개 | 정답 |
- 맞힌 숫자 수: 1개 → 2개 → 3개로 개선
- 완전 일치 결과: 오답 → 오답 → 정답으로 전환
- 핵심: 같은 출력의 개선도 무엇을 점수로 삼는지에 따라 다르게 보임
많은 문제에서 본 곡선
- 문제 하나의 결과는 정답 또는 오답뿐이므로, 성능 곡선은 많은 문제의 평균 점수로 그림
- 설명용 단순화: 각 자리를 맞힐 확률 p가 같고 자리끼리 독립이라고 가정
- 세 자리 완전 일치율은 p3
| 규모 | 자리별 정확도 p | 완전 일치율 p3 |
|---|---|---|
| 작음 | 0.3 | 2.7% |
| 중간 | 0.6 | 21.6% |
| 큼 | 0.9 | 72.9% |
- 자리별 정확도: 0.3씩 일정하게 상승
- 완전 일치율: 작은 규모에서는 거의 0에 가깝다가 큰 규모에서 크게 상승
- 핵심: 부분 단위의 점진적인 개선이 전체 정답 기준에서는 갑작스러운 상승처럼 보일 수 있음
- 답이 길수록, 즉 모두 맞혀야 하는 부분이 많을수록 이 효과가 커짐
출처: Are Emergent Abilities of Large Language Models a Mirage? (Schaeffer 외, 2023)
아직 정리되지 않은 논쟁
- 위 설명은 일부 창발 사례가 평가 방식에서 비롯될 수 있다는 주장
- 모든 창발적 능력이 착시라는 결론은 아님
- 반론: 연속적인 지표를 써도 사전학습 손실이 일정 수준 아래로 내려간 뒤에야 성능이 오르는 과제가 있다는 연구도 있음
- 정리: 갑작스러운 상승을 관찰하면 채점 방식, 실험 조건, 다른 지표의 결과를 함께 확인
출처: Understanding Emergent Abilities of Language Models from the Loss Perspective (Du 외, 2024)
실무에서 모델을 어떻게 평가할까?
- 작은 모델의 실패만으로 가능성을 닫지 않기
- 작은 모델들에서 성능 향상이 거의 없어도 더 큰 모델에서 같은 추세가 이어진다고 단정하기 어려움
- 중요한 업무라면 상위 모델에서도 실제 업무 사례로 수행 가능성을 확인
- 큰 모델이라는 이유만으로 성공을 보장할 수도 없으므로 모델별로 직접 평가
- 업무 전체의 성공률과 부분적인 개선을 함께 보기
- 예: 문서에서 이름·금액·날짜를 추출할 때 세 항목 모두 맞아야 업무 성공으로 평가
- 세 항목을 모두 틀리던 모델이 날짜만 틀리게 되어도 전체 성공 여부로는 여전히 실패
- 전체 성공률과 항목별 오류를 함께 측정하면 성능의 변화와 추가로 보완할 부분을 파악하기 쉬움
퀴즈
창발적 능력에 대한 설명으로 가장 알맞은 것은?
퀴즈를 풀려면 대화형 기능을 불러와야 합니다.