인컨텍스트 학습
지시와 시범 예시로 과제 수행을 유도하고, 파라미터 학습과의 차이를 이해한다.
- 인컨텍스트 학습(in-context learning): 모형의 파라미터를 바꾸지 않고, 입력에 포함한 지시와 예시만으로 새 과제를 수행하는 능력
- ‘학습’이라는 이름이지만 가중치는 갱신되지 않음. 예시의 효과는 해당 대화 안에서만 유지되며, 새 대화에도 적용하려면 예시를 다시 포함해야 함
- ChatGPT의 메모리 기능처럼 이전 대화의 내용을 새 대화에 이어 주는 기능도 있음. 이 경우에도 모형이 학습한 것이 아니라, 저장해 둔 내용을 새 대화의 입력에 함께 넣어 주는 방식
- 미세조정과 달리 모형 자체는 그대로이므로, 같은 모형으로 입력만 바꿔 여러 과제에 적용 가능
- 작동 원리에 대한 설명 중 하나: 사전학습 데이터에는 같은 형식이 반복되는 텍스트가 많아, 모형이 예시를 보고 어떤 과제인지 파악한 뒤 그 형식에 맞게 이어 쓴다는 가설. 정확한 원리는 아직 연구 중
제로샷과 퓨샷
- 제로샷(zero-shot): 시범 예시 없이 지시만으로 과제 수행
- 원샷(one-shot): 입력·출력 예시 하나를 제공
- 퓨샷(few-shot): 입력·출력 예시 몇 개를 제공
- 예시의 역할: 판단 기준·표현 방식·출력 형식을 구체적으로 전달
개발자가 남긴 메모를 앱 사용자가 읽을 릴리스 노트로 바꾸는 상황. 내부 원인을 설명할지, 사용자에게 달라지는 점을 쓸지, 어떤 말투와 형식을 쓸지에 따라 결과가 달라짐.
시범 예시 없이 요청하는 제로샷 프롬프트:
개발 메모를 사용자용 릴리스 노트 한 줄로 바꿔라.

메모: 앱 재실행 시 다크 모드가 풀리는 문제. 설정 저장 누락 수정.
릴리스 노트:
팀에서 사용하는 작성 방식을 예시 두 개로 보여주는 퓨샷 프롬프트:
개발 메모를 사용자용 릴리스 노트 한 줄로 바꿔라.

메모: 주문 목록에 배송 상태 필터 추가.
릴리스 노트: [추가] 배송 상태별로 주문을 모아 볼 수 있습니다.

메모: 장바구니 수량 변경 시 합계 갱신이 누락됨. 계산 로직 수정.
릴리스 노트: [수정] 상품 수량을 바꾸면 합계 금액이 바로 갱신됩니다.

메모: 앱 재실행 시 다크 모드가 풀리는 문제. 설정 저장 누락 수정.
릴리스 노트:
- 예시에서 전달하는 기준:
[추가]·[수정]으로 시작하고, 사용자에게 달라지는 점을 존댓말 한 문장으로 표현 - 정보 선택: 내부 구현인 ‘계산 로직 수정’ 대신 사용자가 경험하는 변화인 ‘합계 금액이 바로 갱신’을 제시
- 마지막 메모: 새로 작성할 대상. 앞의 두 쌍은 원하는 작성 방식을 보여주는 시범
- 원하는 결과의 작성 예:
[수정] 앱을 다시 열어도 다크 모드 설정이 유지됩니다.
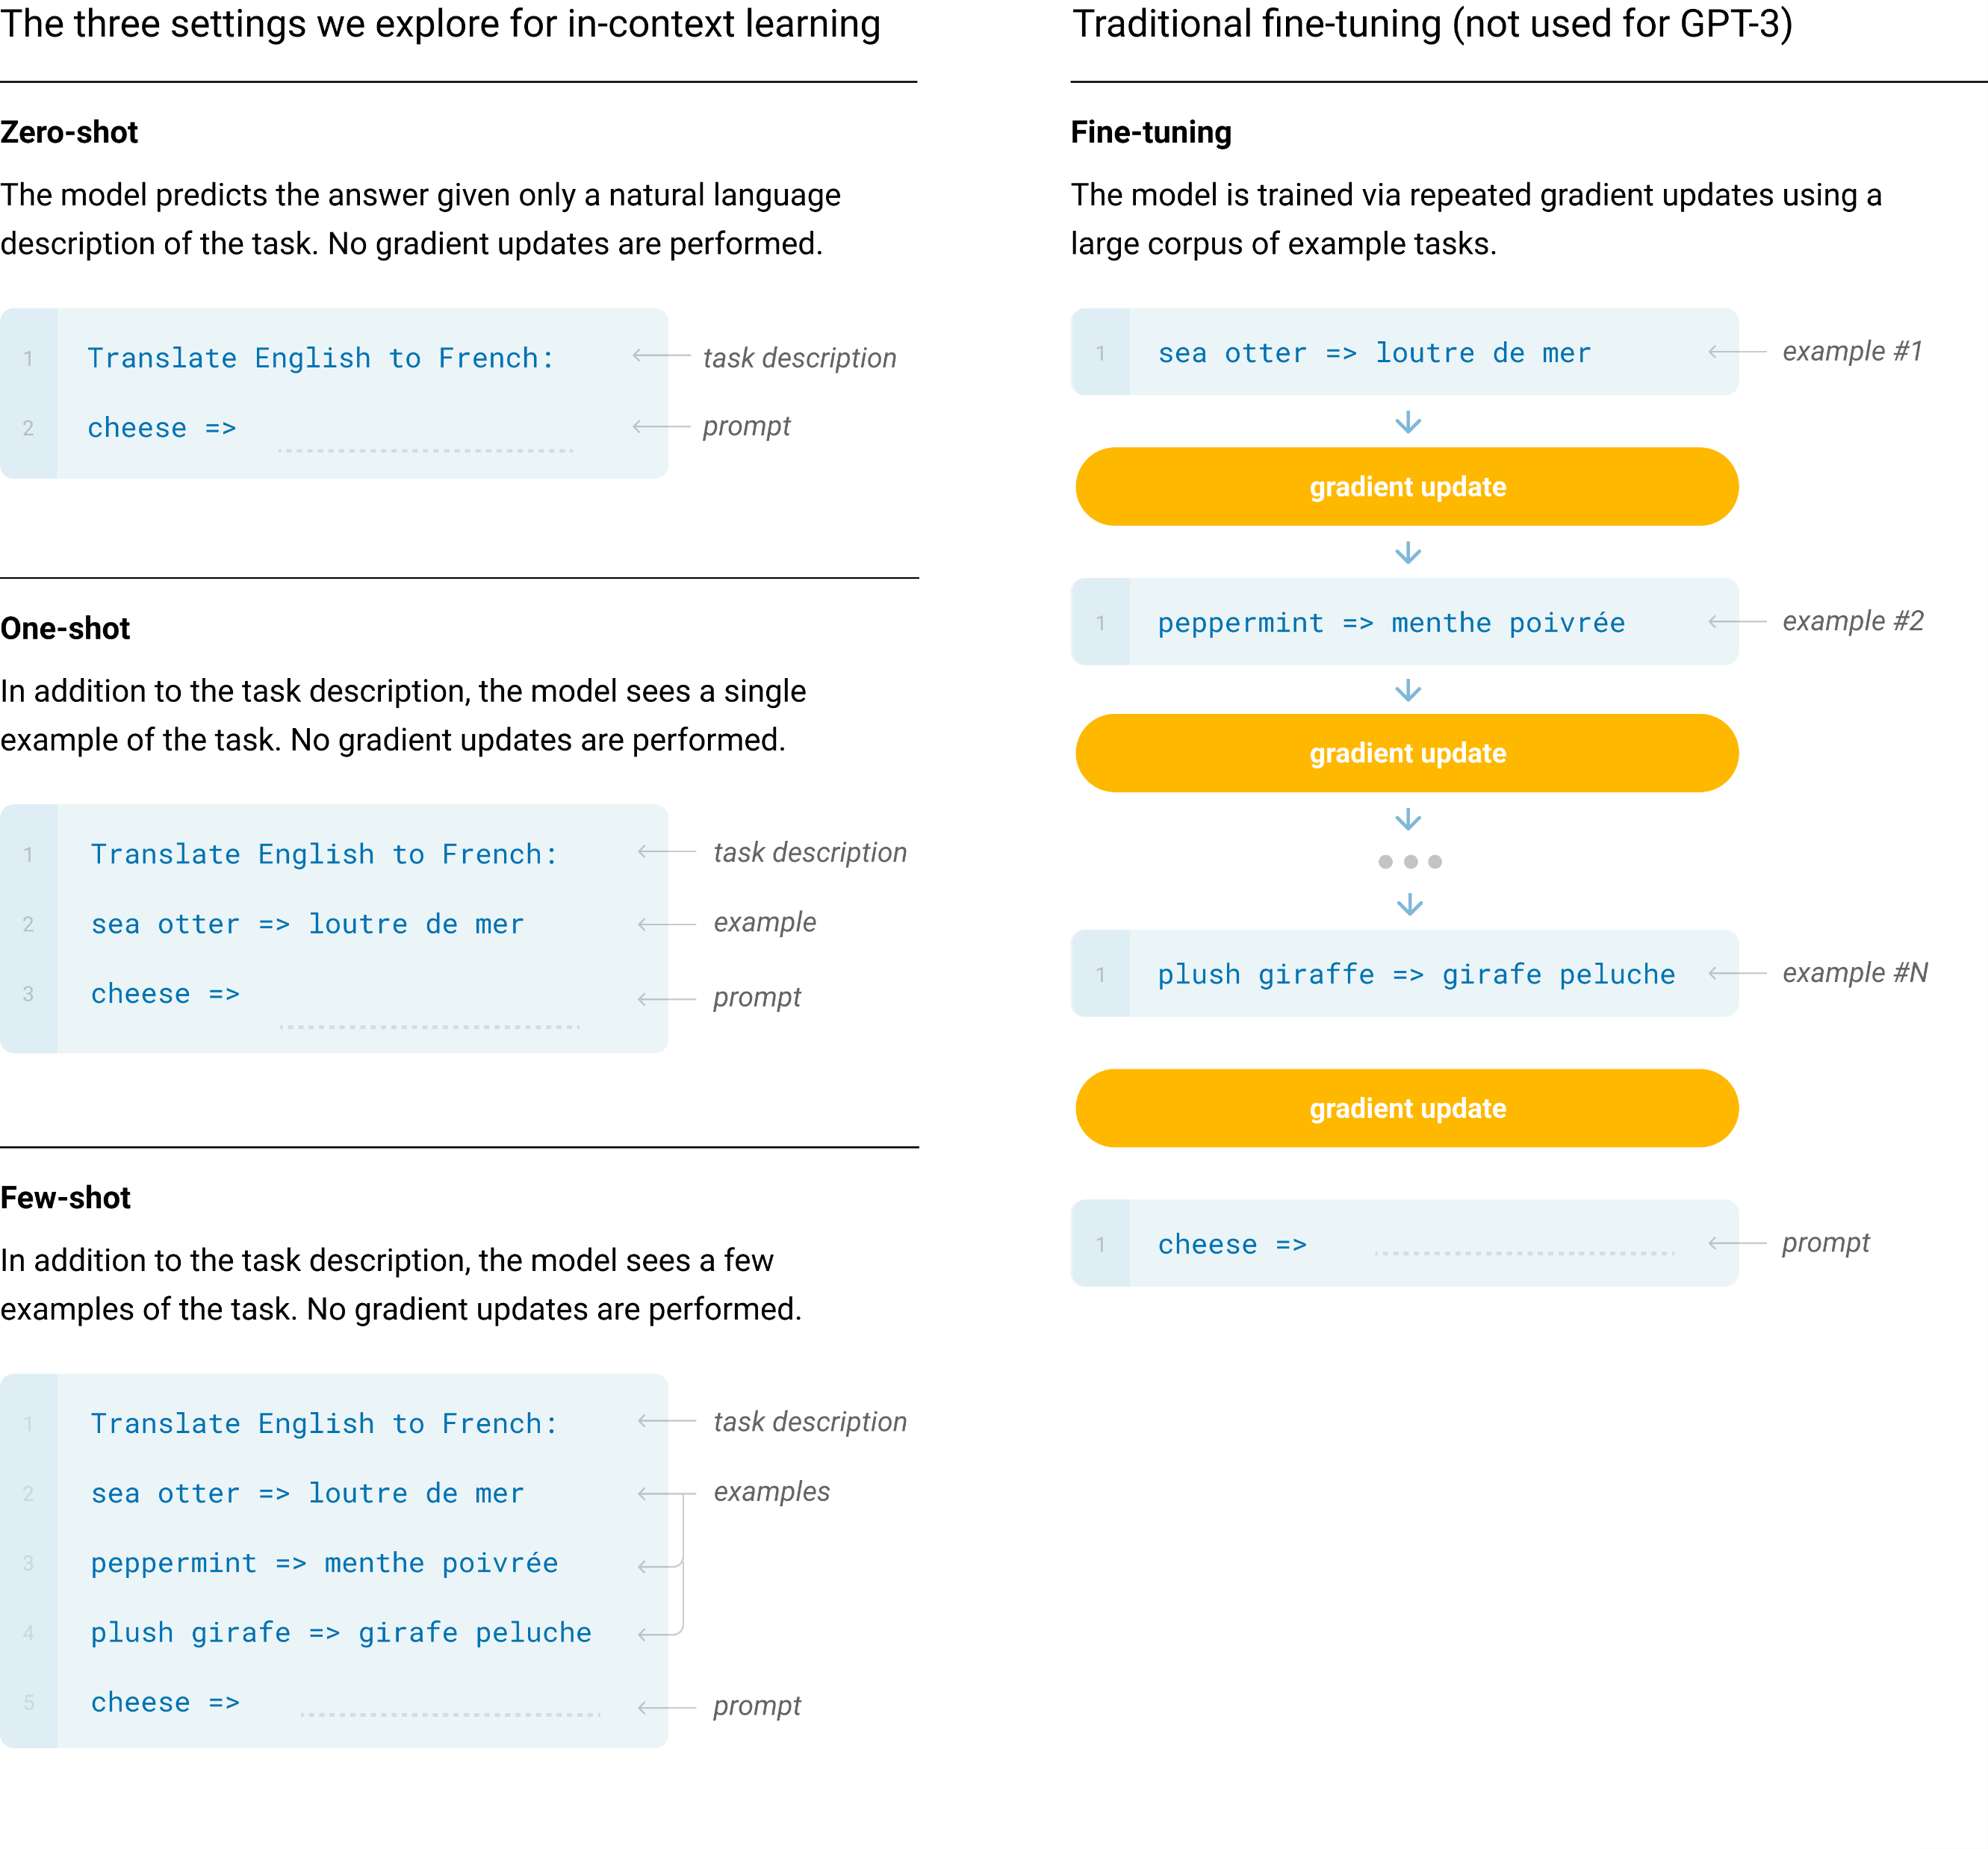
출처: Language Models are Few-Shot Learners
예시 수에 따른 성능과 안정성
Zhuo 등의 ProSA: Assessing and Understanding the Prompt Sensitivity of LLMs(2024)는 예시 수를 바꾸며 성능과 프롬프트 민감도를 비교한 연구.
- 실험: Qwen1.5 계열 모델 4개에 예시를 0·1·3·5·7개 제공하고, 같은 과제를 표현한 프롬프트 12개로 평가
- 평가 과제: 상식 객관식 문항인 CommonsenseQA와 과학 객관식 문항인 ARC-Challenge
- 프롬프트 민감도: 같은 문제를 뜻이 같은 다른 표현으로 제시했을 때 정답 여부가 얼마나 달라지는지 측정. 지표인 PSS가 낮을수록 표현 변화에도 결과가 안정적
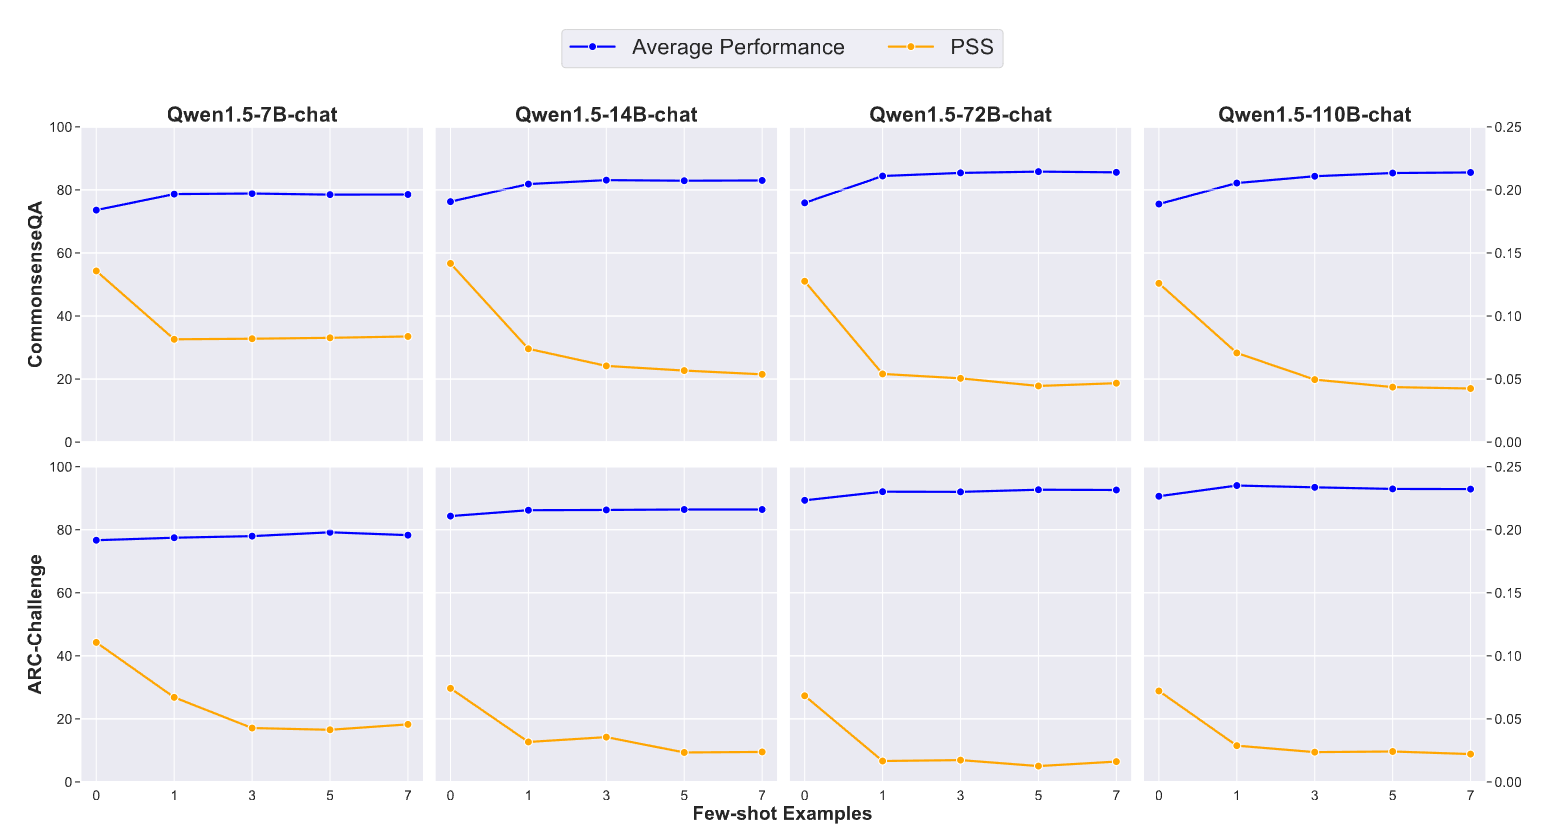
출처: Zhuo 외(2024), ProSA, 그림 5.
- 가로축: 프롬프트에 제공한 예시 수. 0은 제로샷, 1은 원샷
- 파란 선·왼쪽 축: 평균 정답률. CommonsenseQA에서는 예시를 추가한 초반에 상승하고 이후 완만해짐. ARC-Challenge에서는 정답률 변화가 상대적으로 작음
- 주황 선·오른쪽 축: 프롬프트 민감도 PSS. 특히 예시를 0개에서 1개로 늘릴 때 크게 하락
- 1개 이후의 변화는 모델과 과제에 따라 다름. CommonsenseQA의 14B·110B 모델에서는 예시를 더 추가할수록 민감도가 계속 낮아지지만, 다른 경우에는 대체로 비슷한 수준을 유지
- 예시가 분류·응답의 기준을 제공해 지시문의 세부 표현에 덜 흔들리게 하는 것으로 해석할 수 있음
예시를 고르는 기준
- 같은 종류의 쉬운 예시만 반복하면 다른 유형의 판단 기준이 부족
- 정답이 틀린 예시나 서로 충돌하는 예시는 잘못된 기준을 전달할 위험
- 입력 토큰·비용과 실제 질문에 쓸 공간을 고려해 예시 수를 조정
- 문장 구조나 예시 순서가 결과에 영향을 줄 수 있으므로 대표적인 입력 여러 개로 확인
퀴즈
인컨텍스트 학습에서 프롬프트에 예시를 넣으면 모형의 파라미터는 어떻게 되는가?
퀴즈를 풀려면 대화형 기능을 불러와야 합니다.