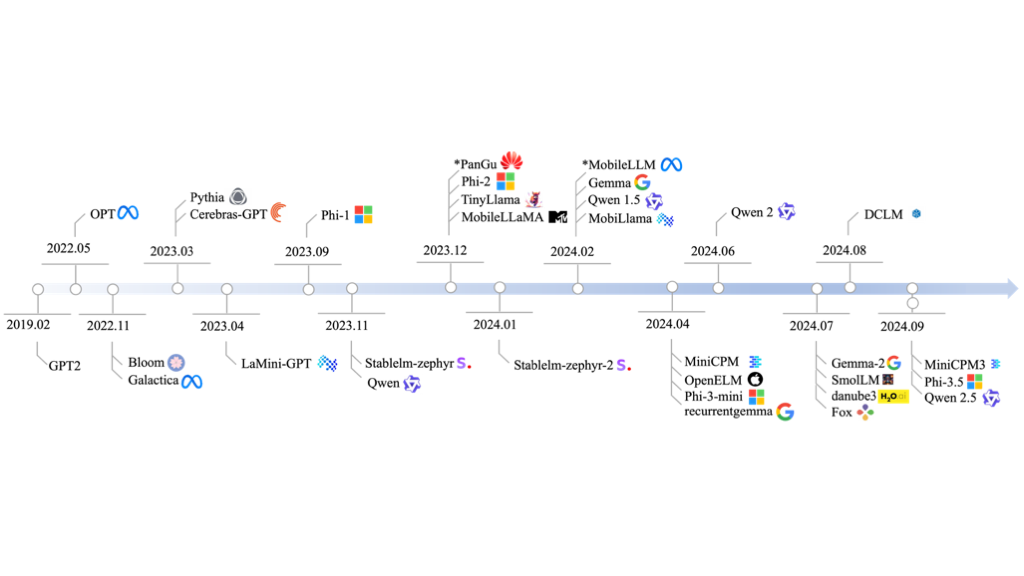
소형 언어 모델
소형 언어 모델
- 소형 언어 모델(Small Language Model, SLM): LLM보다 작고 한정적인 용도를 가진 언어 모델
- GPT와 동일하게 디코더 전용 트랜스포머 아키텍처
- 대체로 100M~5B 사이의 파라미터 규모
친칠라 법칙
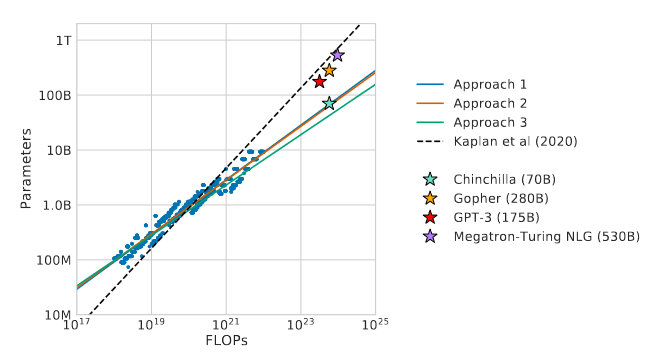
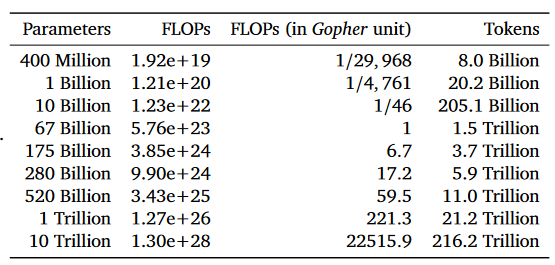
- 친칠라 법칙(Chinchilla Law): 모델 크기에 따른 최적 훈련량을 측정
- 모델 크기의 약 20배 규모 데이터
- 기존 모델들은 크기에 비해 훈련량이 부족
- GPT-3: 175B 파라미터에 대해 논문의 표에서 제시한 훈련량은 3.7T 토큰
- 실제 GPT-3의 학습량은 300B 토큰
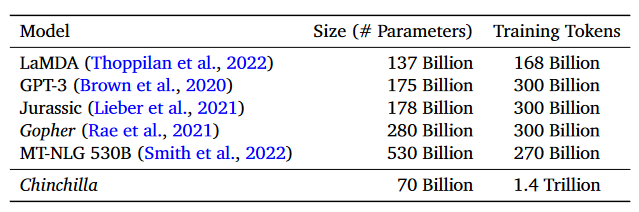
출처: Training Compute-Optimal Large Language Models (Hoffmann et al., 2022; DeepMind)
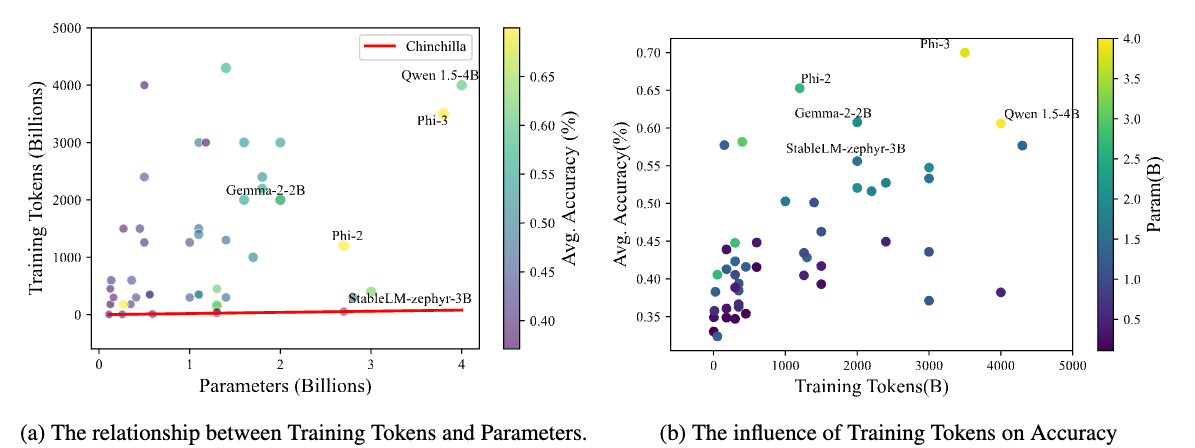
데이터의 양과 성능의 관계
- (a) 최근 공개된 SLM들은 친칠라 법칙을 크게 상회하는 양의 데이터로 학습
- (b) 데이터의 양이 많을수록 성능도 높아짐
- 양도 중요하지만, SLM은 LLM에 비해 데이터의 질도 중요
- 상대적으로 작은 모델이기 때문
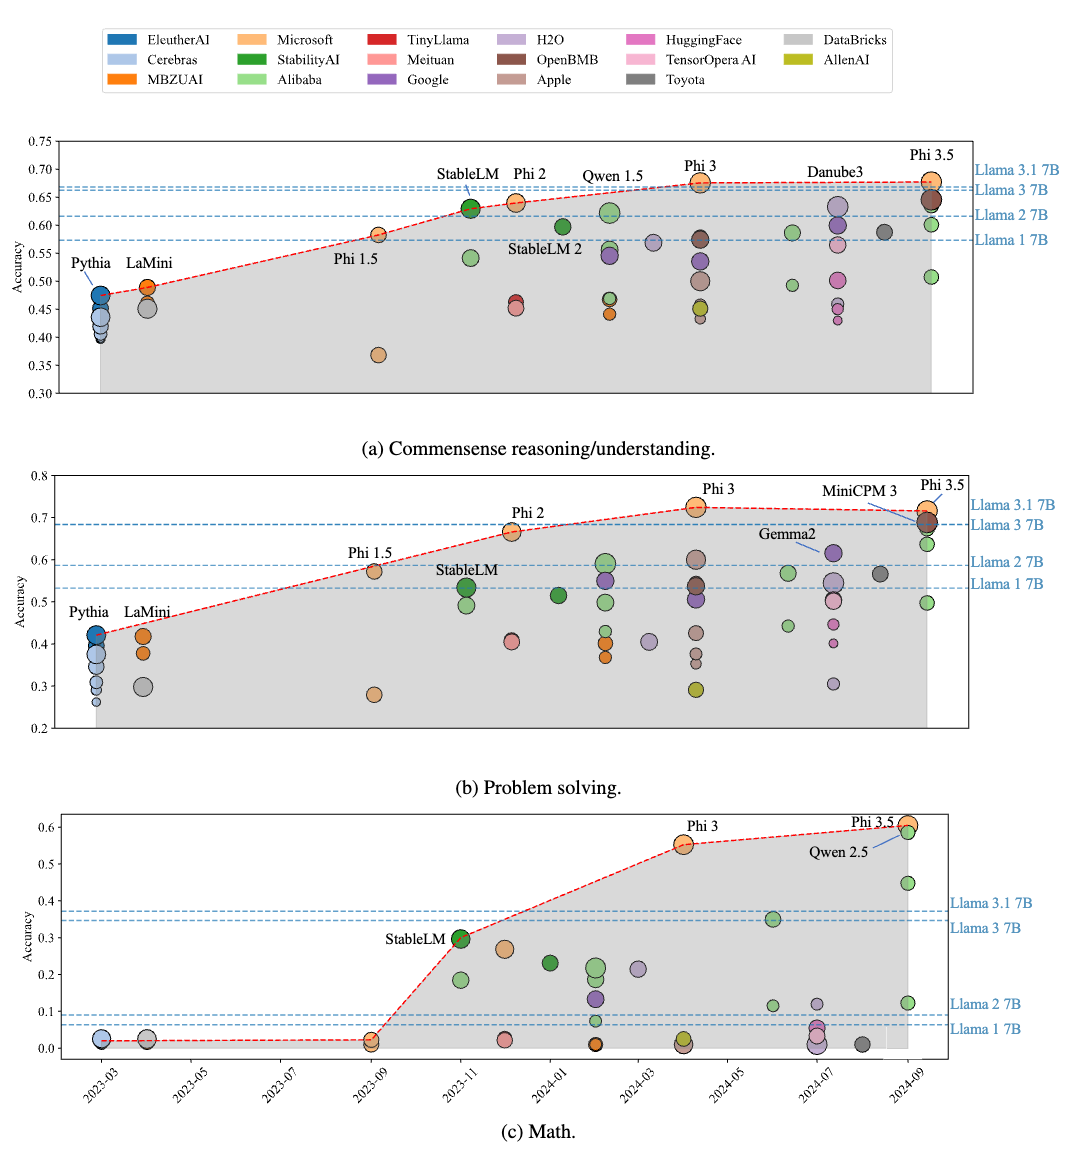
SLM과 LLM의 비교
- SLM이 LLM에 준하는 성능을 보이고 있음
퀴즈
친칠라 법칙이 제시하는 학습 방향으로 가장 적절한 것은?
퀴즈를 풀려면 대화형 기능을 불러와야 합니다.