
증강
최신 정보·정확한 계산·실제 행동에 증강이 필요한 이유를 이해하고, 로봇 제어 사례로 모델과 외부 도구의 역할을 구분한다.
- 증강(augmentation): 언어 모델에 외부 정보나 도구를 연결해 작업 능력을 확장하는 방법.
- 학습용 이미지의 회전·뒤집기 같은 데이터 증강과는 다름
증강이 필요한 이유
- 최신 정보: 학습된 지식만으로는 지금의 재고·가격·날씨를 확인하기 어려움. 현재 상태를 알려 주는 자료나 조회 도구 필요.
- 정확한 계산: 계산 과정을 그럴듯하게 설명해도 수치가 틀릴 수 있음. 정해진 연산은 계산 함수나 코드 실행기에 맡기고 실제 결과 확인.
- 실제 행동: “컵을 옮기겠다”라는 문장을 생성해도 컵이 움직이지는 않음. 환경을 인식하고 로봇을 움직이는 장치·프로그램과 연결 필요.
| 요청 | 텍스트 생성만으로 부족한 점 | 연결할 외부 능력 |
|---|---|---|
| 이 상품은 지금 몇 개 남았나? | 현재 재고가 입력에 없음 | 재고 조회 |
| 이 표의 매출 합계는? | 수치를 빠뜨리거나 잘못 계산할 수 있음 | 계산 함수·코드 실행기 |
| 빈 그릇 위에 블록을 쌓아 줘 | 물체의 위치 확인과 물리적 동작 필요 | 물체 인식·로봇 제어 |
| 주문을 취소해 줘 | 취소 안내 문장만으로 주문 상태가 바뀌지 않음 | 주문 취소 도구 |
LLM과 애플리케이션의 역할
- 애플리케이션: 사용자 요청을 LLM에 보내고, LLM이 요청한 외부 도구를 실행해 결과를 전달하는 프로그램. 아래 그림에서는 사용자·LLM·외부 도구 사이의 흐름을 관리.
Mermaid 다이어그램 원문
sequenceDiagram
    autonumber
    actor U as 사용자
    participant A as 애플리케이션
    participant L as LLM
    participant F as 외부 도구
    U->>A: 질문 또는 작업 요청
    A->>L: 사용자 요청과 사용 가능한 도구 정의 전달
    L-->>A: 필요한 도구와 인자를 지정해 호출 요청
    A->>F: 지정된 인자로 도구 실행
    F-->>A: 실행 결과 반환
    A->>L: 호출 기록과 실행 결과 전달
    L-->>A: 실행 결과를 반영한 답변 생성
    A-->>U: 최종 답변 전달
대화형 다이어그램을 불러오기 전에는 원문으로 표시됩니다.
- LLM: 어떤 도구에 어떤 인자를 전달할지 결정.
- 애플리케이션: 요청된 도구를 실행하고 결과를 LLM에 전달.
- 실행 결과를 받은 LLM: 결과를 질문에 맞게 설명.
증강의 종류
- 정보 조회: 외부 정보나 현재 상태를 가져오는 기능. 재고·날씨·문서 조회, 카메라로 물체 위치 확인.
- 계산: 입력에 정해진 연산을 적용하는 기능. 합계·할인 금액 계산.
- 행동: 외부 상태를 바꾸는 기능. 일정 등록·주문 취소.
- 하나의 도구가 여러 기능을 함께 수행할 수도 있음.
계산의 예시
- 실험: Zhou 외(2023)가 GPT-4 Code Interpreter로 MATH 수학 문제를 풀며 코드 사용 조건을 비교.
- MATH: 수학 경시대회 수준의 문제와 정답을 모은 평가용 데이터셋.
- Code Interpreter: LLM이 작성한 파이썬 코드를 실행하고, 실행 결과를 LLM에 돌려주는 환경.
- 풀이 흐름: LLM이 계산 코드를 작성 → 실행기가 계산 → LLM이 실행 결과를 읽고 풀이에 반영. 코드로 답을 검증하는 조건에서는 구한 답이 문제의 조건을 만족하는지도 코드로 확인하고, 검증에 실패하면 풀이 수정.
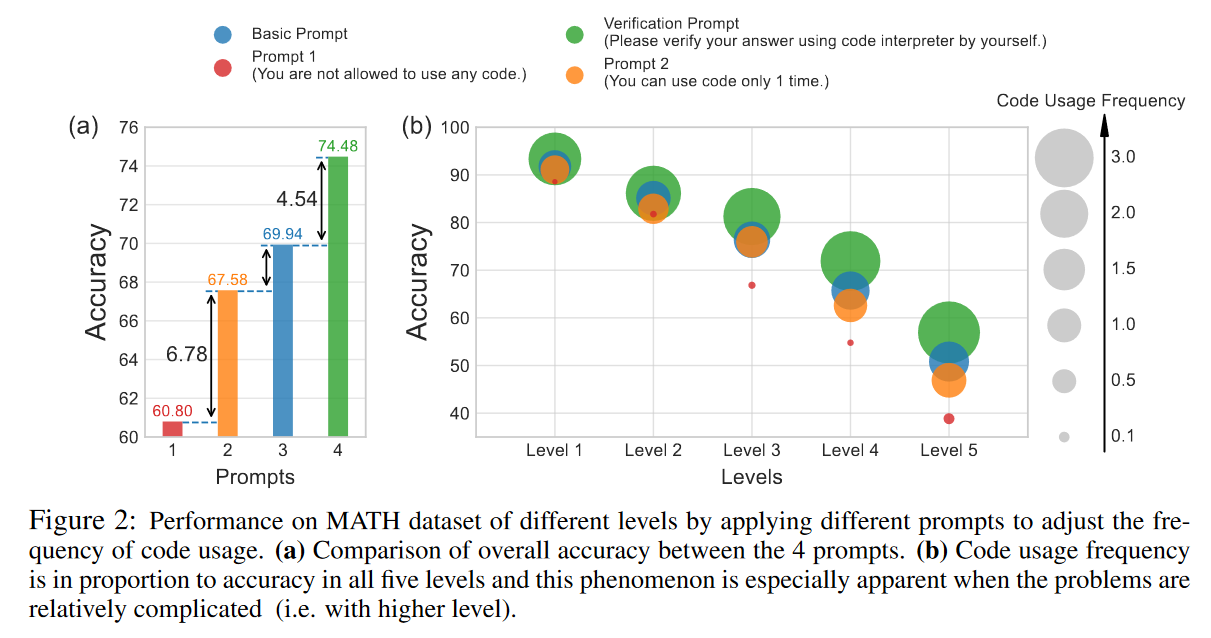
- 왼쪽: 조건별 정답률(%). 코드 사용 금지 60.80%, 한 번만 허용 67.58%, 사용 제한 없음 69.94%, 코드로 답을 검증하도록 요청 74.48%.
- 오른쪽: 가로축은 문제 난이도, 세로축은 정답률. 원이 클수록 코드를 실행한 횟수가 많음.
- 해석: 이 실험에서는 코드 실행과 결과 검증을 활용한 조건에서 정확도가 높았음. 계산을 외부 실행기에 맡기고, 반환된 결과로 풀이를 확인하는 증강의 효과를 보여주는 사례.
출처: Zhou 외(2023), Solving Challenging Math Word Problems Using GPT-4 Code Interpreter with Code-based Self-Verification, 그림 2.
행동의 예시
Code as Policies: 지시를 실행 코드로 바꾸기
- 사용자 요청: “빈 그릇 위에 블록을 쌓아 줘.”
- 언어 모델: 지시를 해석해 미리 준비된 인식·제어 API를 호출하는 코드 작성. 준비되지 않은 기능은 새 함수로 정의.
- 인식 API: 카메라 영상에서 블록과 그릇을 찾음.
- 제어 API: 지정한 물체를 집어 목표 위치에 놓는 동작 실행.
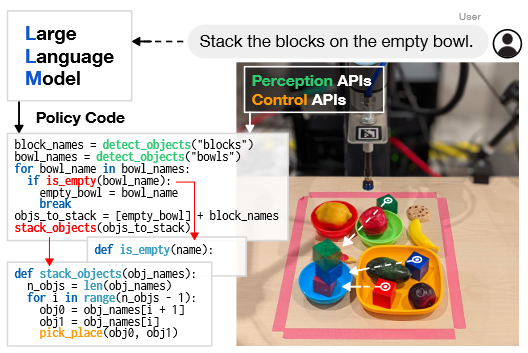
- 초록색
detect_objects: 블록과 그릇을 찾는 인식 API. - 주황색
pick_place: 물체를 집어 다른 물체 위에 놓는 제어 API. - 빨간색
is_empty,stack_objects: 준비된 API에 없어 언어 모델이 새로 정의한 함수. 그릇이 비었는지 확인하는 함수와,pick_place를 반복 호출해 물체를 차례로 쌓는 함수. - 그림 오른쪽: 카메라로 인식할 물체와 실제 동작을 수행할 로봇.
- 핵심: 모델이 로봇의 모든 움직임을 직접 계산하는 대신, 준비된 인식·제어 API를 코드로 조합. 필요한 기능이 없으면 그 함수를 새로 작성해 단계적으로 코드 구성.
출처: Liang 외(2022), Code as Policies: Language Model Programs for Embodied Control.
SayCan: 필요한 행동과 가능한 행동 함께 판단하기
- 사용자 요청: “음료를 쏟았는데 도와줄래?”
- 언어 모델: 요청을 해결하는 데 유용한 행동을 판단. 예를 들어 스펀지를 찾거나 집는 행동을 고려.
- 로봇의 가치 함수: 현재 환경과 로봇의 능력에서 해당 행동이 성공할 가능성을 평가.
- 두 정보를 결합해 요청에 도움이 되면서 현재 실행할 수 있는 행동을 선택.
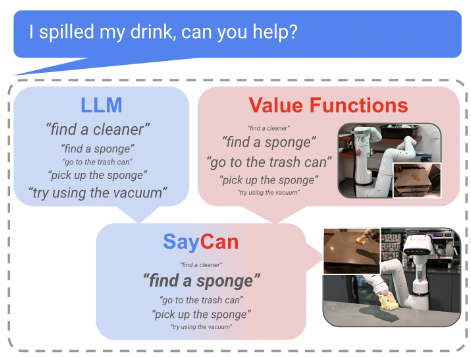
- 그림 위: 언어 모델의 판단과 로봇 가치 함수의 판단.
- 그림 아래: 두 판단을 결합해 선택한 행동과 로봇의 실행 장면.
- 핵심: 자연어로 적절해 보이는 행동이라도 현재 로봇이 수행할 수 있는지 확인 필요.
출처: Ahn 외(2022), Do As I Can, Not As I Say: Grounding Language in Robotic Affordances.
도구를 연결하는 여러 방식
- 함수 호출: 미리 만든 함수에 모델이 인자 지정.
- MCP: 외부 도구와 자료를 공통 프로토콜로 연결.
- 코드 실행: 모델이 작성한 코드를 별도의 실행기에서 실행.
- 도구 검색: 많은 도구 중 필요한 도구의 정의를 찾아 로딩.
퀴즈
언어 모델의 증강이란 무엇인가?
퀴즈를 풀려면 대화형 기능을 불러와야 합니다.