컨텍스트 설계와 관리
현재 작업에 필요한 정보를 선택하고, 대화와 도구 결과를 축약·갱신하며 외부 메모리를 활용한다.
컨텍스트란 무엇인가
- 컨텍스트(context): 모델이 이번 응답을 생성할 때 참조하는 입력 정보
- 고정 지침, 이번 질문, 시범 예시, 참조 자료, 이전 대화, 사용 가능한 도구의 설명과 실행 결과 등
- 컨텍스트 창(context window): 한 번의 생성에서 모델이 처리할 수 있는 토큰 범위
- 입력 자료와 대화 기록이 길어지면 생성할 답변을 위한 공간도 함께 고려
- 최대 길이 안에 들어간다는 것과 필요한 정보를 정확히 활용한다는 것은 별개의 문제
- 프롬프트 설계: 한 요청에 들어갈 지시·자료·예시와 출력 조건을 구성
- 컨텍스트 설계와 관리: 여러 차례의 모델 호출에 걸쳐 필요한 정보를 선택·배치·갱신
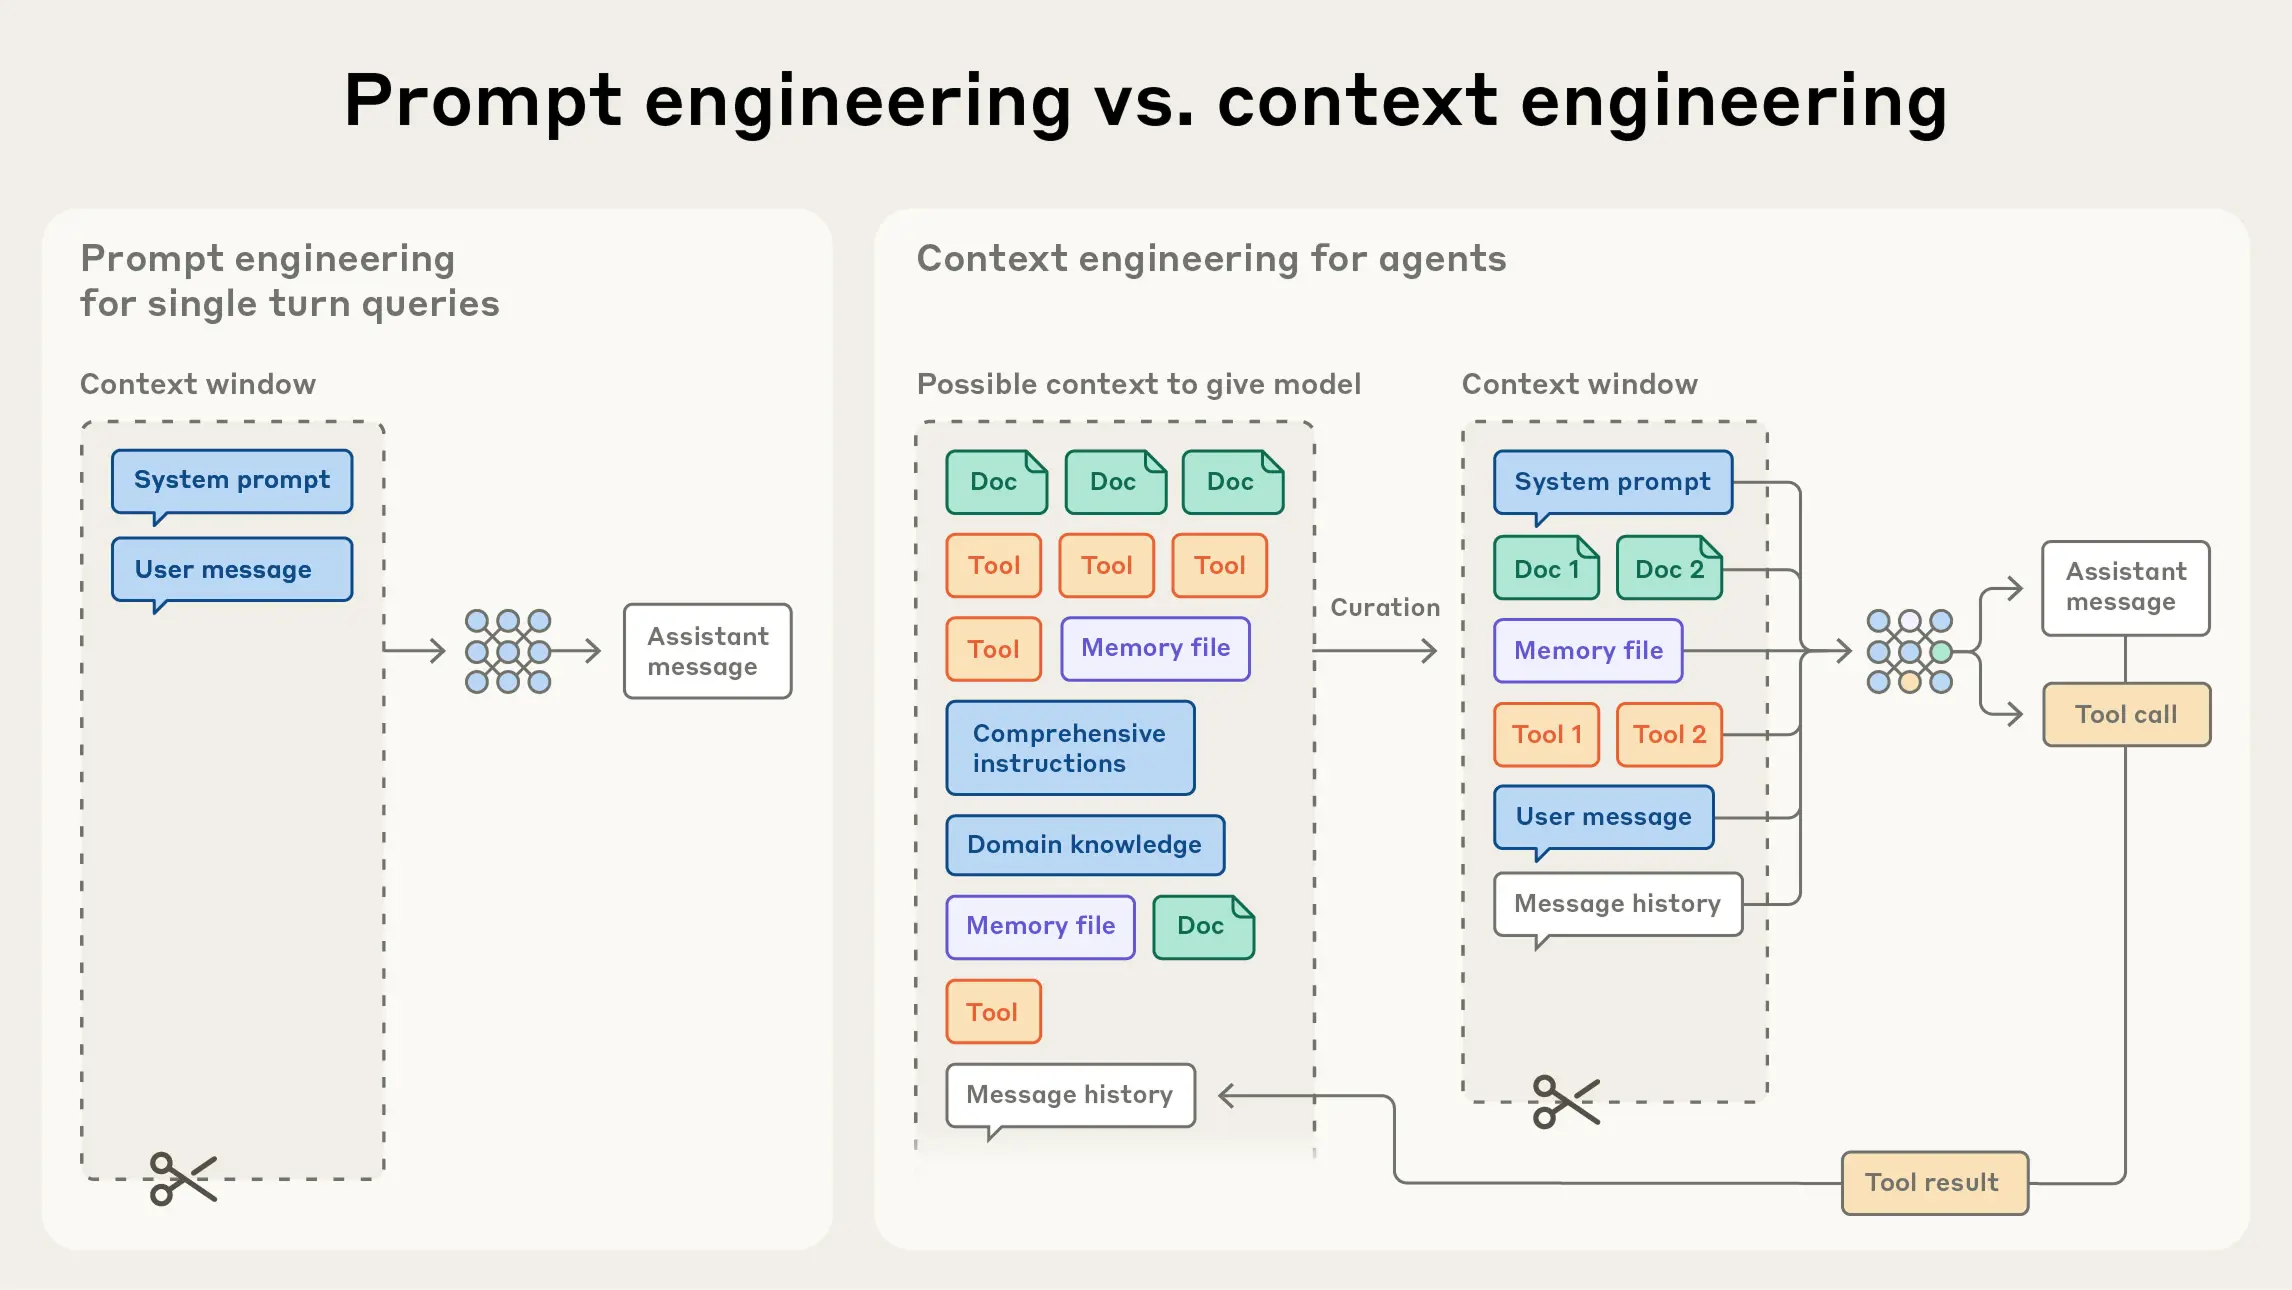
출처: Anthropic(2025), Effective context engineering for AI agents.
- 왼쪽: 시스템 지침과 사용자 요청을 전달해 한 번의 답변 생성
- 오른쪽: 이용 가능한 자료 전체에서 이번 작업에 필요한 문서·도구·메모리를 선택해 입력 구성
- 반복 과정: 모델 호출 → 답변 또는 도구 실행 → 새 결과를 반영해 다음 호출의 컨텍스트 재구성
필요한 정보 선택하기
강좌 안내문과 이전 상담 기록을 이용해 수강 문의에 답하는 상황을 예로 살펴보기.
| 정보 | 수강 상담에서의 역할 |
|---|---|
| 고정 지침 | 안내문에 근거해 답하고, 확인되지 않은 규정은 추측하지 않는 규칙 |
| 이번 질문 | 현재 답해야 할 수강 문의 |
| 참조 자료 | 해당 강좌의 일정·수강료·납부 규정 |
| 필요한 대화 기록 | 앞서 선택한 강좌와 사용자의 조건 |
- 관련성: 지금 질문에 답하는 데 필요한 정보인가?
- 최신성: 현재 적용되는 안내인가?
- 출처: 어떤 문서의 어느 항목에 나온 정보인가?
- 일관성: 자료가 충돌하면 어떤 기준으로 판단할 것인가?
- 기준 날짜와 적용 강좌를 확인해 이번 질문에 적용되는 규정 선택
- 적용할 규정을 결정할 근거가 없으면 확인 필요로 표시
참조 자료와 질문을 구분해 전달하는 예:
작업: 아래 안내문에 근거해 생성형 AI 강좌의 수강 문의에 답해라.
규칙: 안내문에 없는 납부 방식은 운영팀 확인이 필요하다고 안내해라.

[참조 자료: 강좌 안내문, 수강료·납부 항목]
생성형 AI: 수강료 12만 원. 분할 납부는 운영팀에 문의.
[/참조 자료]

[이번 질문]
두 번에 나누어 낼 수 있나요?
[/이번 질문]
- 기대하는 답: 수강료는 12만 원이며, 분할 납부 가능 여부는 운영팀 확인이 필요하다는 안내
- 구분 표지: 지시·자료·질문의 경계를 읽기 쉽게 표현. 자료 안의 악의적 지시를 차단하는 보안 기능은 별개
대화 기록으로 맥락 이어 가기
user: 생성형 AI 강의를 신청하려고 해요.
assistant: 일정과 수강료 중 어떤 내용이 궁금한가요?
user: 두 번에 나누어 낼 수 있나요?
- 마지막 질문만 전달: 어느 강좌에 관한 질문인지 알기 어려움
- 강좌 선택 기록 포함: 생성형 AI 강좌의 분할 납부 문의라는 맥락 확보
- 강좌 안내문도 포함: 답변에 필요한 실제 납부 규정 확보
- Chat Completions 호출: 필요한 이전 메시지를
messages에 포함해 전달- 같은
client를 사용해도 이전 호출의 대화가 자동으로 입력에 포함되지는 않음
- 같은
- 사용자 발언, 문서에서 확인한 사실, 이전
assistant답변을 구분해 관리- 이전 답변이 “분할 납부 가능”이라고 했어도 안내문에서 확인되지 않았다면 확정된 규정으로 기록하지 않음
긴 컨텍스트에서 생기는 문제
정보의 위치: Lost in the Middle
Liu 외(2023)의 Lost in the Middle: How Language Models Use Long Contexts는 정답 근거의 위치를 바꾸며 모델의 질의응답 정확도를 측정한 연구.
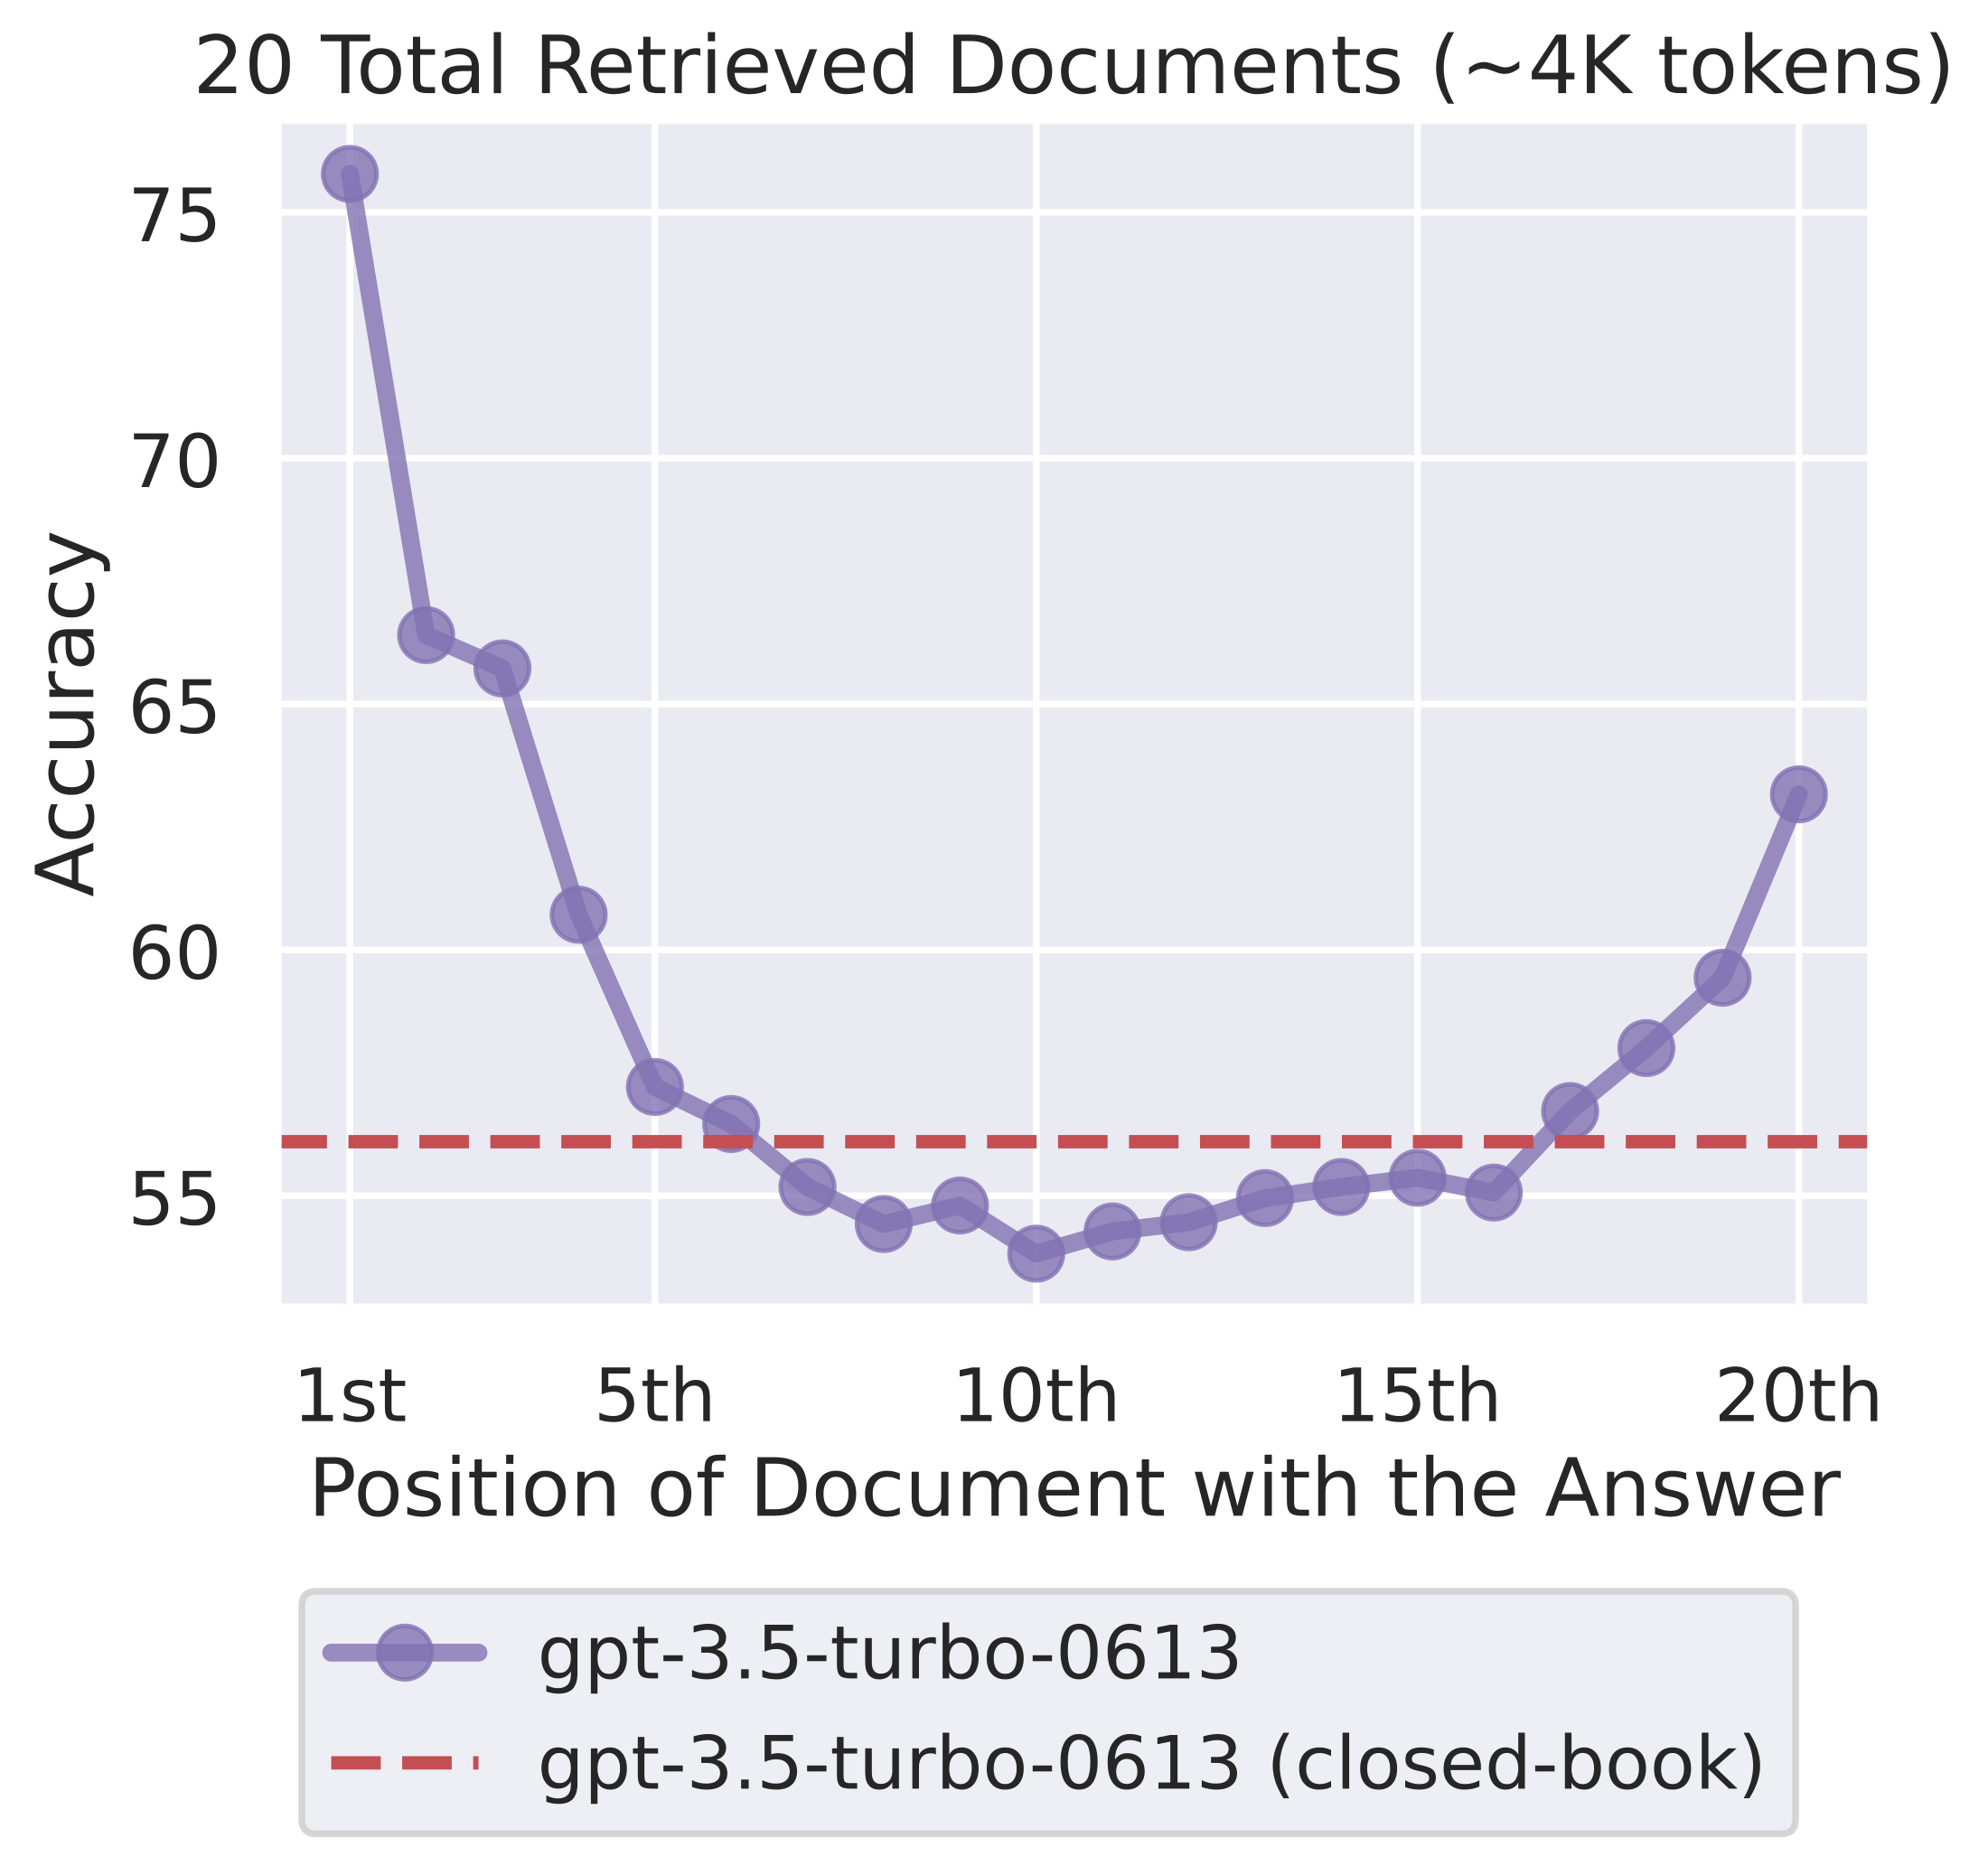
출처: Liu 외(2023), 그림 1.
- 실험: 질문과 문서 20개는 유지하고, 정답이 포함된 문서의 위치만 변경. 모델은
gpt-3.5-turbo-0613 - 가로축: 정답 문서의 위치. 왼쪽이 입력의 앞, 오른쪽이 뒤
- 세로축: 질의응답 정확도(%). 앞·뒤보다 중간에서 낮은 U자형 곡선
- 붉은 점선: 문서를 제공하지 않고 질문만으로 답한 정확도
- 적용: 자료를 많이 넣는 것에 그치지 않고, 핵심 근거를 찾기 쉬운 구조로 배치하고 실제 답변 정확도 확인
근거를 찾아도 문제 해결은 실패할 수 있음
Du 외(2025년 10월)의 Context Length Alone Hurts LLM Performance Despite Perfect Retrieval은 필요한 근거를 추출하는 능력과 그 근거로 문제를 푸는 능력을 나누어 평가.
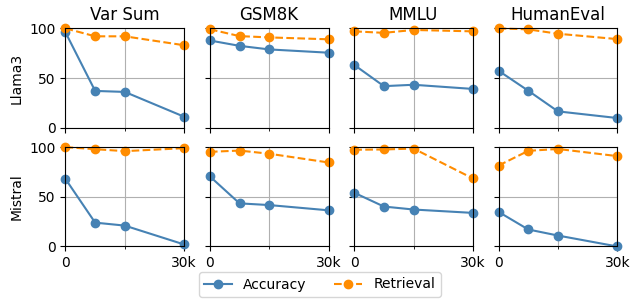
출처: Du 외(2025), 그림 3. CC BY 4.0.
- 실험: 근거와 질문 사이에 에세이 텍스트를 삽입해 입력 길이를 증가. 위 행은 Llama-3-8B-Instruct, 아래 행은 Mistral-v0.3-7B-Instruct
- 열별 과제: 변수 합산, 수학 문장제(GSM8K), 객관식 질의응답(MMLU), 코드 생성(HumanEval)
- 가로축: 전체 입력의 토큰 수. 세로축: 점수(%)
- 주황 점선
Retrieval: 필요한 근거를 원문과 정확히 일치하게 추출한 비율 - 파란 실선
Accuracy: 최종 문제 해결 정확도. 근거 추출 점수가 높게 유지되는 구간에서도 하락 - 적용: 자료에서 정답 근거를 찾았는지와, 그 근거를 사용해 요청을 제대로 수행했는지를 각각 평가
컨텍스트를 줄이고 갱신하기
제거·발췌·요약을 구분
| 방법 | 처리 방식 | 상담 예시 |
|---|---|---|
| 제거 | 이번 판단에 불필요한 내용을 입력에서 제외 | 인사말, 같은 안내문을 반복 조회한 결과 제외 |
| 발췌 | 원문에서 필요한 부분을 그대로 선택 | 전체 강좌 안내에서 수강료·납부 항목만 선택 |
| 요약·압축 | 여러 기록의 의미를 짧은 작업 상태로 정리 | 강좌 선택, 사용자 조건, 확인한 규정, 미확인 사항을 메모로 통합 |
원본 기록은 외부에 보관하고, 다음 호출에 넣을 내용을 구성하는 과정에서 적용.
상담 기록을 작업 메모로 바꾸기
상담이 길어져 다음과 같은 이력이 쌓였다고 가정:
user: 데이터 분석과 생성형 AI 중 어떤 걸 들을지 고민이에요.
assistant: 두 강좌의 내용을 비교해 안내.
user: 생성형 AI로 할게요. 수강료는 얼마인가요?
도구 결과: 전체 강좌 안내문. 생성형 AI 수강료 12만 원.
           분할 납부는 운영팀에 문의.
assistant: 생성형 AI 강좌의 수강료는 12만 원입니다.
user: 두 번에 나누어 낼 수 있나요?
도구 결과: 앞에서 조회한 강좌 안내문과 동일.
다음 답변에는 강좌 비교 과정과 중복 안내문을 제외하고 필요한 상태만 전달:
[고정 지침]
안내문에 근거해 답하고, 확인되지 않은 납부 규정은 추측하지 않는다.

[작업 메모]
현재 목표: 생성형 AI 강좌의 분할 납부 문의에 답변.
선택한 강좌: 생성형 AI. 데이터 분석 강좌는 선택하지 않음.
사용자 조건: 수강료를 두 번에 나누어 내고 싶어 함.
확인된 사실: 수강료 12만 원. 분할 납부는 운영팀 문의 대상.
출처: 강좌 안내문 → 생성형 AI → 수강료·납부 항목.
미확인: 분할 납부 허용 여부, 회차별 금액, 납부 기한.

[이번 질문]
두 번에 나누어 낼 수 있나요?
- 제거한 것: 인사말·강좌 비교 과정·중복 도구 결과
- 남긴 것: 질문의 대상·금액·사용자 조건·근거의 위치·미확인 사항
- 원문을 유지할 것: 금액·날짜·정확한 규정 문구 등 판단을 바꿀 수 있는 조건
새 정보에 따라 메모 갱신
운영팀에서 “이번 강좌는 분할 납부 불가”라는 회신을 받았다면, 기존 메모의 관련 항목을 교체:
확인된 사실: 수강료 12만 원. 이번 생성형 AI 강좌는 분할 납부 불가.
출처: 강좌 안내문의 수강료 항목 + 운영팀의 이번 강좌 확인 회신.
해결된 문의: 두 차례로 나누어 납부할 수 있는지 → 불가.
미확인: 일시 납부 기한.
- “운영팀 확인 필요” 상태를 새 회신에 맞게 갱신하고, 예전 상태를 현재 규정처럼 함께 전달하지 않음
- 질문이 납부 기한으로 바뀌면 해당 항목을 새로 조회. 수강료·분할 납부 관련 이력은 필요한 만큼만 유지
- 반복 절차: 현재 질문 확인 → 자료 선택 → 모델 호출 → 새 결과 확인 → 메모 갱신
오래된 도구 출력을 제외한 연구
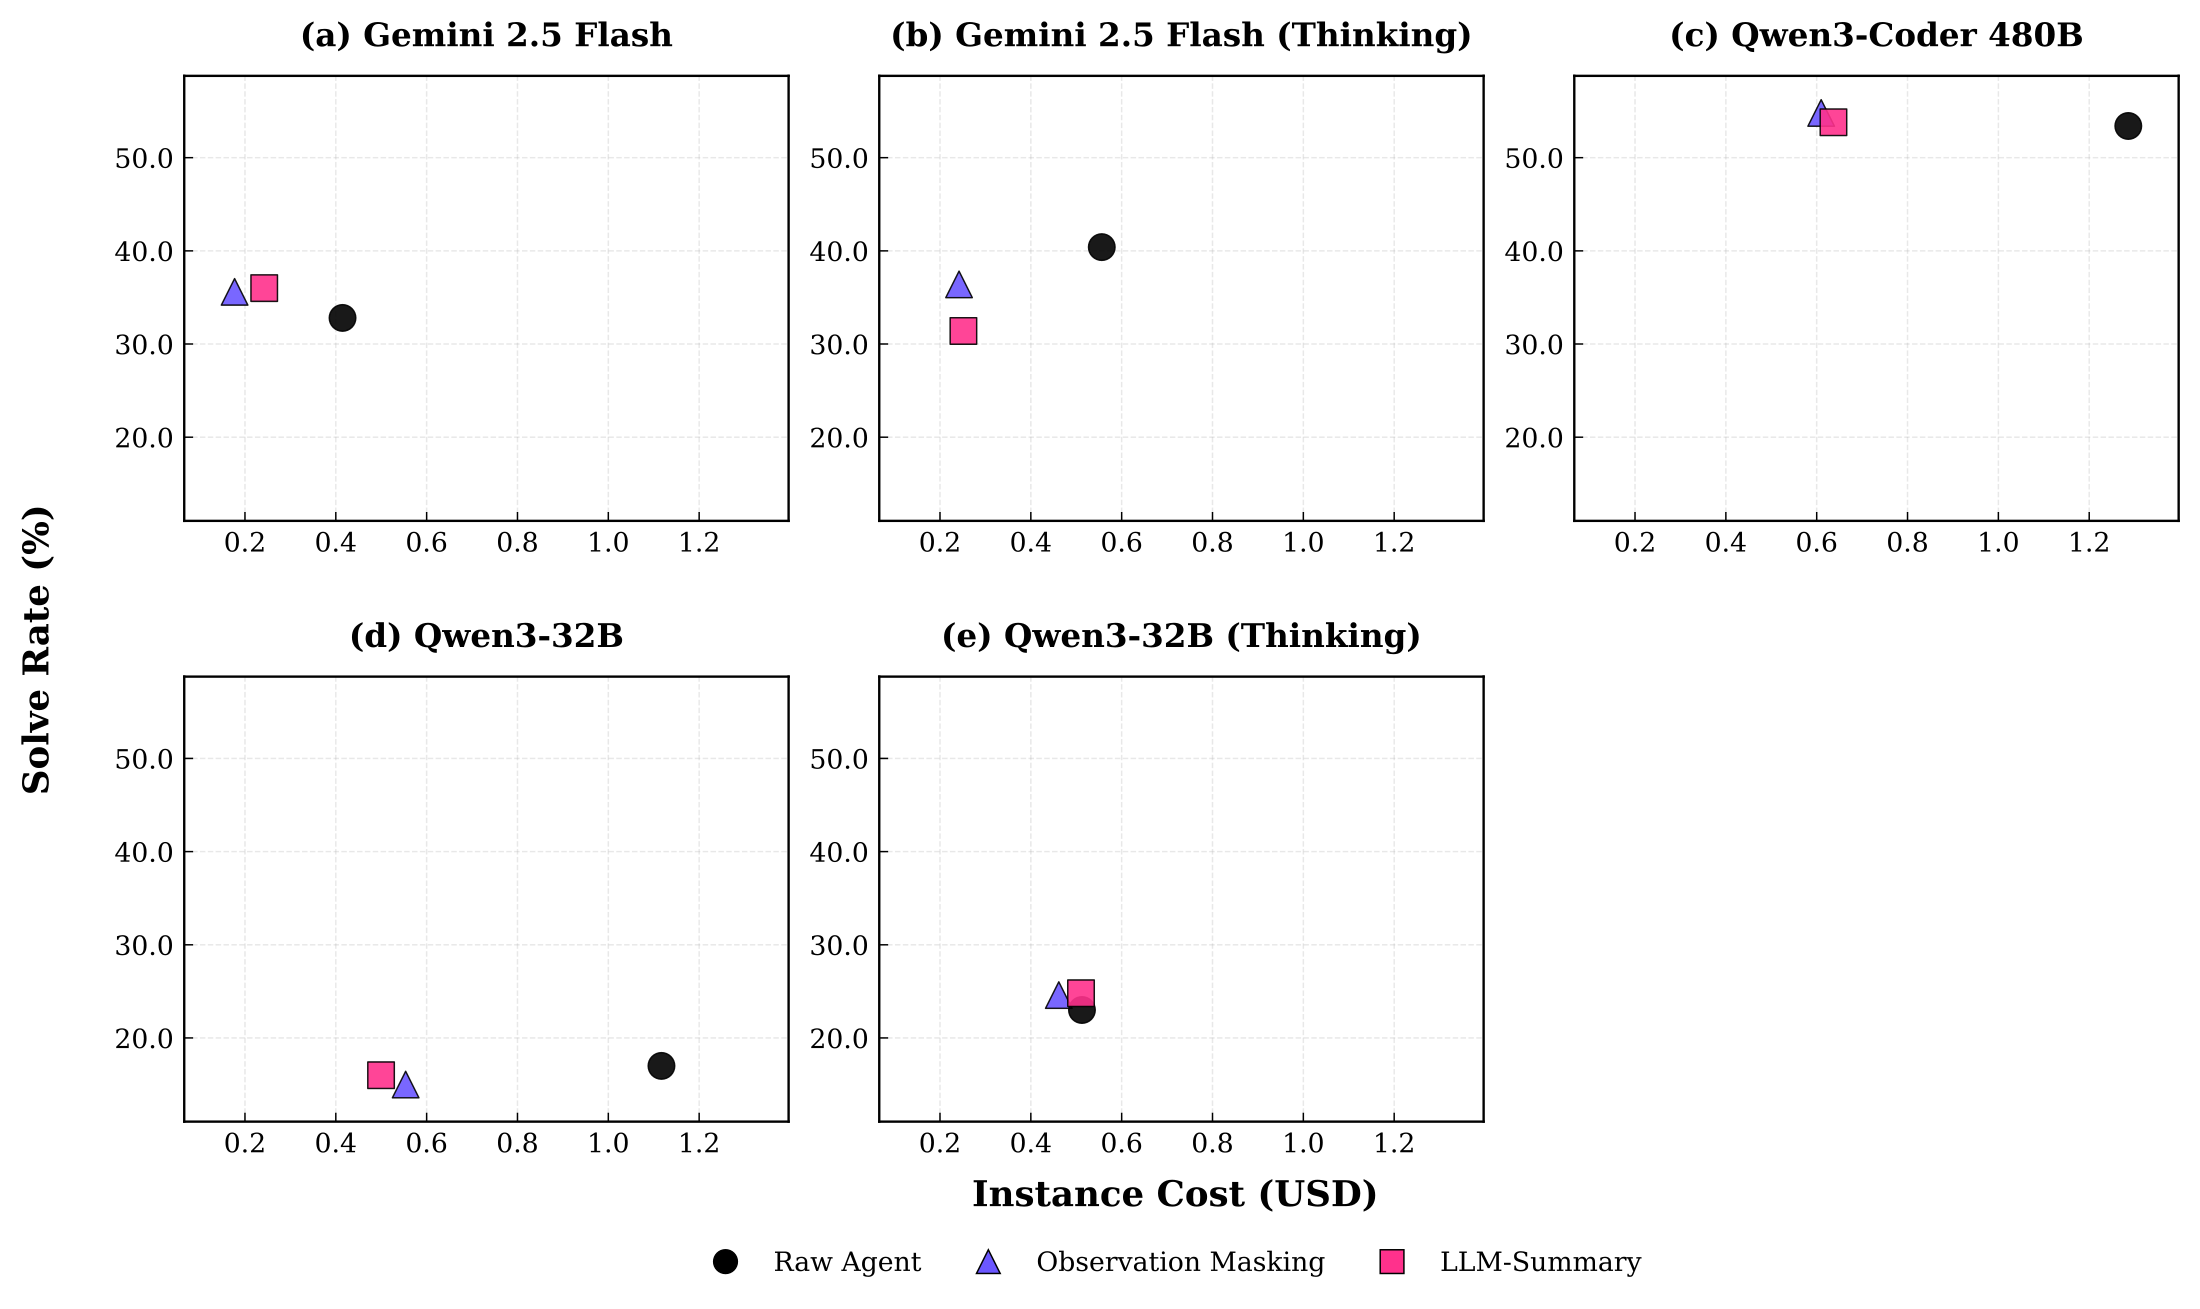
Lindenbauer 외(2025)의 The Complexity Trap은 코딩 에이전트 SWE-agent로 SWE-bench Verified의 문제를 풀며 컨텍스트 관리 방식을 비교.
Raw Agent: 기존 이력을 그대로 유지LLM-Summary: 오래된 이력을 모델로 요약Observation Masking: 최근 일정 범위 밖의 도구 출력을 짧은 표시로 교체하고, 그 단계의 모델 추론과 행동 기록은 유지
출처: Lindenbauer 외(2025), 그림 2. CC BY 4.0.
- 가로축: 과제당 평균 비용(달러). 세로축: 문제 해결률(%). 왼쪽 위일수록 적은 비용으로 높은 해결률
- 검은 원: 원본 유지, 분홍 사각형: 요약, 보라 삼각형: 오래된 도구 출력 제외
- Qwen3-Coder 480B: 원본 유지의 비용 1.29달러·해결률 53.4%에서, 출력 제외의 비용 0.61달러·해결률 54.8%로 변화. 요약은 0.64달러·53.8%
- 상담에 적용하면: 같은 안내문을 반복 조회한 긴 출력은 제외하고, 필요한 규정과 출처를 작업 메모에 남기는 방식
반복 요약에서 고정 규칙 보존
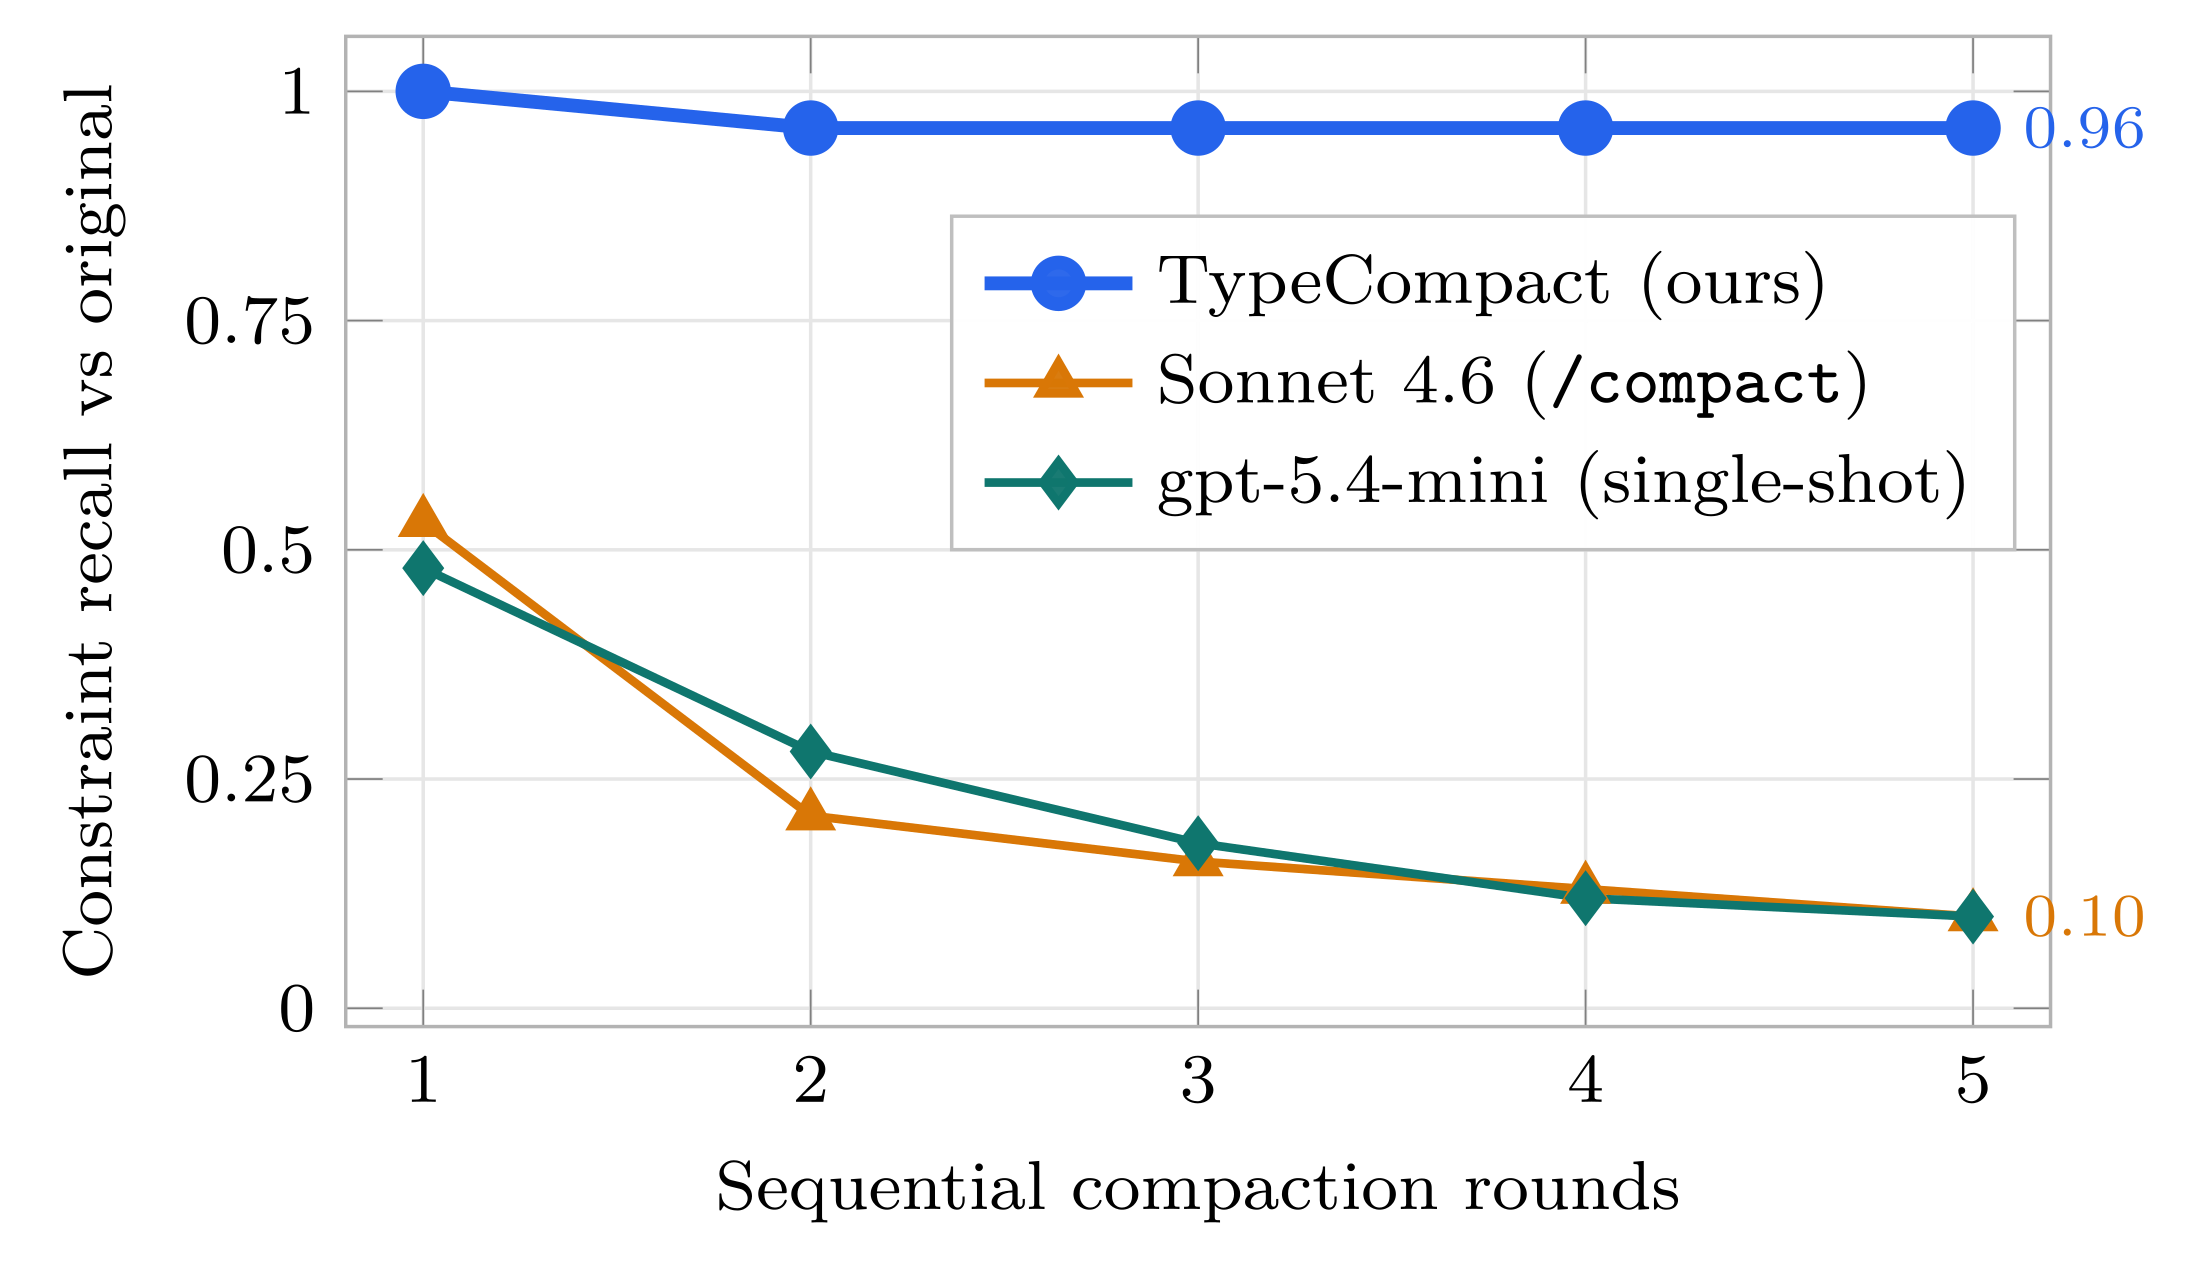
Zerhoudi 외(2026년 8월)의 The Compaction Cliff in Long-Running AI Agent Memory는 에이전트 설정 20개를 반복 압축하며 원래의 제약 규칙이 얼마나 남는지 평가.
출처: Zerhoudi 외(2026), 그림 3.
- 가로축: 순차 압축 횟수. 매회 입력 길이의 50%를 목표로 압축
- 세로축: 처음 규칙 중 남아 있는 규칙의 비율. 1은 모두 보존, 0은 모두 소실
- 주황선: Sonnet 4.6에 Claude Code의
/compact프롬프트를 적용. 한 번 압축 후 53%, 다섯 번 후 10% 보존 - 파란선
TypeCompact: 정보를 규칙·절차·사실·선호·사건 기록 등으로 분류. 규칙과 절차를 원문으로 보존하고 다른 기록을 압축하며, 압축 후 규칙 누락 여부 검사. 다섯 번 후 96% 보존 - 상담 예시의 처리: “확인되지 않은 규정은 추측하지 않는다”는 고정 지침으로 유지하고, 상담의 진행 상황만 갱신·요약. 요약 후에도 강좌·금액·날짜·미해결 질문이 남아 있는지 확인
외부에 저장하고 필요할 때 불러오기
- 현재 컨텍스트: 이번 모델 호출에 직접 전달한 정보
- 외부 메모리: 파일·데이터베이스 등에 저장해 두고 이후 작업에서 다시 불러올 정보
- 저장된 정보도 현재 입력으로 불러와야 모델이 이번 답변의 근거로 활용 가능
| 보관 위치 | 저장할 내용 | 불러올 시점 |
|---|---|---|
| 고정 지침 | 안내문에 근거해 답하는 규칙 | 상담 답변을 생성할 때마다 |
| 작업 메모 | 선택한 강좌·사용자 조건·확인 상태 | 상담을 이어 갈 때 |
| 원문 자료 | 전체 강좌 안내문·운영팀 회신 | 새 질문에 답하거나 정확한 문구를 확인할 때 |
- 예: “두 번에 나눠 낼 수 있나요?”에는 납부 규정과 관련 메모만 사용. 이후 “취소하면 얼마를 돌려받나요?”에는 환불 규정을 추가로 불러와 컨텍스트 갱신
- 메모에는 원문의 문서명·항목·기준 날짜 등 재확인할 단서를 함께 저장
- Anthropic의 구조화된 메모 방식도 목표·진행 상황을 컨텍스트 밖에 저장하고, 다음 작업에서 필요한 메모를 다시 읽는 구성
출처: Anthropic(2025), Effective context engineering for AI agents의 구조화된 메모와 필요 시 정보 조회 설명.
퀴즈
사용자가 '두 번에 나누어 낼 수 있나요?'라고 물었다. 이전의 강좌 선택 기록을 포함하는 주된 이유는?
퀴즈를 풀려면 대화형 기능을 불러와야 합니다.