학습과 증강
학습과 증강의 선택 기준을 구분하고, 외부 정보와 도구를 잘 활용하도록 LLM을 학습하는 방법을 이해한다.
학습과 증강에서 바뀌는 것
- 학습: 데이터를 이용해 모델의 파라미터를 갱신하는 과정. 지식·판단·응답 방식을 개선.
- 미세조정(fine-tuning): 이미 학습한 모델을 특정 과제나 데이터에 맞춰 추가로 학습하는 방법.
- 증강: 응답을 생성할 때 외부 정보·계산·실행 기능을 연결하는 방법. 도구를 호출하거나 결과를 입력에 추가하는 것만으로 모델의 파라미터가 갱신되지는 않음.
| 접근 | 바뀌는 것 | 재고 상담 사례 |
|---|---|---|
| 학습 | 모델의 파라미터 | 현재 수량을 묻는 질문에서 재고 조회를 선택하도록 학습 |
| 증강 | 모델에 제공하는 정보와 외부 기능 | 재고 조회 도구를 연결해 현재 수량 확인 |
| 학습과 증강의 결합 | 도구 활용 능력과 실제 정보 접근 | 조회 방법을 학습한 LLM이 응답 시점의 재고를 조회 |
- 핵심: 현재 재고 수량은 조회하고, 언제 어떻게 조회할지는 학습 가능.
- 학습에서 여러 상품의 수량을 보았더라도, 이후 바뀐 수량은 다시 조회해야 확인 가능.
- 새 도구 연결: 도구 활용 능력을 갖춘 LLM에 도구의 이름·설명·입력 형식 제공.
- 도구 사용을 학습한 LLM도 실제 실행에는 애플리케이션과 외부 도구 필요.
- 언제 학습하고 언제 증강할까?
- 학습: 분류·응답 형식·도구 선택처럼 반복되는 작업의 수행 방식을 개선할 때 사용.
- 증강: 최신 정보나 문서 근거가 필요하거나, 계산·주문 취소처럼 외부 기능을 실행해야 할 때 사용.
증강을 잘하도록 학습하기
- 도구 연결: LLM이 사용할 외부 기능을 준비하는 작업.
- 도구 사용 학습: 연결된 기능을 적절히 선택하고 활용하도록 모델의 파라미터를 갱신하는 작업.
| 학습할 능력 | 재고 상담 사례 |
|---|---|
| 호출 필요성 판단 | 현재 수량 질문에는 조회가 필요하지만, 재고라는 용어 설명에는 조회가 불필요하다고 판단 |
| 도구 선택 | 배송 조회가 아닌 재고 조회 선택 |
| 인자 구성 | 사용자가 말한 상품을 올바른 상품명이나 식별자로 전달 |
| 결과 활용 | 반환된 수량을 읽어 품절 여부와 구매 가능 수량 설명 |
- 학습 자료: 질문·도구 정의·올바른 호출·반환 결과·최종 답변을 포함한 사례로 구성 가능.
- 평가: 최종 답변의 정답 여부뿐 아니라 도구 선택, 인자 정확성, 불필요한 호출, 결과 해석도 함께 확인.
- 실패 원인 구분: 재고 도구가 잘못된 수량을 반환하면 도구나 원천 자료 수정.
Toolformer: 언제 어떤 API를 호출할지 학습
- Toolformer(2023): 계산기·검색 등 외부 API를 언제 호출하고, 어떤 인자를 전달하며, 결과를 어떻게 활용할지 학습한 연구.
- 학습 과정: 소수의 시범 예시를 바탕으로 API 호출 후보를 생성하고, 실제 결과가 이후 토큰 예측에 도움이 되는 호출을 선별해 학습 자료로 사용.
- 의미: 도구를 연결하는 것에 더해, 도구를 활용하는 방식 자체를 학습 가능.
- 학습 후에도 API 호출과 결과 반환은 외부 실행 환경이 담당.
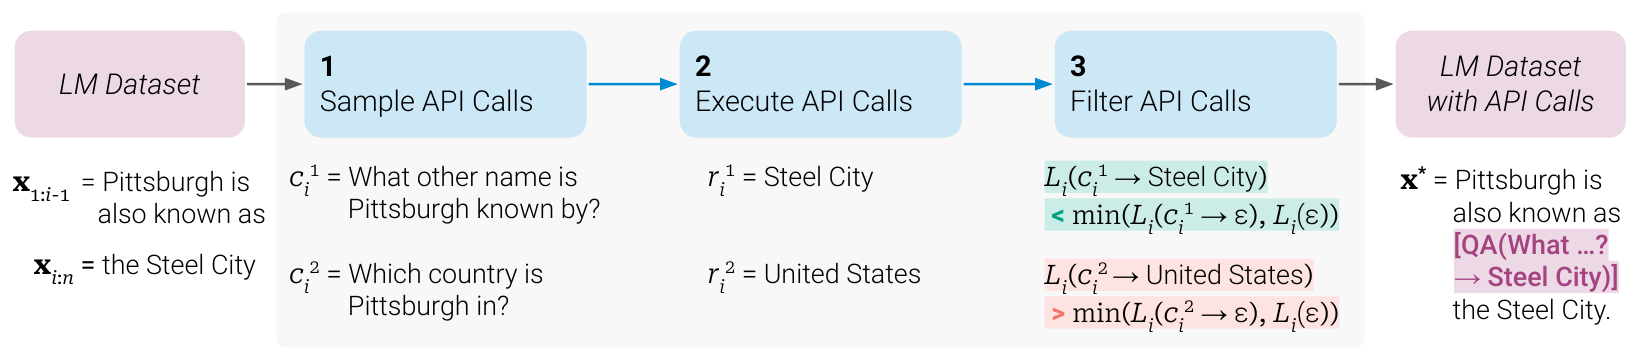
- Toolformer의 학습 과정:
- "Pittsburgh is also known as the Steel City."라는 문장이 있을 때
- "Pittsburgh is also known as"까지만 읽고, 이어지는 "the Steel City"를 예측하는 문제를 만듦
- 호출 후보 생성: LLM이 이 위치에서 도구에 물어볼 질문을 작성. 후보는 “피츠버그의 다른 이름은?”과 “피츠버그는 어느 나라에 있는가?” 등
- 실제 도구 실행: 질문·응답 도구가 각각 “Steel City(강철 도시)”와 “United States(미국)”를 반환.
- 도움이 되는 호출 선별: 각 결과를 읽었을 때 원문의 다음 부분인 “강철 도시”를 더 잘 예측하는지 비교. “강철 도시”라는 결과는 도움이 되어 채택하고, “미국”이라는 결과는 제외. 그림의 초록색은 예측 오차 감소, 빨간색은 증가를 표시.
- 학습 자료 완성: 원문 중간에 채택한 질문과 결과를 삽입. 이렇게 만든 자료로 LLM을 미세조정해, 필요한 위치에서 유용한 도구를 호출하는 방식을 학습.
- "Pittsburgh is also known as the Steel City."라는 문장이 있을 때
- 핵심: 도구가 반환한 답이 사실인지뿐 아니라, 지금 문제에 도움이 되는지를 기준으로 호출을 선별.
- 질문·응답 도구에는 질문을 만들고, 계산기에는 계산식을 작성. 그중 유용한 호출을 골라 도구 사용 학습 사례로 구성.
출처: Toolformer: Language Models Can Teach Themselves to Use Tools
지도 미세조정과 강화학습
- 지도 미세조정: 올바른 호출과 답변 사례를 보고 모델의 파라미터 갱신.
- 강화학습: 도구를 사용하는 과정이나 결과에 보상을 주고, 높은 보상을 얻는 행동의 가능성이 커지도록 파라미터 갱신.
퀴즈
다음 중 증강이 필요한 상황은?
퀴즈를 풀려면 대화형 기능을 불러와야 합니다.