
역할 분담과 SOP
ChatDev·MetaGPT·경매 에이전트와 계획자-생성자-평가자 구조로 역할 기반 멀티 에이전트를 이해하고, 기획자·개발자·리뷰어가 구조화된 문서로 일을 넘기는 파이프라인을 만든다.
- 역할 기반 협업(role-based): 관리자·개발자·검토자 같은 역할을 미리 정하고 정해진 순서로 일을 넘기는 방식(멀티 에이전트 시스템의 협업 전략).
- 표준 작업 절차(Standard Operating Procedure, SOP): 사람의 조직이 일을 처리하는 순서와 산출물 양식. 이를 에이전트 팀에 옮김.
- 핵심 질문: 누가 무엇을 받아서 무엇을 내보내는가. 산출물의 형식이 품질을 좌우.
ChatDev와 MetaGPT
- ChatDev: 개발을 설계·코딩·테스트·문서화 단계로 나누고, 각 하위 과제를 지시자(instructor)와 조수(assistant) 두 에이전트의 대화로 해결하는 채팅 체인(Chat Chain). 예: CEO와 CTO가 언어를 정하고, 프로그래머와 리뷰어가 코드를 검토.
- 출처: Qian 외(2023), Communicative Agents for Software Development
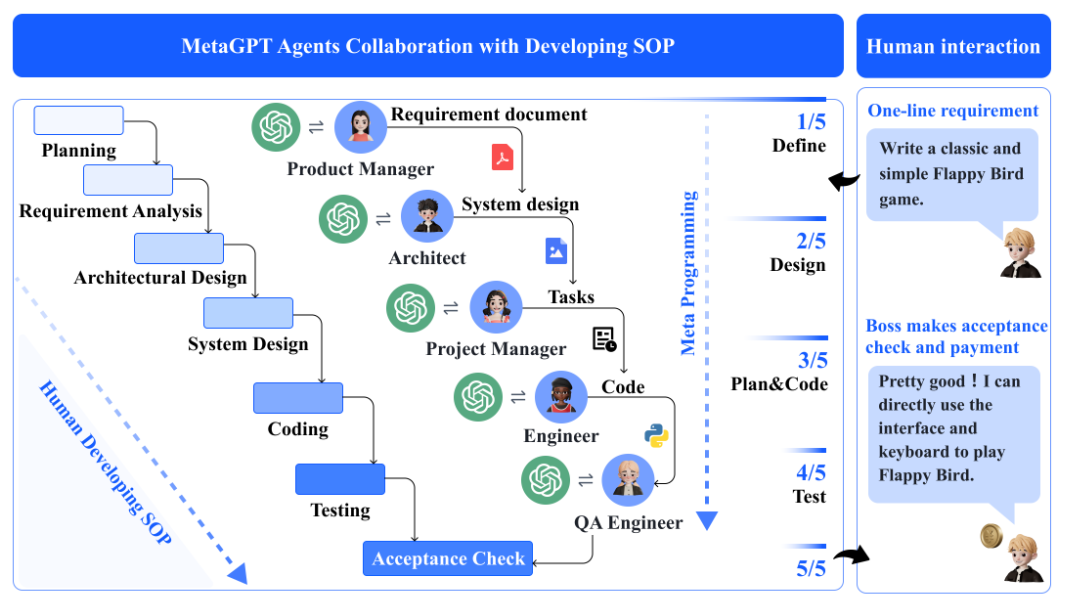
- MetaGPT: 제품 관리자 → 설계자 → 프로젝트 관리자 → 엔지니어 → QA 순서로 소프트웨어 회사의 SOP를 따름.
- 자유 대화 대신 요구사항 문서(PRD)·시스템 설계 같은 구조화된 문서로 통신. 대화는 길어질수록 정보가 왜곡되지만(전화 게임) 양식이 있는 문서는 항목이 빠지지 않음.
- 공유 메시지 풀에 산출물을 게시하고, 각 역할은 필요한 문서만 구독. 엔지니어는 코드를 실행해 오류를 스스로 고침.
- 출처: Hong 외(2023), MetaGPT
경쟁하는 역할: 경매
- AucArena: 예산을 가진 에이전트들이 경매에서 경쟁. 믿음-욕구-의도(Belief-Desire-Intention, BDI) 모델로 행동.
- 믿음: 남은 예산·상대 상황에 대한 판단. 욕구: 목표(이익 극대화 등). 의도: 다음 행동 계획(입찰가, 포기).
- GPT-4가 가장 잘했지만, 사람과 달리 과거 기록을 보여 줘도 개선에 한계.
- 출처: Chen 외(2023), Put Your Money Where Your Mouth Is
계획자-생성자-평가자
- 12주 하네스 엔지니어링의 Anthropic 실험을 역할 관점에서 보기.
- 계획자(planner): 짧은 요청을 제품 명세로 확장. 무엇을·왜에 집중하고 구현 방법은 정하지 않음.
- 생성자(generator): 명세대로 앱을 만듦. 평가자(evaluator): 실행 중인 앱을 직접 조작하며 채점.
- 평가자를 따로 두는 이유: 에이전트는 자기 결과를 후하게 평가함. 별도 평가자를 깐깐하게 조정하는 편이 쉬움.
- 출처: Prithvi Rajasekaran(2026), Harness design for long-running application development
실습: 기획자 → 개발자 → 리뷰어
- 세 역할이 정해진 양식(Pydantic 모델)의 문서로 일을 넘김. MetaGPT를 작게 구현.
- 기획자가 쓴 테스트로 개발자의 코드를 실제 실행해 리뷰어에게 넘김(실행 가능한 피드백).
Mermaid 다이어그램 원문
flowchart LR
    R[요청] --> P[기획자] -->|명세서 Spec| D[개발자] -->|코드 Code| T[테스트 실행]
    T -->|코드 + 테스트 결과| V[리뷰어]
    V -->|승인| F[완료]
    V -->|리뷰 Review| D
대화형 다이어그램을 불러오기 전에는 원문으로 표시됩니다.
!pip install -q openai
from pathlib import Path
from openai import OpenAI

client = OpenAI(
    base_url="https://openrouter.ai/api/v1",
    api_key=Path("openrouter-key.txt").read_text().strip(),
)
model = "openai/gpt-4.1-mini"
act(역할, 입력, 양식): SDK의parse가 Pydantic 모델을 JSON Schema로 바꿔 보내고 응답을 검증함(구조화된 출력). 에이전트는 이력 없이 앞 단계의 문서만 받음.
from pydantic import BaseModel, Field

class Spec(BaseModel):
    function_name: str
    requirements: list[str]
    tests: list[str] = Field(description="참이어야 하는 파이썬 식 5~8개. 예: f('01012345678') == '010-1234-5678'")

class Code(BaseModel):
    code: str

class Review(BaseModel):
    approved: bool
    issues: list[str]

def act(role, content, schema):
    response = client.chat.completions.parse(model=model, response_format=schema, messages=[
        {"role": "system", "content": role}, {"role": "user", "content": content}])
    return response.choices[0].message.parsed

def run_tests(spec, code):
    ns = {}
    try:
        exec(code.code, ns)  # 실습용. 실제로는 샌드박스에서 실행
        ns["f"] = ns[spec.function_name]
        return "\n".join(f"{'통과' if eval(t, ns) is True else '실패'} | {t}" for t in spec.tests)
    except Exception as e:
        return f"실행 오류: {e!r}"
- 주의: 모델이 만든 코드를 그대로 실행하는 것은 위험. 실제로는 9주 코드 실행처럼 샌드박스에서.
spec = act("너는 기획자다. 요청을 명세서로 만든다. 구현 방법은 정하지 않는다.",
           "한국 휴대폰 번호를 '010-1234-5678' 형식으로 통일하는 함수. 잘못된 번호면 None.", Spec)
code = act("너는 파이썬 개발자다. 표준 라이브러리만 쓴다.", spec.model_dump_json(), Code)
report = run_tests(spec, code)
review = act("너는 깐깐한 코드 리뷰어다. 테스트 기댓값이 요구사항과 어긋나도 지적한다.",
             f"[명세서]\n{spec.model_dump_json()}\n[코드]\n{code.code}\n[테스트]\n{report}", Review)
print("\n".join(spec.requirements), report, review, sep="\n")
실행 결과
입력된 전화번호가 한국 휴대폰 번호 형식인지 검사한다.
유효한 번호일 경우 '010-1234-5678' 형식으로 변환한다.
잘못된 번호일 경우 None을 반환한다.
입력값은 숫자 문자열 형태로 받는다.
번호는 010으로 시작하며 총 11자리 숫자여야 한다.
통과 | format_korean_phone_number('01012345678') == '010-1234-5678'
통과 | format_korean_phone_number('010-1234-5678') == '010-1234-5678'
통과 | format_korean_phone_number('0111234567') == None
통과 | format_korean_phone_number('0101234567a') == None
통과 | format_korean_phone_number('010123456') == None
approved=False issues=["함수 반환 타입 선언에 'str or None' 대신 'Optional[str]'를 사용하는 것이 더 명확하고 표준적임.", "명세서에는 입력값이 숫자 문자열 형태라고 명시되어 있으나, 코드와 테스트는 하이픈('-')이 포함된 문자열도 허용하고 있음. 요구사항과 코드가 불일치함.", "'0111234567' 테스트 케이스의 기댓값이 None으로 되어 있으나, 번호 길이가 10자리로, 명세서 조건(11자리)과 일치하지 않아 검사 목적은 맞으나 이름에서 011로 시작한다고 했으므로 헷갈림. 더 명확한 테스트 케이스 필요하다.", "테스트 내 assert 구문에서 'is None'이나 '== None'을 혼용하고 있음. 일관성을 유지해야 함.", '코드 주석이 친절하지만, 함수 내 주요 검증 로직에 대한 예외 처리나 상세 설명이 없고, 에러 발생 시 반환 값 외에 이유를 알 수 없음.', '테스트 코드를 함수 내에 두기보다는 별도의 테스트 파일이나 테스트 함수로 분리하는 것이 좋음.']
- 위 실행(실행마다 달라짐)에서 기획자가 만든 테스트 5개를 코드가 모두 통과했지만 리뷰어는 반려.
- "010으로 시작하는 11자리"는 요청에 없던 기획자의 결정. 이 결정이 테스트와 리뷰의 기준이 됨.
- 리뷰어의 지적은 대부분 타입 표기·주석 같은 사소한 것이고, "
is None과== None을 혼용한다"처럼 테스트(모두== None)와 맞지 않는 지적도 섞임 → 평가자도 틀림. 무엇을 기준으로 승인할지 리뷰어 지시문에 분명히 적어야 함. - 반려되면 리뷰를 개발자에게 넘겨 고치게 하는 루프를 둘 수 있음(횟수 제한 필수).
생각해 볼 점
- 산출물 양식이 곧 SOP. 명세서에 테스트 칸이 없었다면 개발자와 리뷰어는 무엇을 기준으로 판단했을까?
- 오류 전파: 기획자의 테스트 기댓값이 틀리면 개발자는 틀린 기준에 맞춤. 리뷰어에게 "기댓값도 검토하라"고 지시한 이유.
- 평가자가 받는 근거(테스트)의 범위가 곧 검증의 범위. 명세서에 빠진 경우는 아무도 확인하지 않음.
퀴즈
MetaGPT에서 에이전트들이 주로 통신하는 방식은?
퀴즈를 풀려면 대화형 기능을 불러와야 합니다.