멀티 에이전트 설계 패턴
컨텍스트 중심 분해 원칙과 에이전트 스웜·역량 기반·메시지 버스·오케스트레이터-서브에이전트 같은 조율 패턴, 검증 서브에이전트, 에이전트 간 통신 구조를 구분하고, 토론과 합의, 역할 분담과 SOP 방식의 멀티 에이전트 협업을 살펴본다.
- 여러 에이전트가 함께 일하려면 누가 일을 나누고, 누구와 어떻게 메시지를 주고받으며, 결론을 어떻게 내릴지 정해야 함.
- 이 문서에서는 작업 분해 원칙, 조율 패턴, 검증 서브에이전트, 통신 구조, 토론과 합의, 역할 분담의 순서로 살펴봄.
컨텍스트 중심 분해
- 멀티 에이전트 설계에서 가장 중요한 결정: 작업을 에이전트에게 어떻게 나누는가
- 잘못 나누면 조정 오버헤드가 이득을 상쇄
- 핵심: 문제 유형이 아니라 컨텍스트를 기준으로 분해
문제 중심 분해
작업 유형별 에이전트
기능 작성 에이전트 → 테스트 작성 에이전트 → 코드 리뷰 에이전트. 테스트 작성자는 구현 결정의 이유를 모르고, 리뷰어는 탐색·반복 과정을 모름
넘길 때마다 정보가 손실되는 전화 게임
기준 변경
컨텍스트 중심 분해
컨텍스트별 에이전트
기능을 만든 에이전트가 이미 필요한 컨텍스트를 가지므로 테스트까지 담당
컨텍스트를 실제로 격리할 수 있을 때만 분리
- 근거: 계획자·구현자·테스터·리뷰어로 나눈 소프트웨어 개발 실험에서 서브에이전트들이 실제 작업보다 조정에 더 많은 토큰을 씀
| 구분 | 경계 | 예 |
|---|---|---|
| 효과적 | 독립적인 조사 경로 | 아시아와 유럽의 시장 동향을 컨텍스트 공유 없이 병렬 조사 |
| 인터페이스가 깔끔한 별개의 구성 요소 | API 계약을 정해 두고 프런트엔드와 백엔드를 병렬 작업 | |
| 블랙박스 검증 | 테스트를 실행하고 결과만 보고하는 검증자 | |
| 문제 | 같은 작업의 순차 단계 | 한 기능의 계획·구현·테스트는 공유 컨텍스트가 너무 많음 |
| 밀접하게 결합된 구성 요소 | 계속 주고받아야 하는 구성 요소는 같은 에이전트에 | |
| 공유 상태가 필요한 작업 | 이해를 자주 맞춰야 하는 에이전트는 합침 |
- 맥락 공유의 실패 예: 플래피 버드를 "배경"과 "새"로 나눠 맡겼더니 서로 어울리지 않는 결과가 나옴. 하위 에이전트의 행동에 담긴 암묵적 결정이 충돌하지 않게 맥락을 공유해야 함
- 출처: Walden Yan(2025), Don't Build Multi-Agents
- 설계 순서: 작업 분해 → 역할 정의 → 입출력 형식(구조화된 출력) → 순서·종료 조건 → 검증 단계
조율 패턴
- 조율 패턴의 종류: 에이전트 스웜(agent swarm), 역량 기반 시스템(capability-based system), 메시지 버스(message bus) 아키텍처, 오케스트레이터-서브에이전트
- 에이전트 스웜: 중앙 관리자 없이 대등한 에이전트들이 서로 직접 일을 넘기며 협업하는 구조
- 방식: 각 에이전트가 자기 역할과 넘겨줄 상대를 알고, 필요하면 대화의 제어권을 다른 에이전트에게 넘김(handoff). 전체 흐름은 미리 정해지지 않고 상호작용에서 생겨남
- 예: OpenAI의 교육용 프레임워크 Swarm(2024, 이후 Agents SDK로 이어짐). 접수 에이전트가 환불 요청이면 환불 에이전트에게, 기술 문의면 기술 지원 에이전트에게 넘김
- 장점: 관리자 병목이 없고, 에이전트를 추가하기 쉬움
- 한계: 흐름을 예측·추적하기 어렵고, 에이전트끼리 계속 떠넘기거나 끝나지 않을 수 있음
- 역량 기반 시스템: 에이전트마다 자기가 할 수 있는 일(역량)을 공개하고, 작업이 생기면 필요한 역량을 가진 에이전트를 찾아 맡기는 구조
- 방식: 에이전트가 이름·기능·입출력 형식을 담은 명세를 등록 → 작업을 맡기는 쪽이 명세를 보고 적합한 에이전트를 고름. 고전적으로는 작업을 공고하고 입찰받는 계약망 프로토콜(contract net protocol)
- 예: A2A(Agent2Agent) 프로토콜의 에이전트 카드(Agent Card). 에이전트의 기능과 접속 정보를 JSON으로 공개해, 다른 회사가 만든 에이전트도 찾아서 일을 맡길 수 있음
- 장점: 에이전트를 미리 연결해 두지 않아도 되고, 새 역량을 가진 에이전트를 붙이기 쉬움
- 한계: 역량 명세가 부정확하면 엉뚱한 에이전트에게 배정. 어느 에이전트가 무엇을 하는지 전체를 파악하기 어려움
- 메시지 버스 아키텍처: 에이전트들이 공유 통신 계층을 통해 이벤트를 발행(publish)하고 구독(subscribe)하는 구조
- 방식: 에이전트는 관심 있는 주제(topic)를 구독하고, 라우터가 맞는 메시지를 전달. 새 에이전트는 기존 연결을 바꾸지 않고 구독만 하면 관련 작업을 받음
- 예: 보안 운영 자동화. 여러 출처의 경보를 분류 에이전트가 심각도·유형별로 나눠 네트워크 조사 에이전트나 계정 분석 에이전트에 보냄. 조사 에이전트가 추가 정보를 요청하면 정보 수집 에이전트가 처리하고, 결과는 대응 조정 에이전트로 모임
- 적합한 경우: 정해진 순서가 아니라 사건에 따라 흐름이 생기고, 에이전트 종류가 계속 늘어날 시스템
- 한계: 경보 하나가 에이전트 다섯을 거치며 연쇄되면 무슨 일이 있었는지 추적하기 어려움. 라우터가 이벤트를 잘못 분류하거나 놓치면 오류 없이 조용히 실패
- 오케스트레이터-서브에이전트: 리드 에이전트(오케스트레이터)가 계획·위임·종합을 맡고, 서브에이전트가 맡은 하위 작업을 처리해 보고하는 계층 구조
- 방식: 서브에이전트는 하위 작업 하나를 위해 만들어지고, 자기 컨텍스트에서 일한 뒤 압축한 결과만 돌려주고 끝남. 오케스트레이터는 일부 작업을 직접 하기도 함
- 예: Claude Code. 메인 에이전트가 코드 작성·실행을 직접 하면서, 큰 코드베이스 검색이나 독립된 조사는 서브에이전트에게 맡기고 결과만 받음
- 예: 풀 리퀘스트 자동 리뷰. 보안·테스트 범위·코드 스타일·아키텍처 일관성 검사를 각 서브에이전트에 맡기고 오케스트레이터가 리뷰 하나로 종합
- 적합한 경우: 작업 분해가 분명하고 하위 작업끼리 의존이 적을 때
- 한계: 서브에이전트 사이의 정보가 모두 오케스트레이터를 거쳐야 해 병목. 예: 보안 검사에서 찾은 인증 결함이 아키텍처 분석을 바꿔야 해도 전달 과정에서 세부가 빠짐. 명시적으로 병렬화하지 않으면 순서대로 실행돼 비용만 늘고 빨라지지 않음
- 후속 글에서는 생성자-검증자(generator-verifier), 오케스트레이터-서브에이전트, 에이전트 팀(agent teams), 메시지 버스, 공유 상태(shared state)의 다섯 패턴으로 정리
- 출처: Cara Phillips(2026), Multi-agent coordination patterns: Five approaches and when to use them
검증 서브에이전트
- 검증 서브에이전트(verification subagent): 메인 에이전트의 결과를 테스트·검증하는 일만 맡는 전용 에이전트. 분야를 가리지 않고 일관되게 효과가 있는 패턴
- 효과가 있는 이유: 검증에는 최소한의 컨텍스트만 넘기면 됨. 만든 과정의 전체 기록 없이 결과를 블랙박스로 테스트 → 전화 게임 문제를 피함
- Claude Opus 4.5처럼 강한 오케스트레이터는 별도 검증 없이 서브에이전트의 결과를 직접 평가하는 경우가 늘어남. 그래도 검증 서브에이전트가 가치 있는 경우
- 오케스트레이터의 능력이 상대적으로 낮을 때
- 검증에 전용 도구가 필요할 때
- 워크플로에 명시적인 검증 체크포인트가 필요할 때
구현
- 메인 에이전트가 작업 단위를 끝내면, 다음 단계로 가기 전에 검증 서브에이전트를 만들어 세 가지를 넘김
- 검증할 결과물
- 명확한 성공 기준
- 검증용 도구
- 검증자는 왜 그렇게 만들었는지 알 필요 없음. 기준을 만족하는지만 판단
- 예: 코딩 에이전트와 검증 에이전트
- 코딩 에이전트: 파일 읽기·쓰기, 디렉터리 목록 도구로 요구사항을 구현하고 변경한 파일 목록을 반환
- 검증 에이전트: 요구사항과 변경 파일을 받아 ① 기존 테스트가 모두 통과하는지 ② 새 기능이 명세대로 동작하는지 ③ 명백한 오류·보안 문제가 없는지 확인. 테스트 실행·코드 실행·파일 읽기 도구 사용
- 검증 지시문에 "일부가 아닌 전체 테스트를 실행하고, 모두 통과할 때만 통과로 표시"를 명시
- 실패하면 지적된 문제를 요구사항에 덧붙여 다시 구현. 최대 시도 횟수(예: 3회)를 넘으면 실패로 종료
Mermaid 다이어그램 원문
flowchart LR
    R[요구사항] --> C[코딩 에이전트: 구현]
    C --> V[검증 에이전트: 전체 테스트]
    V -->|통과| D[완료]
    V -->|실패| F["문제점을 요구사항에 추가"]
    F -->|최대 3회| C
대화형 다이어그램을 불러오기 전에는 원문으로 표시됩니다.
적용 분야
- 품질 보증: 테스트 스위트 실행, 린트, 스키마로 출력 검증
- 규정 준수: 문서가 정책 요건을 충족하는지, 출력이 규칙에 맞는지 확인
- 출력 검증: 전달 전에 생성 콘텐츠가 명세에 맞는지 확인
- 사실 검증: 별도 에이전트가 생성 콘텐츠의 주장·인용을 확인
성급한 승리 문제
- 검증 서브에이전트의 가장 심각한 실패: 충분히 테스트하지 않고 통과로 표시
- 예: 테스트 한두 개만 실행해 통과하자 성공을 선언
- 완화 방법
- 구체적인 기준: "동작하는지 확인" 대신 "전체 테스트 스위트를 실행하고 실패를 모두 보고"
- 포괄적인 확인: 여러 시나리오와 경계 사례를 요구
- 부정 테스트(negative testing): 실패해야 하는 입력을 넣어 실제로 실패하는지 확인
- 명시적 지시: "통과로 표시하기 전에 반드시 전체 테스트 스위트를 실행". 포괄적 검증을 명시하지 않으면 검증자는 쉬운 길을 택함
커뮤니케이션 구조
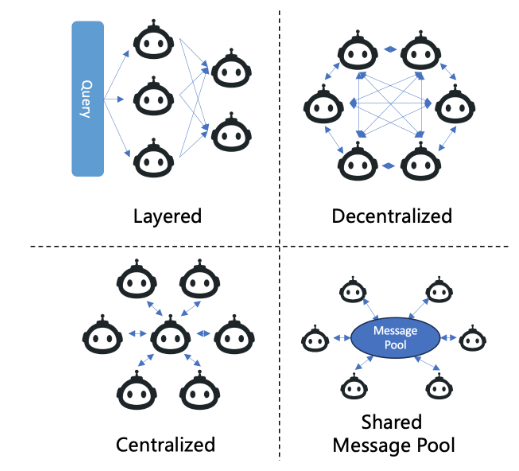
| 구조 | 방식 | 특징 |
|---|---|---|
| 계층(layered) | 같은 계층이나 인접 계층과 주로 통신 | 큰 조직에 적합 |
| 분산(decentralized) | 다대다 직접 통신 | 유연하지만 메시지 수가 에이전트 수의 제곱으로 늘고 종료가 어려움 |
| 중앙 집중(centralized) | 관리자를 거쳐 통신 | 이해·디버깅이 쉽지만 관리자가 병목 |
| 공유 메시지 풀(shared message pool) | 모두 게시하고 필요한 것만 구독 | 직접 대화 없이 산출물 공유 |
협업 유형
| 유형 | 설명 | 예 |
|---|---|---|
| 협력(cooperative) | 같은 목표를 위해 정보를 교환 | 조사 시스템의 서브에이전트들 |
| 토론(debate) | 각자 관점을 내고 방어해 더 나은 답을 찾음 | 아래의 토론과 합의 |
| 경쟁(competitive) | 각자 자기 목표를 추구 | 아래의 경매, 협상 |
출처: Guo 외(2024), Large Language Model based Multi-Agents: A Survey of Progress and Challenges
토론과 합의
- 멀티 에이전트 토론(multiagent debate): 여러 에이전트가 각자 답한 뒤 서로의 답과 근거를 보고 자기 답을 고치는 과정을 반복해 합의에 이르는 방법.
- 8주 추론 전략의 자기 일관성(여러 답 + 다수결)에 "서로 보고 고치기"를 더한 것.
Multiagent Debate
- 절차: ① 각자 독립적으로 답함 → ② 답이 다르면 다른 에이전트들의 답을 보여 주고 자기 답을 개선하게 함 → ③ 합의하거나 정한 라운드가 끝나면 중단.
- 같은 모델의 인스턴스 여럿을 API로만 써도 됨. 실험은 에이전트 3개, 2라운드(gpt-3.5-turbo).
- 결과: 산술 67.0% → 81.8%, GSM8K 77.0% → 85.0%(단일 → 토론). 인물 약력 생성의 환각도 줄어듦.
Mermaid 다이어그램 원문
flowchart LR
    Q[질문] --> A1[에이전트 1 답]
    Q --> A2[에이전트 2 답]
    Q --> A3[에이전트 3 답]
    A1 & A2 & A3 --> R["라운드 2: 서로의 답을 보고 수정"]
    R --> C{합의?}
    C -->|예| F[최종 답]
    C -->|아니오| R
대화형 다이어그램을 불러오기 전에는 원문으로 표시됩니다.
출처: Du 외(2023), Improving Factuality and Reasoning in Language Models through Multiagent Debate
ChatEval과 Corex
- ChatEval: 3주 LLM 심판이 순서 등 내용과 무관한 요인에 흔들리는 문제를 여러 심판의 토론으로 보완. 심판마다 다른 역할(일반 대중, 비평가, 심리학자 등)을 주고 토론 후 다수결·평균. 단일 심판보다 사람의 판단과 잘 일치하고, 같은 역할을 반복하면 효과가 줄어듦 → 역할의 다양성이 중요.
- 출처: Chan 외(2023), ChatEval
- Corex: 다수결은 다수가 틀리면 오답이 이기고, 참여자가 많을수록 비싸다는 문제를 지적. 세 가지 방식을 제안.
- 토론(Discuss): 두 팀으로 나눠 토론, 답이 다르면 심판이 결론.
- 리뷰(Review): 한 에이전트가 풀이(코드)를 내면 다른 에이전트들이 차례로 검토하고 고침.
- 검색(Retrieve): 각자 푼 풀이 중 풀이와 답이 가장 충실하게 맞는 것을 고름.
- 출처: Sun 외(2023), Corex
토론인가 다수결인가
- 토론의 이득을 "여러 답의 다수결"과 "서로 보고 고치기"로 나눠 측정한 연구.
- 7개 벤치마크에서 이득의 대부분은 다수결만으로 설명됨. 대부분의 경우 토론 없는 다수결이 토론과 비슷한 성능.
- 이론: 토론을 확률 과정으로 보면 정답에 대한 에이전트의 믿음이 마팅게일(martingale)을 이룸 → 토론만으로는 기대 정답률이 오르지 않음.
- 믿음 갱신을 "수정" 쪽으로 기울이는 개입을 넣으면 토론 효과가 커짐.
- 출처: Choi, Zhu, Li(2025), Debate or Vote: Which Yields Better Decisions in Multi-Agent Large Language Models?
토론의 위험
- 같은 모델끼리는 같은 편향을 공유 → 모두 같은 오답을 내면 다수결로도 토론으로도 못 고침.
- 동조(conformity): 맞는 답을 낸 에이전트가 다수의 오답에 설득될 수 있음.
- 비용: 에이전트 수 × 라운드 수만큼 호출. 같은 예산으로 단일 에이전트 다수결과 비교해야 공정.
- 그래서 다른 모델·다른 역할을 섞거나, 코드 실행 같은 외부 근거로 검증함.
역할 분담과 SOP
- 역할 기반 협업(role-based): 관리자·개발자·검토자 같은 역할을 미리 정하고 정해진 순서로 일을 넘기는 방식.
- 표준 작업 절차(Standard Operating Procedure, SOP): 사람의 조직이 일을 처리하는 순서와 산출물 양식. 이를 에이전트 팀에 옮김.
- 핵심 질문: 누가 무엇을 받아서 무엇을 내보내는가. 산출물의 형식이 품질을 좌우.
ChatDev와 MetaGPT
- ChatDev: 개발을 설계·코딩·테스트·문서화 단계로 나누고, 각 하위 과제를 지시자(instructor)와 조수(assistant) 두 에이전트의 대화로 해결하는 채팅 체인(Chat Chain). 예: CEO와 CTO가 언어를 정하고, 프로그래머와 리뷰어가 코드를 검토.
- 출처: Qian 외(2023), Communicative Agents for Software Development
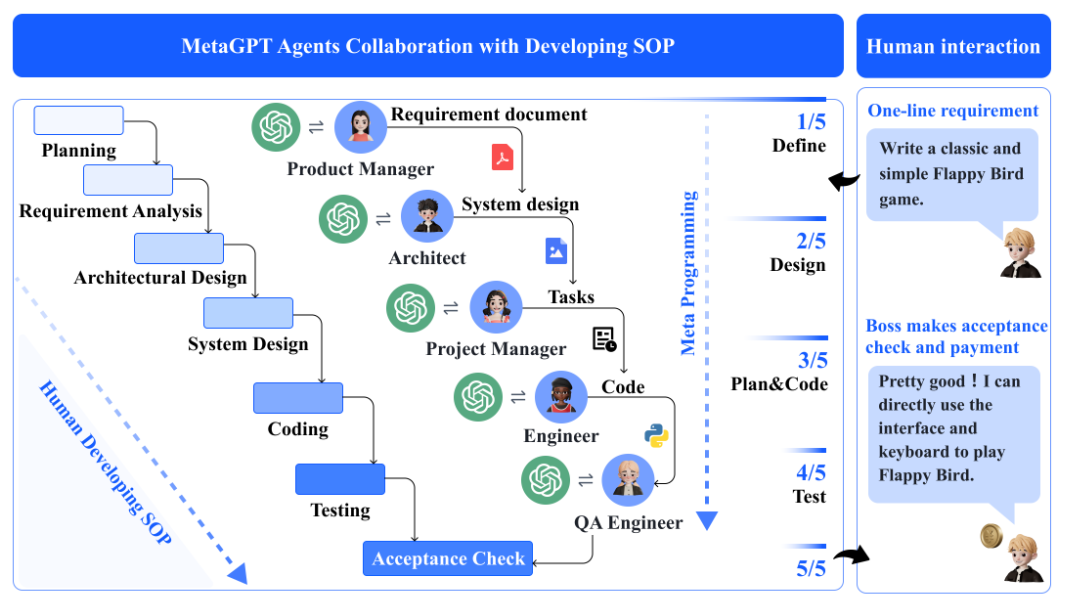
- MetaGPT: 제품 관리자 → 설계자 → 프로젝트 관리자 → 엔지니어 → QA 순서로 소프트웨어 회사의 SOP를 따름.
- 자유 대화 대신 요구사항 문서(PRD)·시스템 설계 같은 구조화된 문서로 통신. 대화는 길어질수록 정보가 왜곡되지만(전화 게임) 양식이 있는 문서는 항목이 빠지지 않음.
- 공유 메시지 풀에 산출물을 게시하고, 각 역할은 필요한 문서만 구독. 엔지니어는 코드를 실행해 오류를 스스로 고침.
- 출처: Hong 외(2023), MetaGPT
경쟁하는 역할: 경매
- AucArena: 예산을 가진 에이전트들이 경매에서 경쟁. 믿음-욕구-의도(Belief-Desire-Intention, BDI) 모델로 행동.
- 믿음: 남은 예산·상대 상황에 대한 판단. 욕구: 목표(이익 극대화 등). 의도: 다음 행동 계획(입찰가, 포기).
- GPT-4가 가장 잘했지만, 사람과 달리 과거 기록을 보여 줘도 개선에 한계.
- 출처: Chen 외(2023), Put Your Money Where Your Mouth Is
계획자-생성자-평가자
- 12주 하네스 엔지니어링의 Anthropic 실험을 역할 관점에서 보기.
- 계획자(planner): 짧은 요청을 제품 명세로 확장. 무엇을·왜에 집중하고 구현 방법은 정하지 않음.
- 생성자(generator): 명세대로 앱을 만듦. 평가자(evaluator): 실행 중인 앱을 직접 조작하며 채점.
- 평가자를 따로 두는 이유: 에이전트는 자기 결과를 후하게 평가함. 별도 평가자를 깐깐하게 조정하는 편이 쉬움.
- 출처: Prithvi Rajasekaran(2026), Harness design for long-running application development
퀴즈
모든 에이전트가 메시지를 게시하고 필요한 메시지만 구독해서 읽는 통신 구조는?
퀴즈를 풀려면 대화형 기능을 불러와야 합니다.