
키워드 검색
TF-IDF와 BM25가 검색어에 가중치를 주는 원리를 이해하고, 마인드몰 안내서에서 질문과 일치하는 청크를 찾는다.
- 검색기(retriever)는 질문에 관련된 청크를 찾아 순서대로 돌려줌. 키워드 검색은 질문과 청크에 같은 단어나 토큰이 있는지 보고 점수를 매김.
- 단어마다 차원을 하나씩 두면 한 청크에서 대부분의 값은 0. 이처럼 일부 차원만 값이 있어 희소 검색(sparse retrieval)이라고 부름.
청크와 토큰
앞 실습에서 읽은 안내서(guide)의 각 문단에 절 제목을 붙임. 검색할 때 문단 안의 단어와 제목의 단어를 함께 사용.
def chunk_with_heading(text):
    chunks = []
    for section in text.split("\n## ")[1:]:  # 머리말 제외
        title, body = section.split("\n", 1)  # 첫 줄은 절 제목
        chunks += [f"[{title}] {p.strip()}" for p in body.split("\n\n") if p.strip()]
    return chunks

chunks = chunk_with_heading(guide)
len(chunks)
22
토큰화: 한국어는 조사와 어미가 붙어 "반품"과 "반품하면"이 다른 단어가 됨. 여기서는 어절을 두 글자씩 겹쳐 자르는 바이그램(bigram)으로 부분 일치를 잡음. 형태소 분석기를 써도 됨.
def tokenize(text):  # 어절마다 두 글자씩 겹쳐 자름
    tokens = []
    for word in text.split():
        tokens += [word[i:i + 2] for i in range(max(1, len(word) - 1))]
    return tokens

tokenize("반품하면 배송비")
['반품', '품하', '하면', '배송', '송비']
역 인덱스
chunks[7]을 열면 7번 청크에 어떤 단어가 있는지 알 수 있음. 검색할 때는 반대로 ‘배송’이라는 토큰을 보고 이 토큰이 들어 있는 청크 번호를 찾아야 함.- 역 인덱스(inverted index): 이 방향의 조회를 위해 토큰마다 청크 번호 목록을 미리 저장한 구조.
from collections import defaultdict

postings = defaultdict(set)
for chunk_id, chunk in enumerate(chunks):
    for token in tokenize(chunk):
        postings[token].add(chunk_id)  # 같은 청크에서 반복된 토큰은 한 번만 등록

sorted(postings["배송"])
[2, 3, 6, 7, 8, 10, 15]
‘배송’은 7개 청크에, ‘제주’는 7번 청크 하나에 등장. 두 토큰을 모두 포함해야 한다면 두 목록의 교집합을 구함.
sorted(postings["제주"] & postings["배송"])
[7]
검색할 때는 22개 청크를 다시 읽는 대신 질문에 나온 토큰의 목록만 조회. 위 예시는 청크 번호만 저장하지만, 검색 엔진은 토큰의 출현 횟수나 위치도 저장할 수 있음. 횟수는 관련도 점수에, 위치는 두 단어가 차례로 붙어 있는지 확인하는 구문 검색에 쓰임.
랭킹
- 후보가 여럿이면 TF-IDF나 BM25 같은 기준으로 순위를 매김.
TF-IDF
- 단어 빈도(TF): 한 청크 안에서 토큰이 나온 횟수. 청크 d에서 토큰 t가 나온 횟수를 ft,d
- 문서 빈도(DF): 그 토큰을 한 번이라도 포함한 청크의 수. 이 토큰이 있는 청크 수를 nt. (DF가 높을수록 토큰의 중요성이 낮아짐)
- 역문서 빈도(IDF): 여러 청크에 두루 나오는 토큰의 가중치를 낮춤.
- 전체 청크 수를 N
토큰 하나의 가중치:
TF-IDF(t,d)=ft,dln(ntN)질문에 맞는 청크의 순위를 매기는 한 가지 방법은 질문 토큰의 가중치를 더하는 것. q는 질문을 토큰화한 목록이며, 색인에 없는 토큰은 합에서 제외.
ScoreTF-IDF(q,d)=t∈q∑TF-IDF(t,d)안내서 22개 청크에서 ‘제주’와 ‘배송’을 비교. 아래는 위 바이그램으로 센 값이며 IDF에는 자연로그를 사용.
| 토큰 | 7번 청크 안의 횟수(TF) | 이 토큰이 있는 청크 수(DF) | IDF | 7번 청크의 TF-IDF |
|---|---|---|---|---|
| 제주 | 1 | 1 | 3.09 | 3.09 |
| 배송 | 5 | 7 | 1.15 | 5.73 |
‘제주’는 한 번만 나와도 희귀해서 가중치가 큼. ‘배송’은 한 번당 가중치는 작지만 이 청크에서 다섯 번 반복되어 최종 가중치가 더 큼.
BM25
- BM25(Best Matching 25)는 질문에 들어 있는 각 토큰이 청크에 얼마나 잘 맞는지 점수를 구해 더함. 드문 검색어의 일치에 큰 가중치를 주고, 반복 횟수와 청크 길이도 반영.
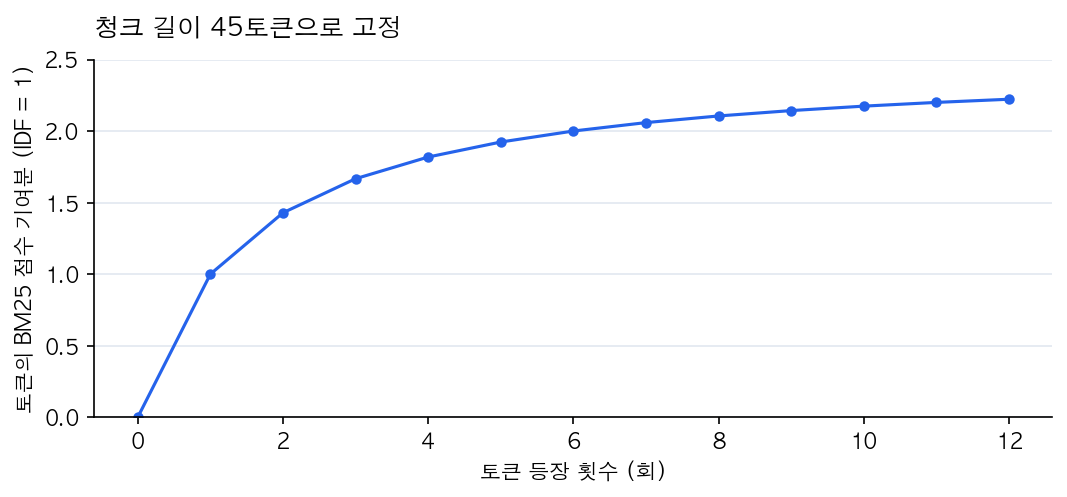
- 빈도 포화. 토큰이 반복될수록 추가 점수가 작아짐. 이미 여러 번 나온 단어는 한 번 더 나와도 새로운 단서가 적기 때문.
- k1이 작을수록 반복에 따른 점수가 빨리 포화 (기본값 k1=1.5)
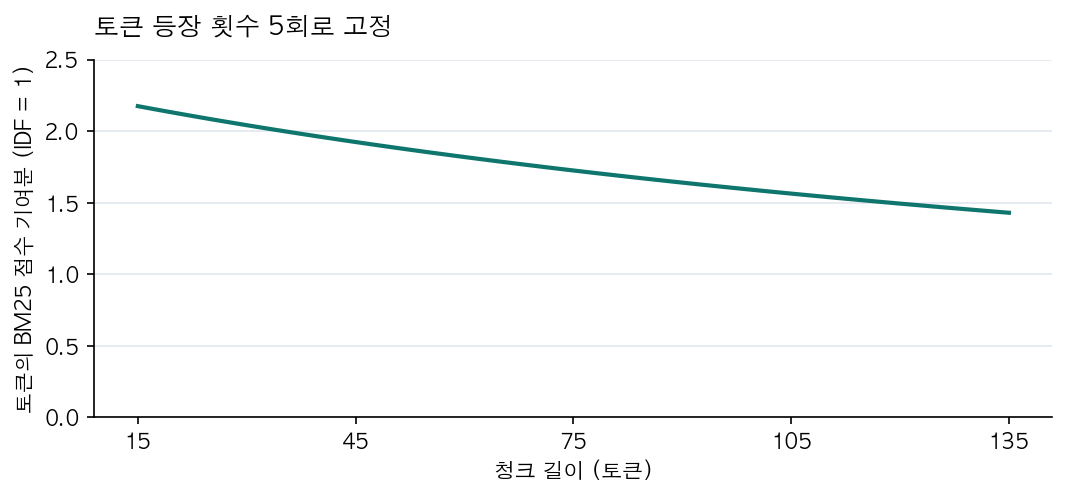
- 길이 보정. 다른 조건이 같을 때 짧은 청크에서 토큰의 점수가 더 큼. 전체 청크의 평균 길이를 기준으로, 긴 청크에 단어가 더 자주 나올 기회를 보정.
- ∣d∣: 청크의 토큰 수
- Lˉ: 전체 청크의 평균 토큰 수
- b가 클수록 청크 길이를 강하게 보정 (기본값 b=0.75)
!pip install -q rank_bm25
import numpy as np
from rank_bm25 import BM25Okapi

bm25 = BM25Okapi([tokenize(c) for c in chunks])  # 청크마다 토큰 목록으로 색인

def search_bm25(query, k=3):  # 상위 k개의 (번호, 점수). 점수 0은 제외
    scores = bm25.get_scores(tokenize(query))
    top = np.argsort(-scores)[:k]
    return [(int(i), round(float(scores[i]), 2)) for i in top if scores[i] > 0]

search_bm25("제주도 배송비")
[(7, 8.39), (10, 3.27), (15, 2.4)]
- 1위인 7번 청크는 제주도 추가 배송비를 다룬 배송 절의 문단. 7번 청크는 69토큰, 전체 평균은 45토큰. ‘제주도 배송비’에서 만든 ‘제주’, ‘주도’, ‘배송’, ‘송비’의 점수를 위 식으로 더하면 약 8.39로, 실습 결과와 일치.
데이터베이스와 검색 엔진에서의 구현
- 전문 검색(full-text search): 본문과 검색어를 토큰 단위로 분석해 조건에 맞는 행을 찾는 기능.
- 보통 토큰마다 해당 행의 목록을 저장하는 역 인덱스로 검색 속도를 높임.
- 부가적 기능들:
- 여러 검색어를 조합(예: ‘제주’와 ‘배송’을 모두 포함)
- 특정 구문 찾기(예: ‘추가 배송비’가 이 순서로 붙어서 등장)
- 결과를 관련도순으로 정렬
| 제품 | 기본 기능 | 선택 기능 |
|---|---|---|
| PostgreSQL | 내장 전문 검색 | 유사 문자열 검색(pg_trgm), BM25(pg_search) |
| SQLite | — | FTS5 전문 검색(빌드에 따라 내장) |
| MySQL (InnoDB) | FULLTEXT 전문 검색 |
한국어 등에 쓰는 ngram 파서 |
| SQL Server | — | Full-Text Search 선택 설치 |
| Oracle Database | — | Oracle Text 전문 검색 |
| Elasticsearch | 전문 검색과 BM25 순위 계산 | 한국어 형태소 분석(analysis-nori) |
제품별 색인 구조와 검색 문법
부분 문자열을 자주 찾는다면 SQLite FTS5에 tokenize='trigram'을 지정해 연속 세 글자를 역 인덱스로 만들 수 있음. 이 가상 테이블에서는 LIKE '%배송비%' 조건도 ‘배송비’ 토큰으로 후보 행을 좁힌 뒤 원래 패턴을 확인. FTS5 트라이그램 토크나이저
- PostgreSQL:
to_tsvector로 본문을 정규화하고 GIN 인덱스를 만들면 검색어가 들어 있는 행을 빠르게 찾을 수 있음. 검색 조건은tsquery로 표현하고@@로 대조. 철자가 비슷한 문자열을 찾으려면 pg_trgm을, BM25 순위가 필요하면 ParadeDB의 pg_search를 사용. - SQLite: FTS5가 빌드에 포함되어 있으면 바로 쓰고, 별도 모듈로 빌드했다면 확장을 로드.
CREATE VIRTUAL TABLE docs USING fts5(body)로 만든 가상 테이블은 토큰마다 행 번호(rowid)를 기록. 앞 실습의 바이그램을 공백으로 구분해 저장하면WHERE docs MATCH '제주 AND 배송'으로 두 토큰이 모두 있는 행을 찾을 수 있음. - MySQL (InnoDB): 전문 인덱스에 단어별 문서 ID와 단어의 위치를 저장하고,
MATCH(body) AGAINST(...)로 검색. 인덱스를 만들 때 내장 ngram 파서를 선택하면 한국어 텍스트를 일정한 글자 수 단위로 나눌 수 있음. - SQL Server: Full-Text Search는 언어별로 단어를 분리해 각 단어가 나온 문서 ID를 색인.
CONTAINS로 특정 단어나 구문을 포함하는 행을 검색. - Oracle Database: Oracle Text의
CTXSYS.CONTEXT인덱스는 토큰마다 해당 토큰이 나온 행 목록을 저장.CONTAINS로 텍스트 열을 검색. - Elasticsearch: Lucene 기반 역 인덱스에
text필드에서 추출한 토큰과 문서 ID를 저장.match질의는 검색어도 토큰으로 나누어 문서를 찾고, 기본적으로 BM25 점수순으로 결과를 반환. Nori 플러그인을 추가하면 한국어 형태소 단위로 분석할 수 있음.
퀴즈
같은 청크에 두 토큰이 한 번씩 나온다면, 기본 TF-IDF가 더 큰 토큰은?
퀴즈를 풀려면 대화형 기능을 불러와야 합니다.