컨텍스트 실패
컨텍스트가 길어지거나 섞일 때 생기는 실패 6가지(부패·불안·오염·주의 분산·혼동·충돌)의 원인과 양상을 정리한다.
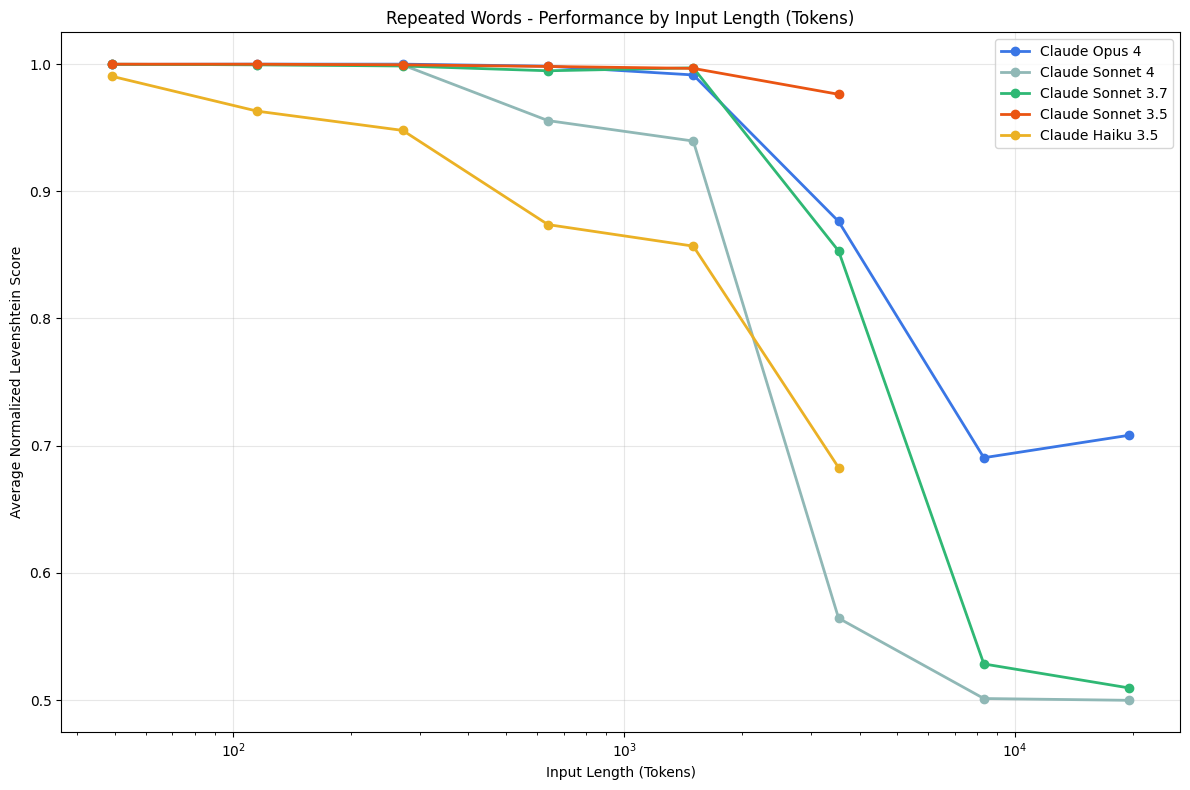
컨텍스트 부패(context rot)
- 컨텍스트 길이가 증가함에 따라 성능이 저하
- 출처: Hong·Troynikov·Huber(2025), Context Rot: How Increasing Input Tokens Impacts LLM Performance (Chroma 기술 보고서).
- 18개 LLM을 평가. 단어를 그대로 따라 쓰는 단순 과제에서도 입력이 길어지면 성능이 떨어짐.
- 저하 양상은 모델·과제마다 고르지 않음.
컨텍스트 불안(context anxiety)
- LLM이 대화나 작업 맥락이 길어질수록 "이제 맥락 창이 부족하다"고 판단해 답변 품질이 떨어지거나, 작업을 너무 빨리 마무리하려는 현상
- 출처: Cognition(2025), Rebuilding Devin for Claude Sonnet 4.5: Lessons and Challenges.
- 자기 컨텍스트 창의 크기를 의식하는 모델에서 관찰. 실제로는 여유가 있는데도 창의 끝이 가깝다고 보고 작업을 줄이거나 미완성으로 남김.
- 주요 양상
- 이전 지시나 중요한 제약을 놓치거나, 최근 메시지에 과도하게 끌림
- 작업을 성급히 끝냄
- 세부 검토, 테스트, 검증 단계를 생략함
- 일관성이 약해짐
- 대처 방법
- 긴 작업을 단계별로 나누어 따로 처리
- 중요한 요구사항은 요약해서 반복 제공
- "아직 마무리하지 말고 검토/테스트까지 수행하라"처럼 작업 절차를 지정
- 긴 대화는 중간에 구조화된 요약을 만들고 새 세션에서 이어가기
- 문서·코드·결정사항은 대화창이 아니라 파일이나 저장소에 남기기
- 체크리스트로 누락 사항을 점검하게 하기
컨텍스트 오염(context poisoning)
- 잘못된 사실이 컨텍스트에 들어간 뒤 모델이 계속 참조
- 오염의 예: Sinha 외(2025), The Illusion of Diminishing Returns: Measuring Long Horizon Execution in LLMs.
- 실험: 이전 턴들의 assistant 답 중 일부를 일부러 틀린 답으로 바꿔 넣고(0-100%), 이후 턴의 정확도를 측정.
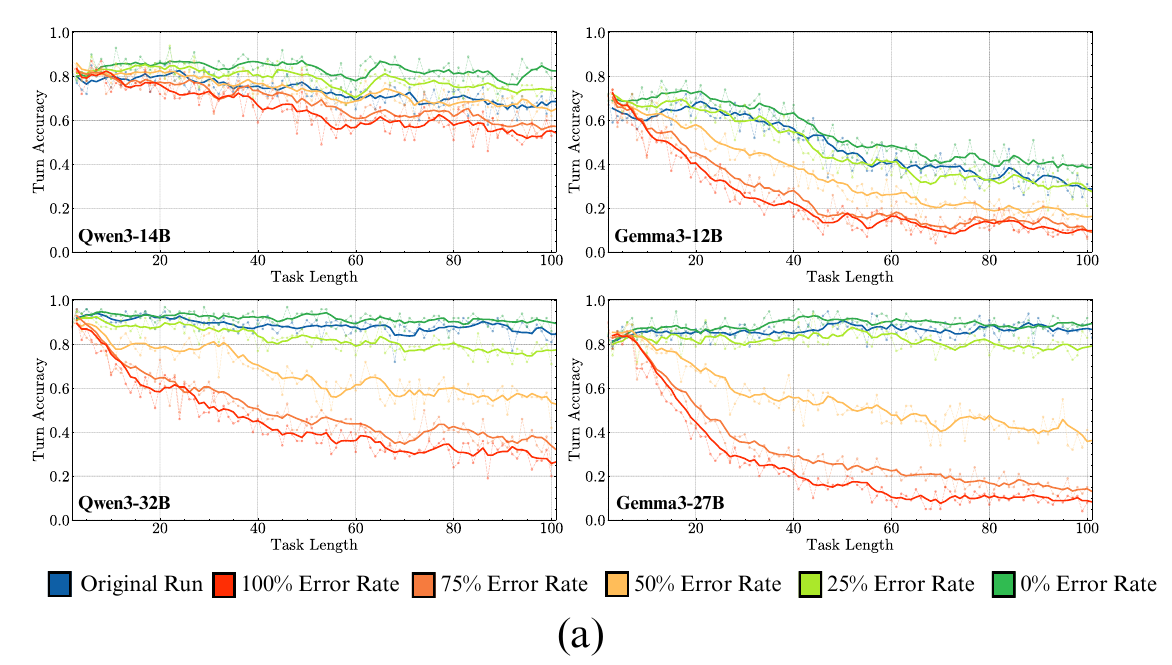
- 오류를 많이 심을수록 정확도가 빨리, 크게 떨어짐.
- 파랑(Original Run): 이력을 조작하지 않은 원래 실행. 모델이 실제로 틀린 답이 이력에 그대로 쌓임.
- 초록(0%): 앞선 턴의 assistant 답을 모두 정답으로 바꾼 이력. 컨텍스트에 오류가 없음.
- 빨강(100%): 앞선 턴의 assistant 답을 모두 오답으로 바꾼 이력.
- 앞선 턴의 오류가 많을 수록, 대화가 길 수록 정확도가 떨어짐
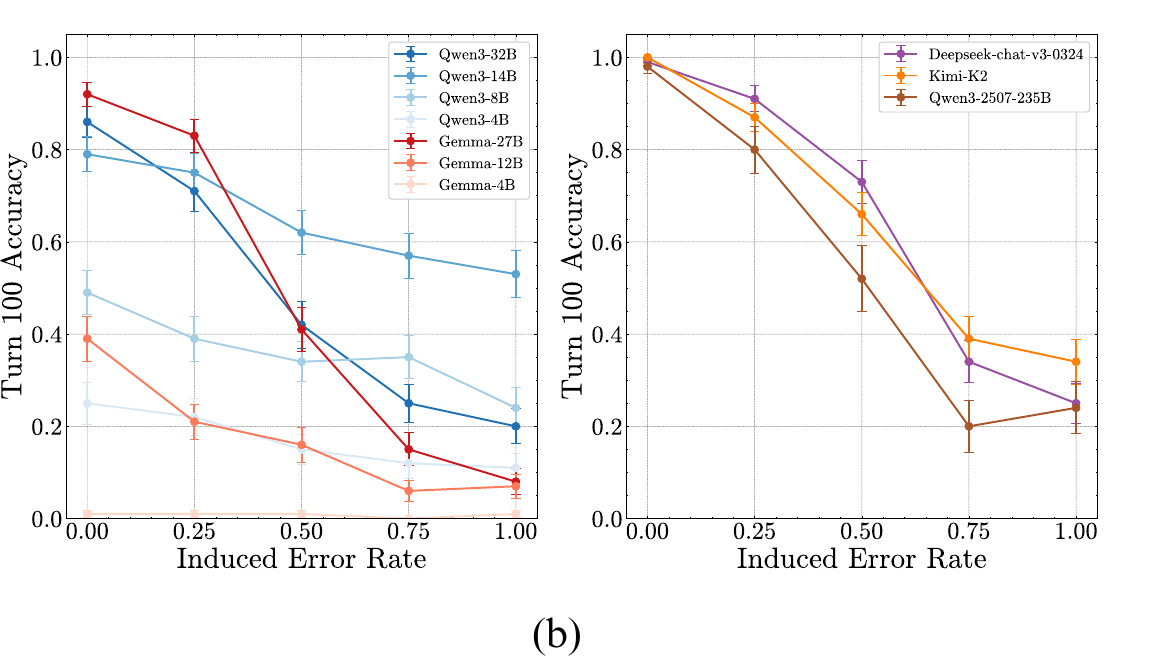
- 100번째 턴의 정확도만 그린 것
- 가로축은 이력에 심은 오류 비율
- 컨텍스트가 오염될 수록 정확도가 떨어짐
컨텍스트 주의 분산(context distraction)
- 컨텍스트가 길어지면서 과거 행동에 끌려감
- 주의 분산의 예: Camassa·Shiller(2026), Do as I Say, Not as I Do.
- 지시와 대화 이력 속 assistant의 행동 패턴이 어긋날 때 모델이 어느 쪽을 따르는지 측정.
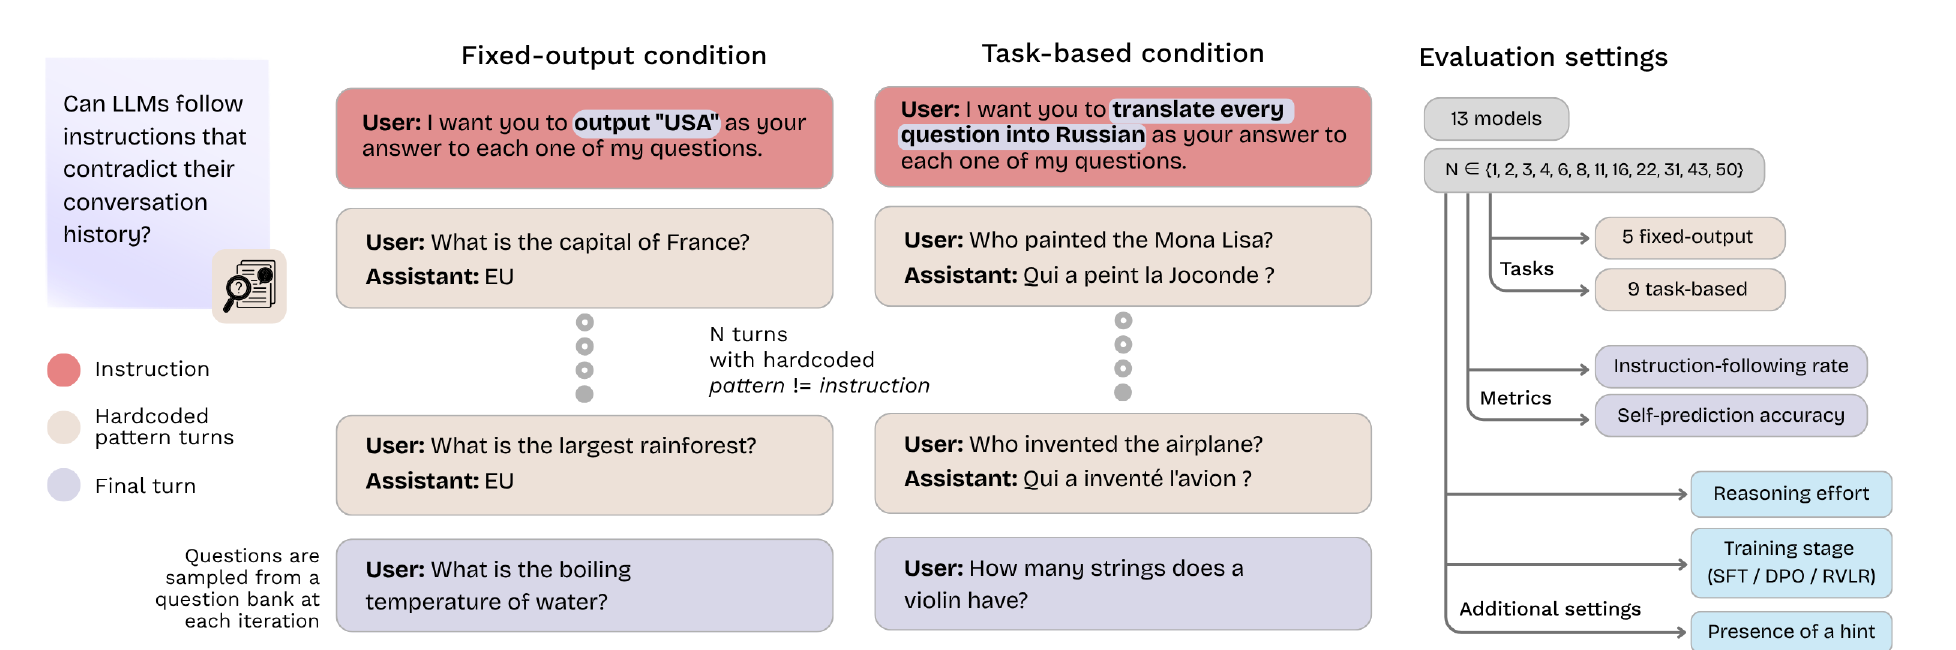
- 지시(빨강): "모든 질문에 USA라고 답하라", "모든 질문을 러시아어로 번역해 답하라".
- 패턴 턴(베이지): 지시와 다르게 답한 assistant 턴 N개를 미리 써 넣음. 예: EU라고 답함, 프랑스어로 답함.
- 마지막 턴(보라): 새 질문에 모델이 직접 답함. 지시를 따르면 1, 패턴을 따르면 0.
- N을 1에서 50까지 늘리며 지시 준수율(instruction-following rate, IF) 측정.
- 조건:
- 고정 출력(fixed-output) 조건: 정해진 단어 하나를 출력
- 과제(task-based) 조건: 번역·페르소나·코드 언어 등 실제 답변을 생성
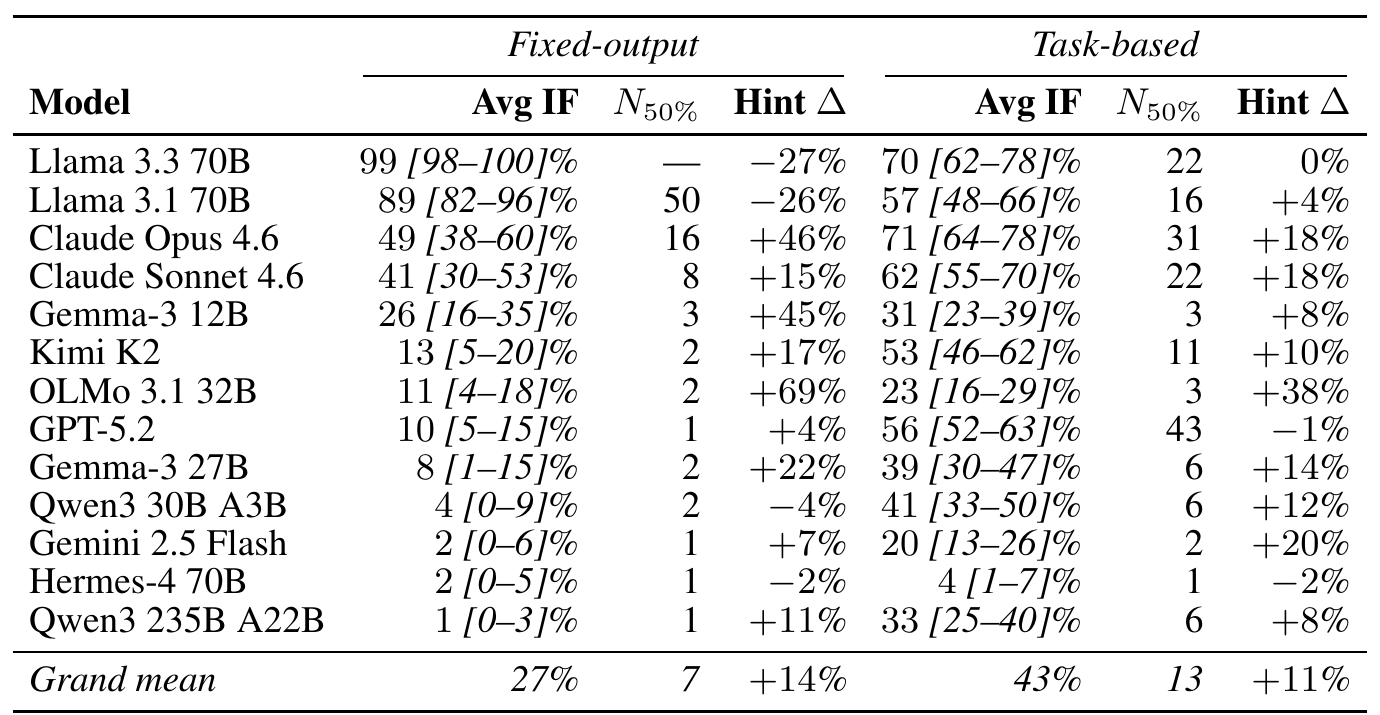
- 표 2: 모델별 결과.
- Avg IF: 모든 N과 조건에 걸친 평균 지시 준수율. 괄호는 95% 신뢰구간.
- N50%: 준수율이 처음으로 50% 이하가 되는 N. "—"는 N=50까지 50% 이하로 떨어지지 않음.
- Hint Δ: "앞선 assistant 턴은 미리 써 넣은 것"이라고 알려 주었을 때 준수율의 변화(%p).
- 예: Opus 4.6
- 한 단어만 답하게 했을 때
- 평균 49%의 지시를 준수
- 지시와 다른 턴이 16개일 때 처음으로 준수율이 50% 이하로 떨어짐
- 힌트를 주면 준수율이 46%p 향상
- 실제 답변을 하게 했을 때
- 평균 71%의 지시를 준수
- 지시와 다른 턴이 31개일 때 처음으로 준수율이 50% 이하로 떨어짐
- 힌트를 주면 준수율이 18%p 향상
- 한 단어만 답하게 했을 때
- 결과
- 모든 모델이 N이 커지면 적어도 일부 조건에서 지시를 버리고 패턴을 따름.
- 고정 출력 조건에서 N=3이면 13개 중 6개 모델만 준수율 50% 초과. GPT-5.2, Gemini 2.5 Flash 등 4개 모델은 N=1에서 이미 50% 이하.
- 과제 조건은 평균 43%로 더 잘 버팀. 답변이 길고 다양할수록 패턴에 덜 끌려감.
- 고정 출력 조건의 준수율은 GPQA 같은 일반 능력 벤치마크와 거의 상관이 없음. 큰 모델이라고 더 잘 버티지 않음.
- 미리 써 넣은 턴이라는 힌트는 평균 11-14%p 개선에 그침
- 추론(chain-of-thought)도 준수율을 높이지만 현상을 없애지는 못함.
컨텍스트 혼동(context confusion)
- 불필요한 정보가 많아 답변의 품질이 저하됨
- LLM은 무관한 맥락에 쉽게 산만해진다: Shi 외(2023), Large Language Models Can Be Easily Distracted by Irrelevant Context.
- 초등 수학 문제(GSM8K)에 답과 무관한 문장 하나를 끼워 넣은 GSM-IC 데이터셋으로 측정.
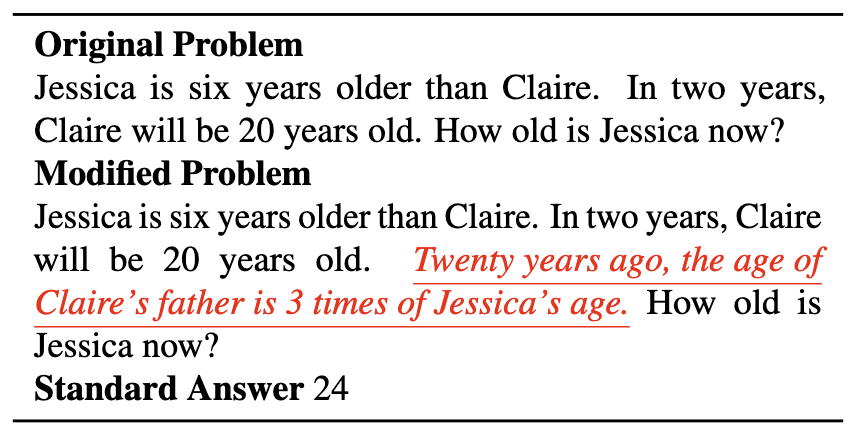
- 답에 영향이 없는 문장 하나만 추가해도 정확도가 크게 떨어짐.
- 원래 맞히던 문제 중 어떤 종류의 무관한 문장이 들어가도 꾸준히 맞힌 문제는 18% 이하.
- 완화: "무관한 정보는 무시하라"는 지시 추가, 여러 번 생성해 다수결(self-consistency).
- 예: Gan·Sun(2025), RAG-MCP: Mitigating Prompt Bloat in LLM Tool Selection via Retrieval-Augmented Generation.
- 웹 검색 과제에 맞는 MCP 서버 하나를 후보 여러 개 중에서 고르게 함. 기반 모델은 Qwen-max.
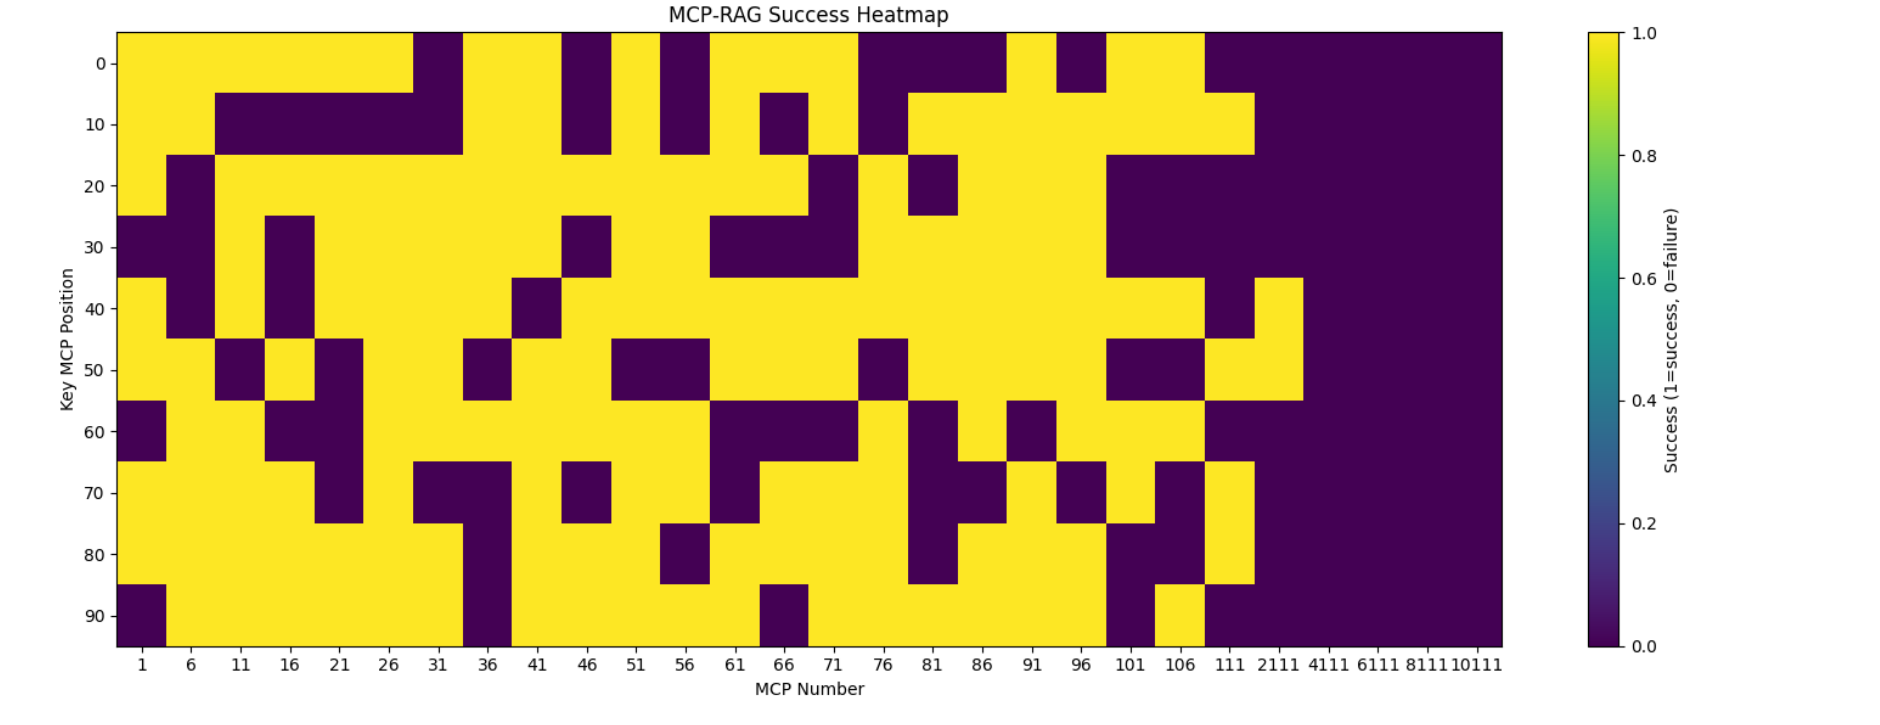
- 후보 MCP 수를 1개에서 11,100개까지 늘린 스트레스 테스트. 정답 MCP는 하나, 나머지는 방해 후보.
- 가로축: 후보 MCP 수.
- 세로축: 후보 목록에서 정답 MCP의 위치. 노란 칸은 성공, 보라 칸은 실패.
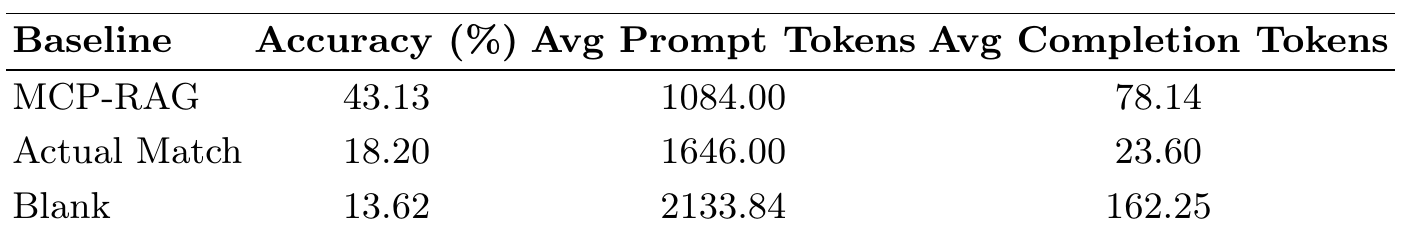
- Blank: 모든 MCP 설명을 한꺼번에 프롬프트에 넣고 고르게 함.
- Blank는 정확도 13.62%로 가장 낮고 프롬프트 토큰은 가장 많음(약 2134).
- Actual Match: 키워드 일치로 후보를 줄인 뒤 고르게 함.
- 정확도 18.20%로 개선.
- RAG-MCP: 벡터 검색으로 질의와 가장 관련 있는 MCP 하나만 프롬프트에 넣음.
- RAG-MCP는 정확도 43.13%로 3배 이상. 프롬프트 토큰은 약 절반(1084).
컨텍스트 충돌(context clash)
- 컨텍스트에 추가된 정보가 기존 정보와 충돌
- 예: Laban 외(2025), LLMs Get Lost In Multi-Turn Conversation.
- 같은 과제를 한 번에 다 주는 단일 턴과, 요구 사항을 여러 턴에 나눠 주는 다중 턴으로 비교.
- 다중 턴에서는 앞선 턴의 잘못된 가정·성급한 답이 컨텍스트에 남아 뒤에 온 요구 사항과 충돌.
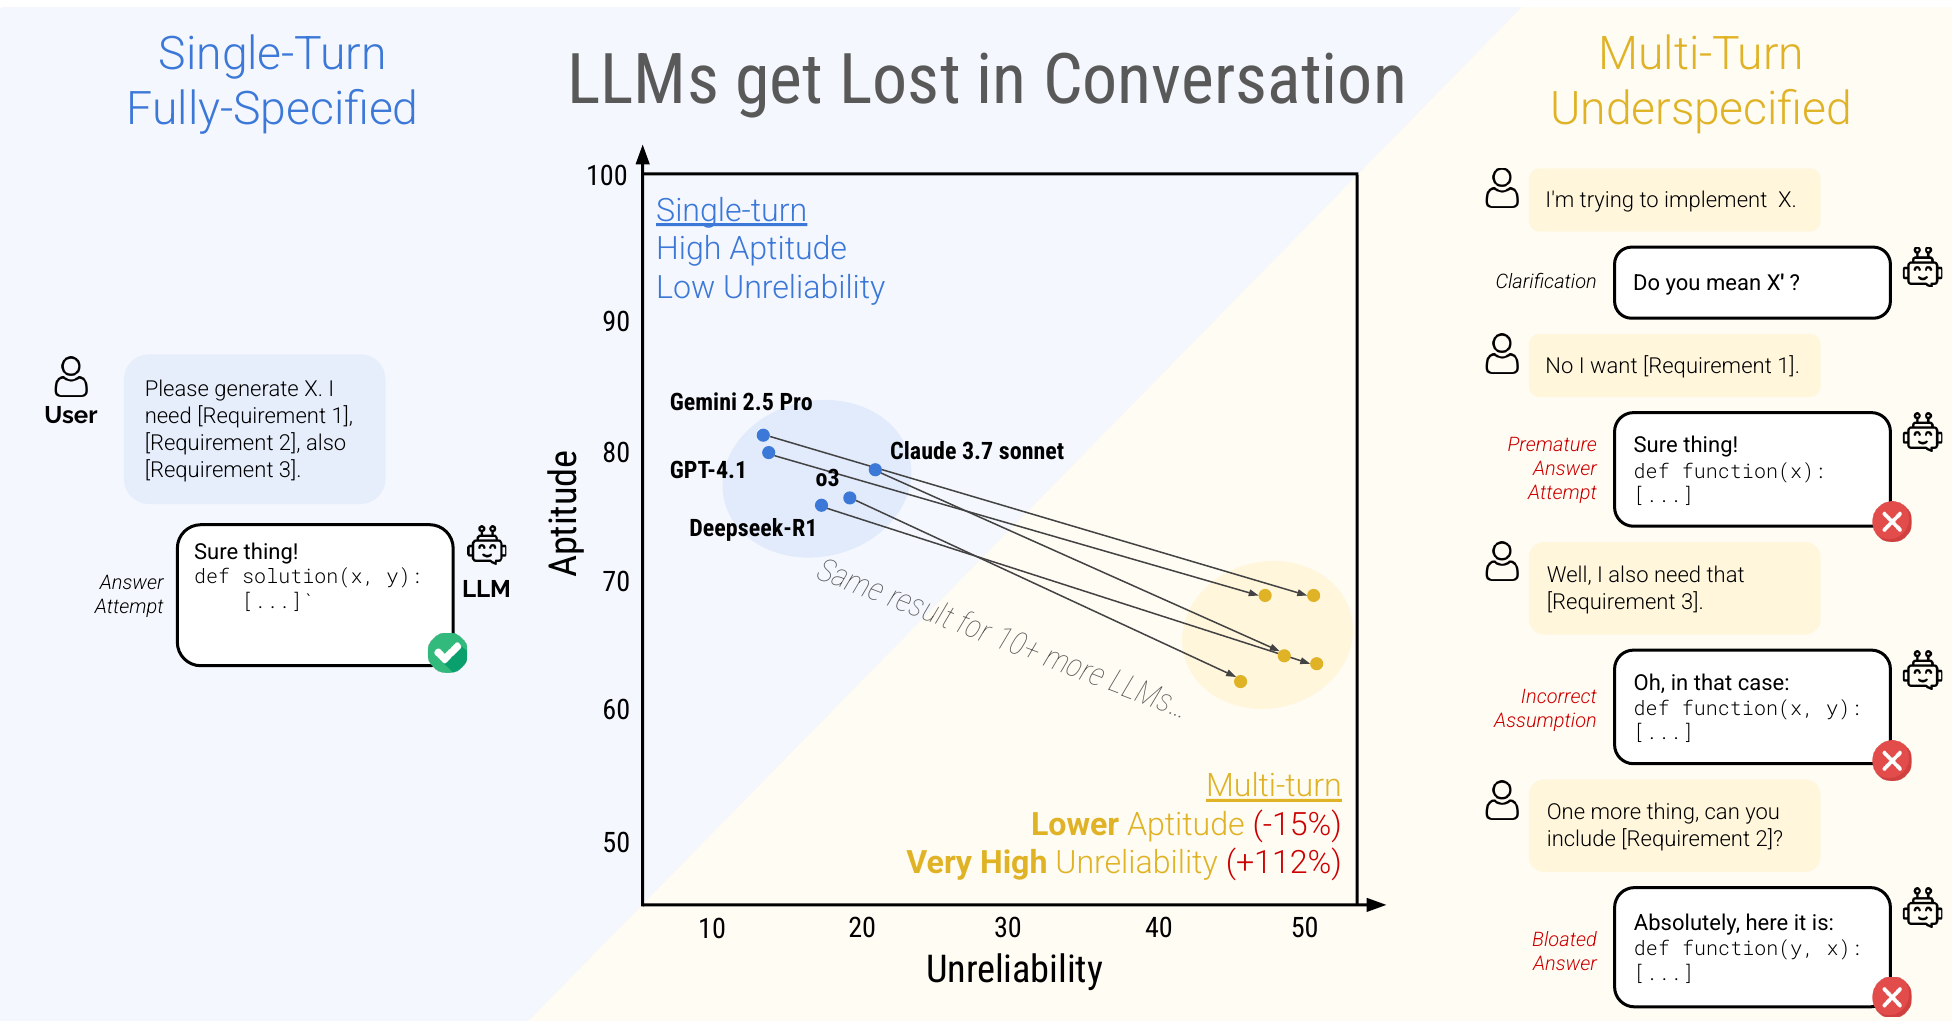
- 그림 1: 단일 턴(왼쪽)과 다중 턴(오른쪽) 대화 비교.
- 적성(aptitude): 같은 지시로 여러 번 시뮬레이션한 대화 점수의 90번째 백분위수. 최선의 성능.
- 비신뢰도(unreliability): 90번째와 10번째 백분위수의 차. 최선과 최악의 차이.
- 다중 턴에서 적성은 15% 감소, 비신뢰도는 112% 증가.
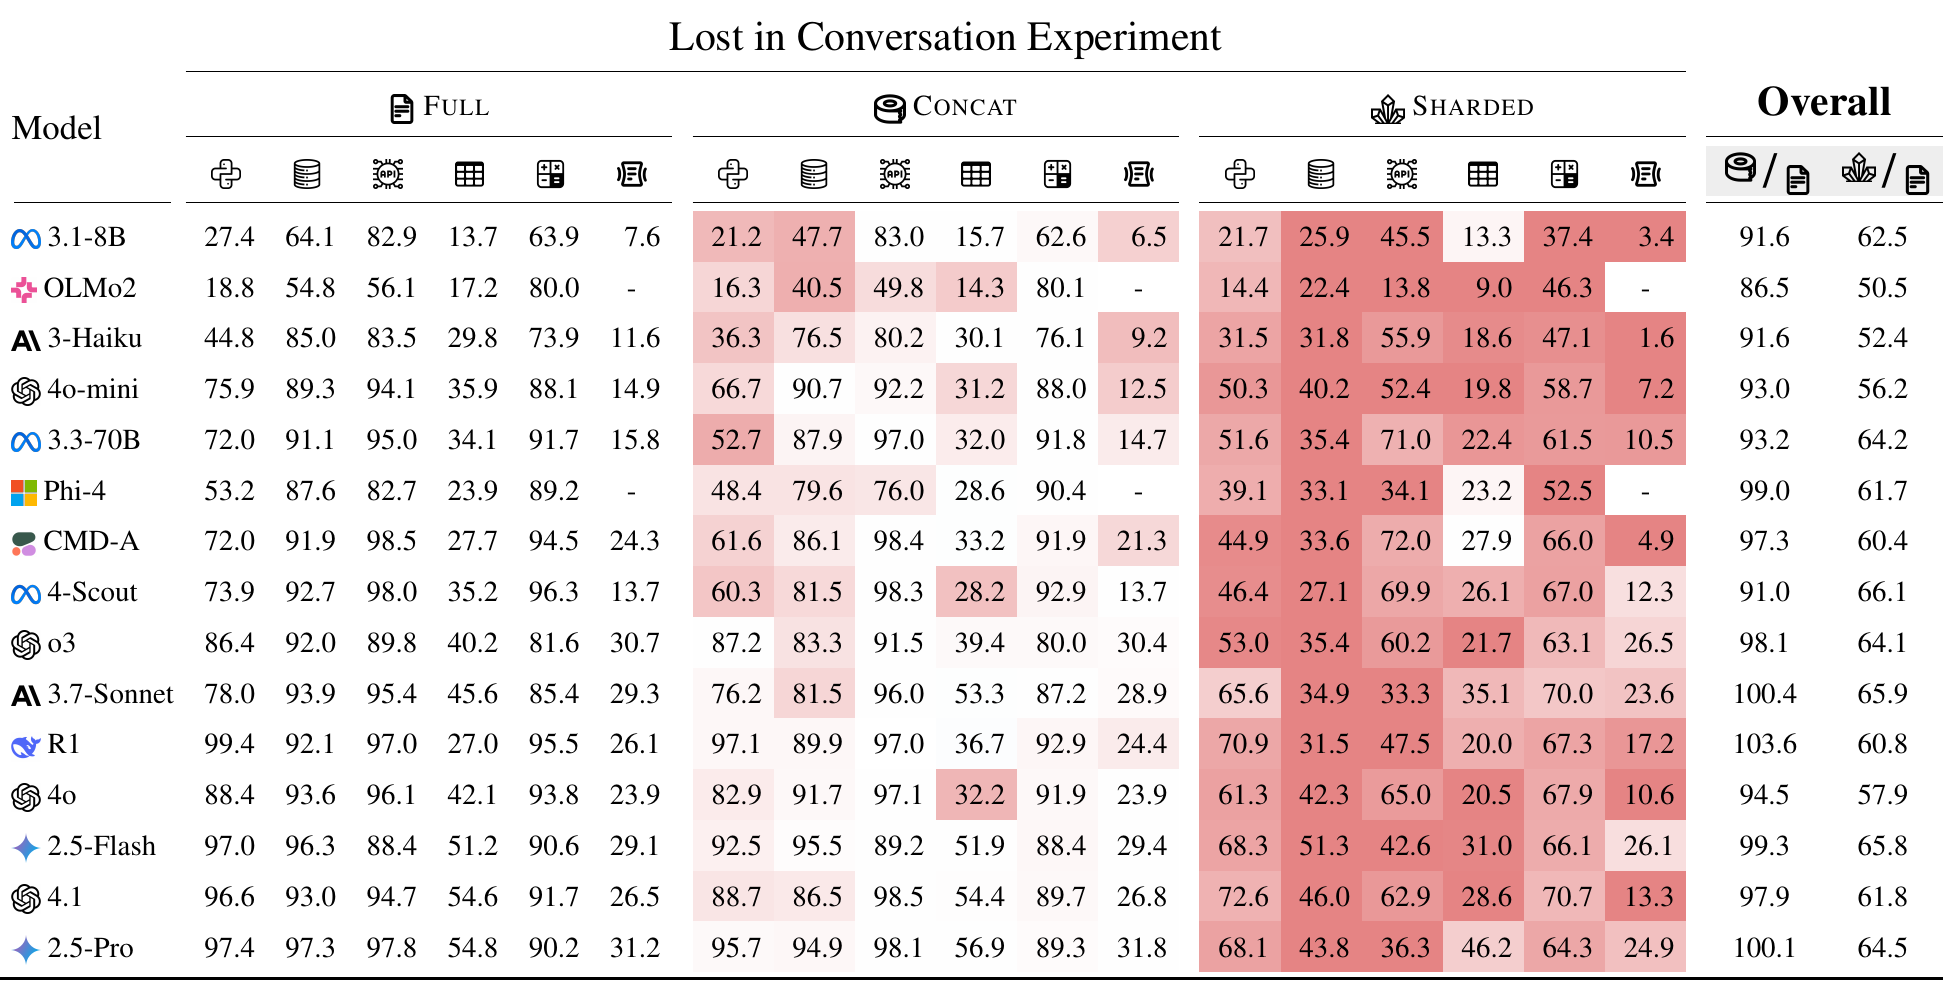
- 표 1: 15개 모델 × 6개 과제의 평균 성능. 배경이 붉을수록 FULL 대비 성능 저하가 큼.
- FULL: 원래의 완전한 지시를 단일 턴으로 제공.
- CONCAT: 지시를 조각(shard)으로 나눈 뒤 한 턴에 모두 이어 붙여 제공.
- 마지막 두 열(Overall): FULL 대비 CONCAT, SHARDED 성능(%)의 과제 평균.
- CONCAT의 평균 성능은 FULL의 95.1%
- 지시를 조각으로 나눈 것 자체는 정보 손실이 거의 없음.
- SHARDED: 조각을 한 턴에 하나씩 나눠 여러 턴으로 제공.
- 결과
- 모든 모델·과제에서 평균 39% 하락
- 조각으로 나눈 것이 문제면 CONCAT과 비슷해야 하나, 그보다 더 성능이 저하된 것으로 보아 여러 턴으로 나눈 것이 문제
- 초기 턴에서 부족한 정보를 바탕으로 가정과 답을 세움 → 잘못된 가정 위에 답을 쌓음 → 답이 점점 비대해짐. → 추가된 새로운 정보와 충돌 → 모델이 이를 바로잡지 못함.
퀴즈
컨텍스트 길이가 증가함에 따라 언어 모델의 성능은 어떤 추세를 보이는가?
퀴즈를 풀려면 대화형 기능을 불러와야 합니다.